<?xml version="1.0" encoding="utf-8"?>
<?xml-stylesheet type="text/xsl" href="/atom.xsl"?>
<feed xmlns="http://www.w3.org/2005/Atom">
  <author>
    <name>R6bandito</name>
  </author>
  <generator uri="https://hexo.io/">Hexo</generator>
  <icon>https://r6blog.online/img/logo.svg</icon>
  <id>https://r6blog.online/</id>
  <link href="https://r6blog.online/" rel="alternate"/>
  <link href="https://r6blog.online/atom.xml" rel="self"/>
  <rights>All rights reserved 2026, R6bandito</rights>
  <title>R6bandito 的笔记</title>
  <updated>2026-10-08T07:15:10.251Z</updated>
  <entry>
    <author>
      <name>R6bandito</name>
    </author>
    <category term="网络通信" scheme="https://r6blog.online/categories/%E7%BD%91%E7%BB%9C%E9%80%9A%E4%BF%A1/"/>
    <category term="LwIP" scheme="https://r6blog.online/tags/LwIP/"/>
    <category term="TCP/IP" scheme="https://r6blog.online/tags/TCP-IP/"/>
    <content>
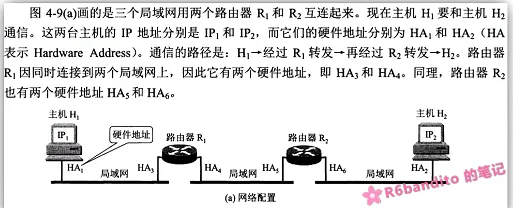
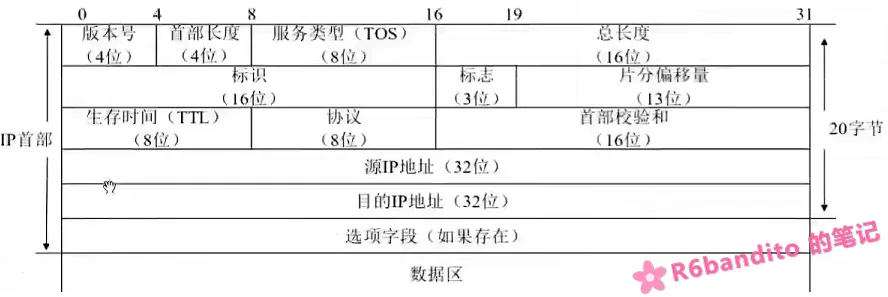
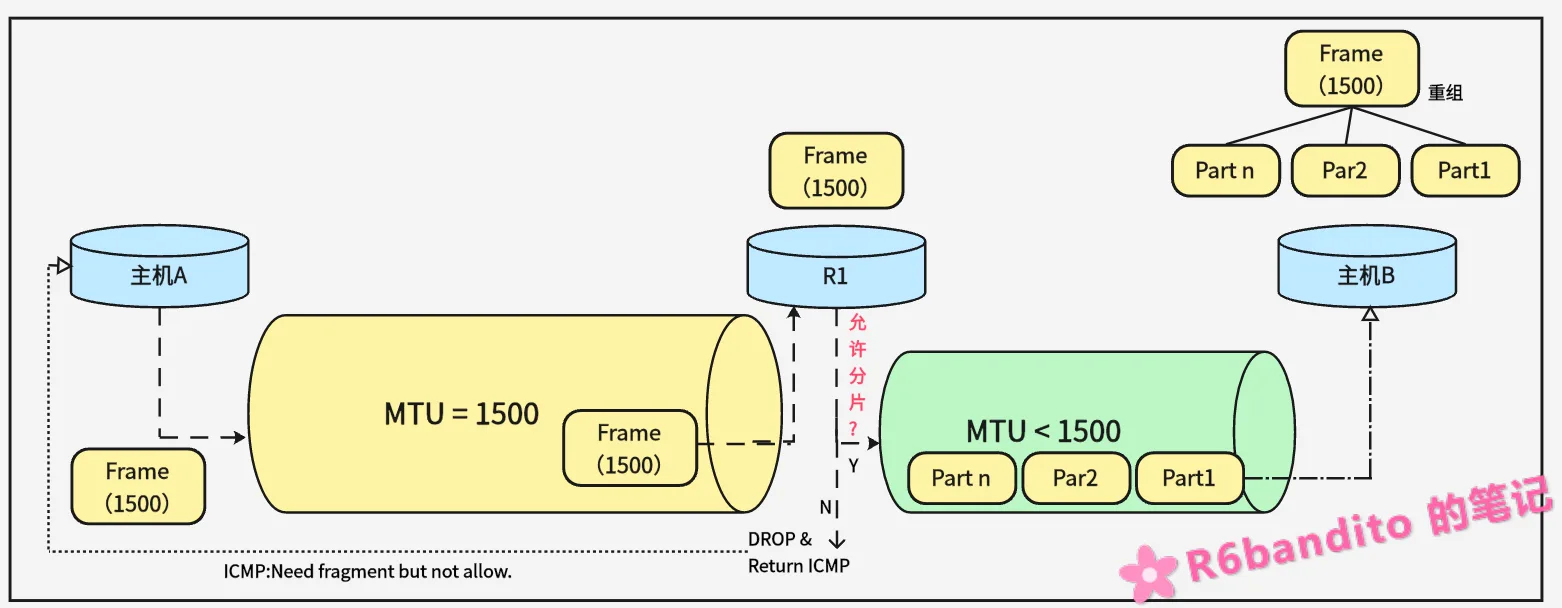
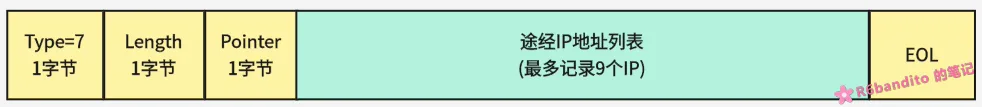
      <![CDATA[<h4 id="前言"><a href="#前言" class="headerlink" title="前言"></a>前言</h4><p>前面已经梳理了同处于网络层的<a href="/2026/09/19/%E5%B5%8C%E5%85%A5%E5%BC%8F2026091902/" title="ARP 地址解析协议">ARP地址解析协议</a>和<a href="/2026/09/28/%E5%B5%8C%E5%85%A5%E5%BC%8F2026092801/" title="ICMP Internet控制报文协议">ICMP控制报文协议</a>。这些协议都是为了辅助网络层最核心的IP协议而诞生的。网络层的IP协议可以说是整个TCP&#x2F;IP协议栈的“半壁江山”，是构建起互联网环境的重要一环。</p><h4 id="什么是IP协议"><a href="#什么是IP协议" class="headerlink" title="什么是IP协议"></a>什么是IP协议</h4><p>IP协议又叫作网际协议，<strong>核心定位是负责将网络数据包从源主机端尽可能的运送到目标主机端</strong>。IP协议有一个很特殊的地方：位于网络层上接TCP&#x2F;UDP等高层协议，下接Ethernet等底层通信链路，这就体现了IP协议一个很重要的作用——<strong>屏蔽底层不同链路的实现差异，为协议上层及应用层提供统一的标准接口</strong>。</p><p>需要知道，网络底层链路不只有Ethernet以太网一种，老式的PPP拨号上网、Wi-Fi、移动网络(4G&#x2F;5G)等等这些都是不同的底层链路协议，而不同协议之间根据适用场景不同往往差距是比较大的。如果没有IP协议，那么上层需要为每一个网络链路定制一套自身的逻辑，类似于这种：</p><blockquote><p>HTTP on Wi-Fi.</p><p>HTTP on Ethernet.</p><p>HTTP on 4G&#x2F;5G.</p><p>….</p></blockquote><p>这显然不规范，而且没有统一标准各自实现起来十分复杂。</p><p>而IP协议正好解决了这个问题：IP协议通过IP地址统一了整个自网络层之上的行为，上层在发送数据包时并不需要关心自己底层处于什么网络链路，只需要将包交给协议栈就行；协议栈规定了统一的数据帧格式，不管底层处于什么链路，怎么去路由，反正帧格式是定死了的，拆掉外壳，里面永远是同一个IP数据报。</p><hr><h4 id="IP协议特点"><a href="#IP协议特点" class="headerlink" title="IP协议特点"></a>IP协议特点</h4><p>IP协议是<strong>无连接不可靠</strong>的，发送端随时可以发送数据，接收端也随时可能接收到数据。不管是数据的发送还是接收，每一个数据包都必须带有独立的IP头以及IP地址信息。IP协议不保证数据能够正确送达对端，出错之后尽可能返回ICMP控制报文由上层来决定下一步；就算送达了也不保证顺序。</p><p>这里要强调一点：一定要正确区分IP地址和MAC地址的行为。IP地址用于在网络环境中逻辑定位通信双方，是跨网段寻址的依据，而MAC地址是底层网络链路中路由数据包的依据。下面以一个例子来讲讲IP与MAC的工作流程：</p><p><img src="/2026/10/06/嵌入式2026100601/2026100601_2.webp"></p><p>两个路由器都连接到多个网段，因此网卡接口也有多个（一个接口一个MAC地址）。</p><ul><li>主机H1在发送网络数据包之前发现对方H2并不处于同一网段，因此将数据包发往路由器R1。此时整个数据包源IP为IP1，目的IP为IP2。其源MAC为HA1，目标MAC为HA3。</li><li>数据包到达路由器R1，被R1通过接口HA4发送给路由器R2。此时源、目的IP不变，源MAC变为HA4，目的MAC变为HA5。</li><li>数据包到达路由器R2，R2发现目标设备在HA6接口管理的网段内，通过HA6接口将该包发到目标设备。此时源、目的IP依然不变，源MAC为HA6，目标MAC为HA2。</li></ul><p>发现了吗？在本次跨网段的通信示例中，源IP和目标IP地址是不会发生变化的，原因在于IP地址作为“路标”，要指引数据路由方向；而MAC地址则是根据路由方向在两个直连设备之间实现通信，而每个设备接口都是有差异的，因此MAC地址在本次通信中是时刻变化的，用于在物理上真真实实将数据路由到指定下一跳位置。</p><blockquote><p>另外，这里还得附注一下：</p><p>IP地址并不是全球唯一的，这里要注意，IP协议划分出了3类私有网段地址，这些地址在全球这么多网段中是肯定有重复的。</p><p>但是私有地址是局域网段内部使用的，无法直接连接公网。如果需要连接公网那么得走公网IP+NAT映射。更多详见<a href="/2026/09/14/%E5%B5%8C%E5%85%A5%E5%BC%8F2026091402/" title="IP 地址体系(IPv4)">IP地址体系</a>、<a href="/2026/09/14/%E5%B5%8C%E5%85%A5%E5%BC%8F2026091401/" title="NAT 地址转换">NAT地址转换</a></p></blockquote><hr><h4 id="IP协议帧格式"><a href="#IP协议帧格式" class="headerlink" title="IP协议帧格式"></a>IP协议帧格式</h4><p>认识一个协议，首先肯定得从协议报文格式入手。IP协议标准头部最少有20字节大小（大部分情况下都是20字节），这20字节携带了必要的通信讯息，如果还有剩余的字节，则为选项字段带一些额外通信参数。</p><img src="/2026/10/06/嵌入式2026100601/2026100601_1.webp" style="zoom:80%;" /><table><thead><tr><th align="left">字段</th><th align="left">长度</th><th align="left">含义</th></tr></thead><tbody><tr><td align="left"><strong>版本号</strong></td><td align="left">4 位</td><td align="left">IPv4 &#x3D; 4，IPv6 &#x3D; 6</td></tr><tr><td align="left"><strong>首部长度</strong></td><td align="left">4 位</td><td align="left">以 4 字节为单位，最小 5（20 字节），最大 15（60 字节）</td></tr><tr><td align="left"><strong>服务类型（TOS）</strong></td><td align="left">8 位</td><td align="left">优先级 + 延迟&#x2F;吞吐&#x2F;可靠性标志（现多用于 DSCP）(看看就行，一般用不上)</td></tr><tr><td align="left"><strong>总长度</strong></td><td align="left">16 位</td><td align="left">首部 + 数据，最大 65535</td></tr><tr><td align="left"><strong>标识</strong></td><td align="left">16 位</td><td align="left">分片时用于重组，同一数据报的分片共享此 ID</td></tr><tr><td align="left"><strong>标志</strong></td><td align="left">3 位</td><td align="left">DF（不分片）、MF（还有分片）、保留位</td></tr><tr><td align="left"><strong>分片偏移</strong></td><td align="left">13 位</td><td align="left">本分片在原始数据报中的位置，以 8 字节为单位，同样用于重组</td></tr><tr><td align="left"><strong>生存时间（TTL）</strong></td><td align="left">8 位</td><td align="left">每经一跳减 1，为 0 时丢弃并回 ICMP 超时</td></tr><tr><td align="left"><strong>协议</strong></td><td align="left">8 位</td><td align="left">上层协议：1&#x3D;ICMP，6&#x3D;TCP，17&#x3D;UDP</td></tr><tr><td align="left"><strong>首部校验和</strong></td><td align="left">16 位</td><td align="left">只校验首部，不校验数据</td></tr><tr><td align="left"><strong>源 IP</strong></td><td align="left">32 位</td><td align="left">发送方 IP</td></tr><tr><td align="left"><strong>目标 IP</strong></td><td align="left">32 位</td><td align="left">接收方 IP</td></tr><tr><td align="left"><strong>选项</strong></td><td align="left">最多40字节</td><td align="left">记录路由、时间戳、源路由等（很少用）</td></tr></tbody></table><p>至于后面的数据部分，负责承载ICMP&#x2F;UDP&#x2F;TCP报文头部及其数据、以及应用层的数据。</p><hr><h4 id="IP分片与重组"><a href="#IP分片与重组" class="headerlink" title="IP分片与重组"></a>IP分片与重组</h4><p>上文我们提到了，IP统一了自网络层之上的内容。但是底层的数据链路层，其实现是各异的。一次跨网段的网络通信底层可能会经过多个不同的物理链路，而每个物理链路都维护有自己的MTU(最大传输单元)表示在该链路层中最大的传输帧长度。例如以太网MTU的典型值就是1500。</p><p>这就会导致出现一个问题：假如我们本地网段为以太网，MTU为1500。为了最大化提升效率，我们按照这个数字发包，结果网络包在中间某一跳时，进入了另一类型链路层，通道MTU &lt; 1500了，这时候怎么办？</p><p>IP的分片与重组功能就是专门设计出来解决这个问题的——可以将数据包拆开分段传输过去，再由对端正确重组得到完整数据；上述情况中，这个时候中间路由器在传输时就可能会触发IP分片。</p><p>为什么说是可能？因为IP分片与重组是可选功能。必须满足以下条件才会触发分片和重组机制：</p><ul><li><strong>接收方&#x2F;发送方均开启IP分片重组功能</strong>，否则要不就一个发不出，要不就是收到不会重组。</li><li><strong>数据包IP头标志位必须设置可分片</strong>。若不允许分片则直接被丢弃。</li><li><strong>传输时IP数据报总长(IP头+数据) &gt; 当前传输链路MTU</strong>。</li></ul><img src="/2026/10/06/嵌入式2026100601/2026100601_3.webp" style="zoom:80%;" /><p>上述示意图便是在中间路由器R1分片触发的场景，若允许分片，则进行切片与对端重组；若不允许则回复ICMP报文（类型3Code4）。</p><p>当然，要注意的是并不只有中间路由器会触发分片的情况，在源主机有时也会触发分片：比如Ethernet MTU&#x3D;1500，我们从应用层向IP协议栈递交了一个大于1500字节的数据报，这个时候若我们开启了分片功能，那么在IP层就会主动将其分片发出。</p><p>这里讲讲分片重组的一些细节操作：</p><p>分片和重组都涉及到IP头部的几个关键字段：<strong>标识、标志、分片偏移、以及总长度</strong>。</p><p>我们以在Ethernet环境下一次性发送4000字节数据(此处演示源主机处分片)，并且对端重组并正确接收4000字节数据为例：</p><ul><li><p>在发送数据包前，协议栈会检查总长度是否大于出口网络接口的MTU，如果总长度&lt;MTU则直接发送；若总长度&gt;MTU，则进行下一步。</p></li><li><p>检查协议栈是否允许分片，若不允许分片则直接拒绝该次请求，并返回对应的错误给上层；若允许分片，则计算需要分为多少片。</p></li><li><p>本示例要发送4000字节数据，每个分片最大承载的数据量为：1500 - 20(标准IP头部，无选项字节) &#x3D; 1480字节。简单运算下可以得到总共需要分为三片：<br>分片1：IP头20字节 + 1480字节数据；分片偏移0、MF &#x3D; 1（后面还有分片）</p><p>分片2：IP头20字节 + 1480字节数据；分片偏移185（注意，8字节为单位）、MF &#x3D; 1（还有分片）<br>分片3：IP头20字节 + 1040字节数据；分片偏移370、MF &#x3D; 0（后面没有分片了）</p></li><li><p>分片完毕，几个分片包的标识被打上相同ID表示都属于同一个大包，然后逐个以计算出的值填充每个分片的IP头后，依次发出。</p></li></ul><p>这就是发送方IP分片的流程。这里有一个地方要注意：因为分片偏移以8字节为单位，<strong>所以除开最后一包数据以外，其它中间的包数据必须能够整除8字节</strong>。这通常由协议栈内部进行管理，我们无需干涉。例如将MTU设置为1499，1499 - 20 &#x3D; 1479 是无法整除8的。这个时候协议栈内部会退到1472，然后剩下的数据丢给下一包。</p><p>接收方收到分片数据后：</p><ul><li>根据标识 + 源 IP + 目标 IP + 协议号将同一个大包的分片归为一类，并从中找出首片。</li><li>而后根据分片偏移将所有分片进行排序。</li><li>当所有分片收齐后(收到MF &#x3D; 0的包)，脱掉每个分片的IP头，然后按排序进行拼接。</li><li>拼好后将完整数据报递交给上层。</li></ul><p>我们在Linux中使用ICMP报文来实际看看该示例的情况：</p><figure class="highlight bash"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br></pre></td><td class="code"><pre><code class="hljs bash"><span class="hljs-comment">#终端1</span><br><span class="hljs-built_in">sudo</span> ip <span class="hljs-built_in">link</span> <span class="hljs-built_in">set</span> eth0 mtu 1499  <span class="hljs-comment">#设置MTU为1499.</span><br>ping -M dont -c 1 -s 4000 172.18.224.1  <span class="hljs-comment">#Ping一次网关，数据大小为4000字节，允许分片</span><br><br><span class="hljs-comment">#终端2</span><br><span class="hljs-built_in">sudo</span> tshark -i eth0 icmp<br></code></pre></td></tr></table></figure><p>运行后各终端情况如下：</p><figure class="highlight bash"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br></pre></td><td class="code"><pre><code class="hljs bash"><span class="hljs-comment">#终端1</span><br>PING 172.18.224.1 (172.18.224.1) 4000(4028) bytes of data.<br>4008 bytes from 172.18.224.1: icmp_seq=1 ttl=128 <span class="hljs-keyword">time</span>=0.359 ms<br><br><span class="hljs-comment">#终端2</span><br>172.18.228.235 → 172.18.224.1 IPv4 1506 Fragmented IP protocol (proto=ICMP 1, off=0, ID=4237)<br>172.18.228.235 → 172.18.224.1 IPv4 1506 Fragmented IP protocol (proto=ICMP 1, off=1472, ID=4237)<br>172.18.228.235 → 172.18.224.1 ICMP 1098 Echo (ping) request  <span class="hljs-built_in">id</span>=0x6940, <span class="hljs-built_in">seq</span>=1/256, ttl=64<br>172.18.224.1 → 172.18.228.235 IPv4 1514 Fragmented IP protocol (proto=ICMP 1, off=0, ID=126b)<br>172.18.224.1 → 172.18.228.235 IPv4 1514 Fragmented IP protocol (proto=ICMP 1, off=1480, ID=126b)<br>172.18.224.1 → 172.18.228.235 ICMP 1082 Echo (ping) reply    <span class="hljs-built_in">id</span>=0x6940, <span class="hljs-built_in">seq</span>=1/256, ttl=128 (request <span class="hljs-keyword">in</span> 3)<br></code></pre></td></tr></table></figure><p>可以看到，MTU&#x3D;1499的情况下，我们4008字节（ICMP头部还要占8字节）数据被分为了三片，前两片数据负载均为1472(1479不可用，协议栈自动退回1472)。第三片总大小为1098，减去MAC14字节再减去20字节IP头部，最后IP数据负载为1064字节。1064 + 1472 * 2 &#x3D; 4008字节，验算通过。</p><p>但是在实际网络环境中，其实都会尽量去避免使用分片功能。因为一段分片数据中，只要丢一个分片，那么所有分片都必须重传。而且将一段数据拆成多段发送，本身就加大了路由出错的风险，同时也增加设备负担。所以这也是为什么会有PMTUD技术，就是为了保证在正确路由到对端的整个环境中，我该发多大的包以至于不会在中间路径触发分片。</p><hr><h4 id="其它"><a href="#其它" class="headerlink" title="其它"></a>其它</h4><h5 id="关于选项字段"><a href="#关于选项字段" class="headerlink" title="关于选项字段"></a>关于选项字段</h5><p>IP头部最多60字节，扣除掉20字节的固定标准头部，剩下40字节作为选项插入。选项字节部分是可变的，最大40字节，且必须满足4字节对齐（不满足将使用填充字节进行补齐）。</p><p>这40字节内部维护了一个类似于K-V(键值对应)的机制：也就是说IP选项的格式如下面所示</p><figure class="highlight plaintext"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br></pre></td><td class="code"><pre><code class="hljs plaintext">┌────────┬────────┬──────────────────┐<br>│Type   │Length   │    Value       |<br>│1 字节  │1 字节   │ Length-2 字节  |<br>└────────┴────────┴──────────────────┘<br></code></pre></td></tr></table></figure><ul><li><strong>Type</strong>：选项类型，比如源路由、记录路由路径等。</li><li><strong>Length</strong>：选项总长度。</li><li><strong>Value</strong>：选项的数据部分。</li></ul><p>其中，<strong>Type</strong>的8位又被划分如下：</p><figure class="highlight plaintext"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br></pre></td><td class="code"><pre><code class="hljs plaintext">  0   1   2   3   4   5   6   7<br>┌───┬───┬───────────────────────┐<br>│ C │ C │      Number        │<br>└───┴───┴───────────────────────┘<br>  ↑   ↑<br> 复制标志  选项类别<br></code></pre></td></tr></table></figure><ul><li>复制标志（Copied）占一位，表征是否将该选项字段复制到所有IP分片（若有分片的情况下）。0表示不复制，只有首片具有该选项；1表示复制，每个分片都有。</li><li>类别占两位，0&#x3D;控制；1&#x3D;保留；2&#x3D;调试和测量；3&#x3D;保留。</li><li>后面的Number编号就是具体的选项类别了(没用，了解一下)。</li></ul><p>你比如：<br>严格源路由：Type &#x3D; 137，类别是0（控制）</p><p>路径记录：Type &#x3D; 7，类别是0（控制）</p><p>这里有两个特殊的单字节类型选项要注意：<strong>NOP、EOL</strong>。这两个作为选项但是没有常规控制头的<code>Length</code>和<code>Value</code>部分。NOP用于填补占位（前面说过选项要对齐到4字节，若未对齐就用NOP进行填补对齐）、EOL用于表征选项字段结束。</p><p>这里以一个路径记录的选项例子来看看实际的布局是什么样的：</p><img src="/2026/10/06/嵌入式2026100601/2026100601_4.webp" style="zoom:80%;" /><p>路径记录其实就是traceroute，每一个中间路由器都将自己的IP写进Pointer指向的位置，最多记录9跳内容。但是当今互联网发展很多时候通信跳数大于9跳，所以这个功能基本不会使用。</p><p>IP选项需要额外解析，降低数据流通速度；而且存在一定的安全风险；同时功能也比较鸡肋。因此在当前的互联网环境中基本上不会被使用，很多协议栈默认设置是关闭IP选项字段功能的。这里只简单讲讲，不深入讨论。</p><hr><h5 id="关于TTL"><a href="#关于TTL" class="headerlink" title="关于TTL"></a>关于TTL</h5><p>TTL是网络数据包在网络环境中的存活时间。因为占1个字节，所以最大值为255。其典型值为64或255。需要注意的是这里的时间指的<strong>并不是我们常识中的分秒这一类时间，而是数据包在路由路径上经过的跳数</strong>。</p><p>数据包每经过一个中间路由器，TTL都会减少1，当TTL减到0时该包被丢弃。我们在Traceroute中依靠的原理就是TTL超时对端发回ICMP。</p><p>之所以要引入TTL，是为了防止失效数据包在网络环境中不断循环被转发。有了TTL，包最多经过255跳就会被丢弃，不会永久占用网络资源。</p><hr><h4 id="END"><a href="#END" class="headerlink" title="END"></a>END</h4><p>IP协议是网络层的核心，把数据包从源送到目标。不保证可靠、不保证顺序，这些交给上层。IP头的20字节里，每一个字段都有明确分工：版本、长度、分片、TTL、协议、校验和、源&#x2F;目标 IP。分片是IP应对MTU差异的手段，但代价高，现代网络尽量用PMTUD技术来避免分片。IP选项是补充机制，几乎废弃。</p>]]>
    </content>
    <id>https://r6blog.online/2026/10/06/%E5%B5%8C%E5%85%A5%E5%BC%8F2026100601/</id>
    <link href="https://r6blog.online/2026/10/06/%E5%B5%8C%E5%85%A5%E5%BC%8F2026100601/"/>
    <published>2026-10-06T07:01:51.000Z</published>
    <summary>
      <![CDATA[<h4 id="前言"><a href="#前言" class="headerlink" title="前言"></a>前言</h4><p>前面已经梳理了同处于网络层的<a href="/2026/09/19/%E5%B5%8C%E5%85%A5%E5%BC%8F20260919]]>
    </summary>
    <title>IP 协议</title>
    <updated>2026-10-08T07:15:10.251Z</updated>
  </entry>
  <entry>
    <author>
      <name>R6bandito</name>
    </author>
    <category term="日本語勉強する" scheme="https://r6blog.online/categories/%E6%97%A5%E6%9C%AC%E8%AA%9E%E5%8B%89%E5%BC%B7%E3%81%99%E3%82%8B/"/>
    <category term="日本語" scheme="https://r6blog.online/tags/%E6%97%A5%E6%9C%AC%E8%AA%9E/"/>
    <content>
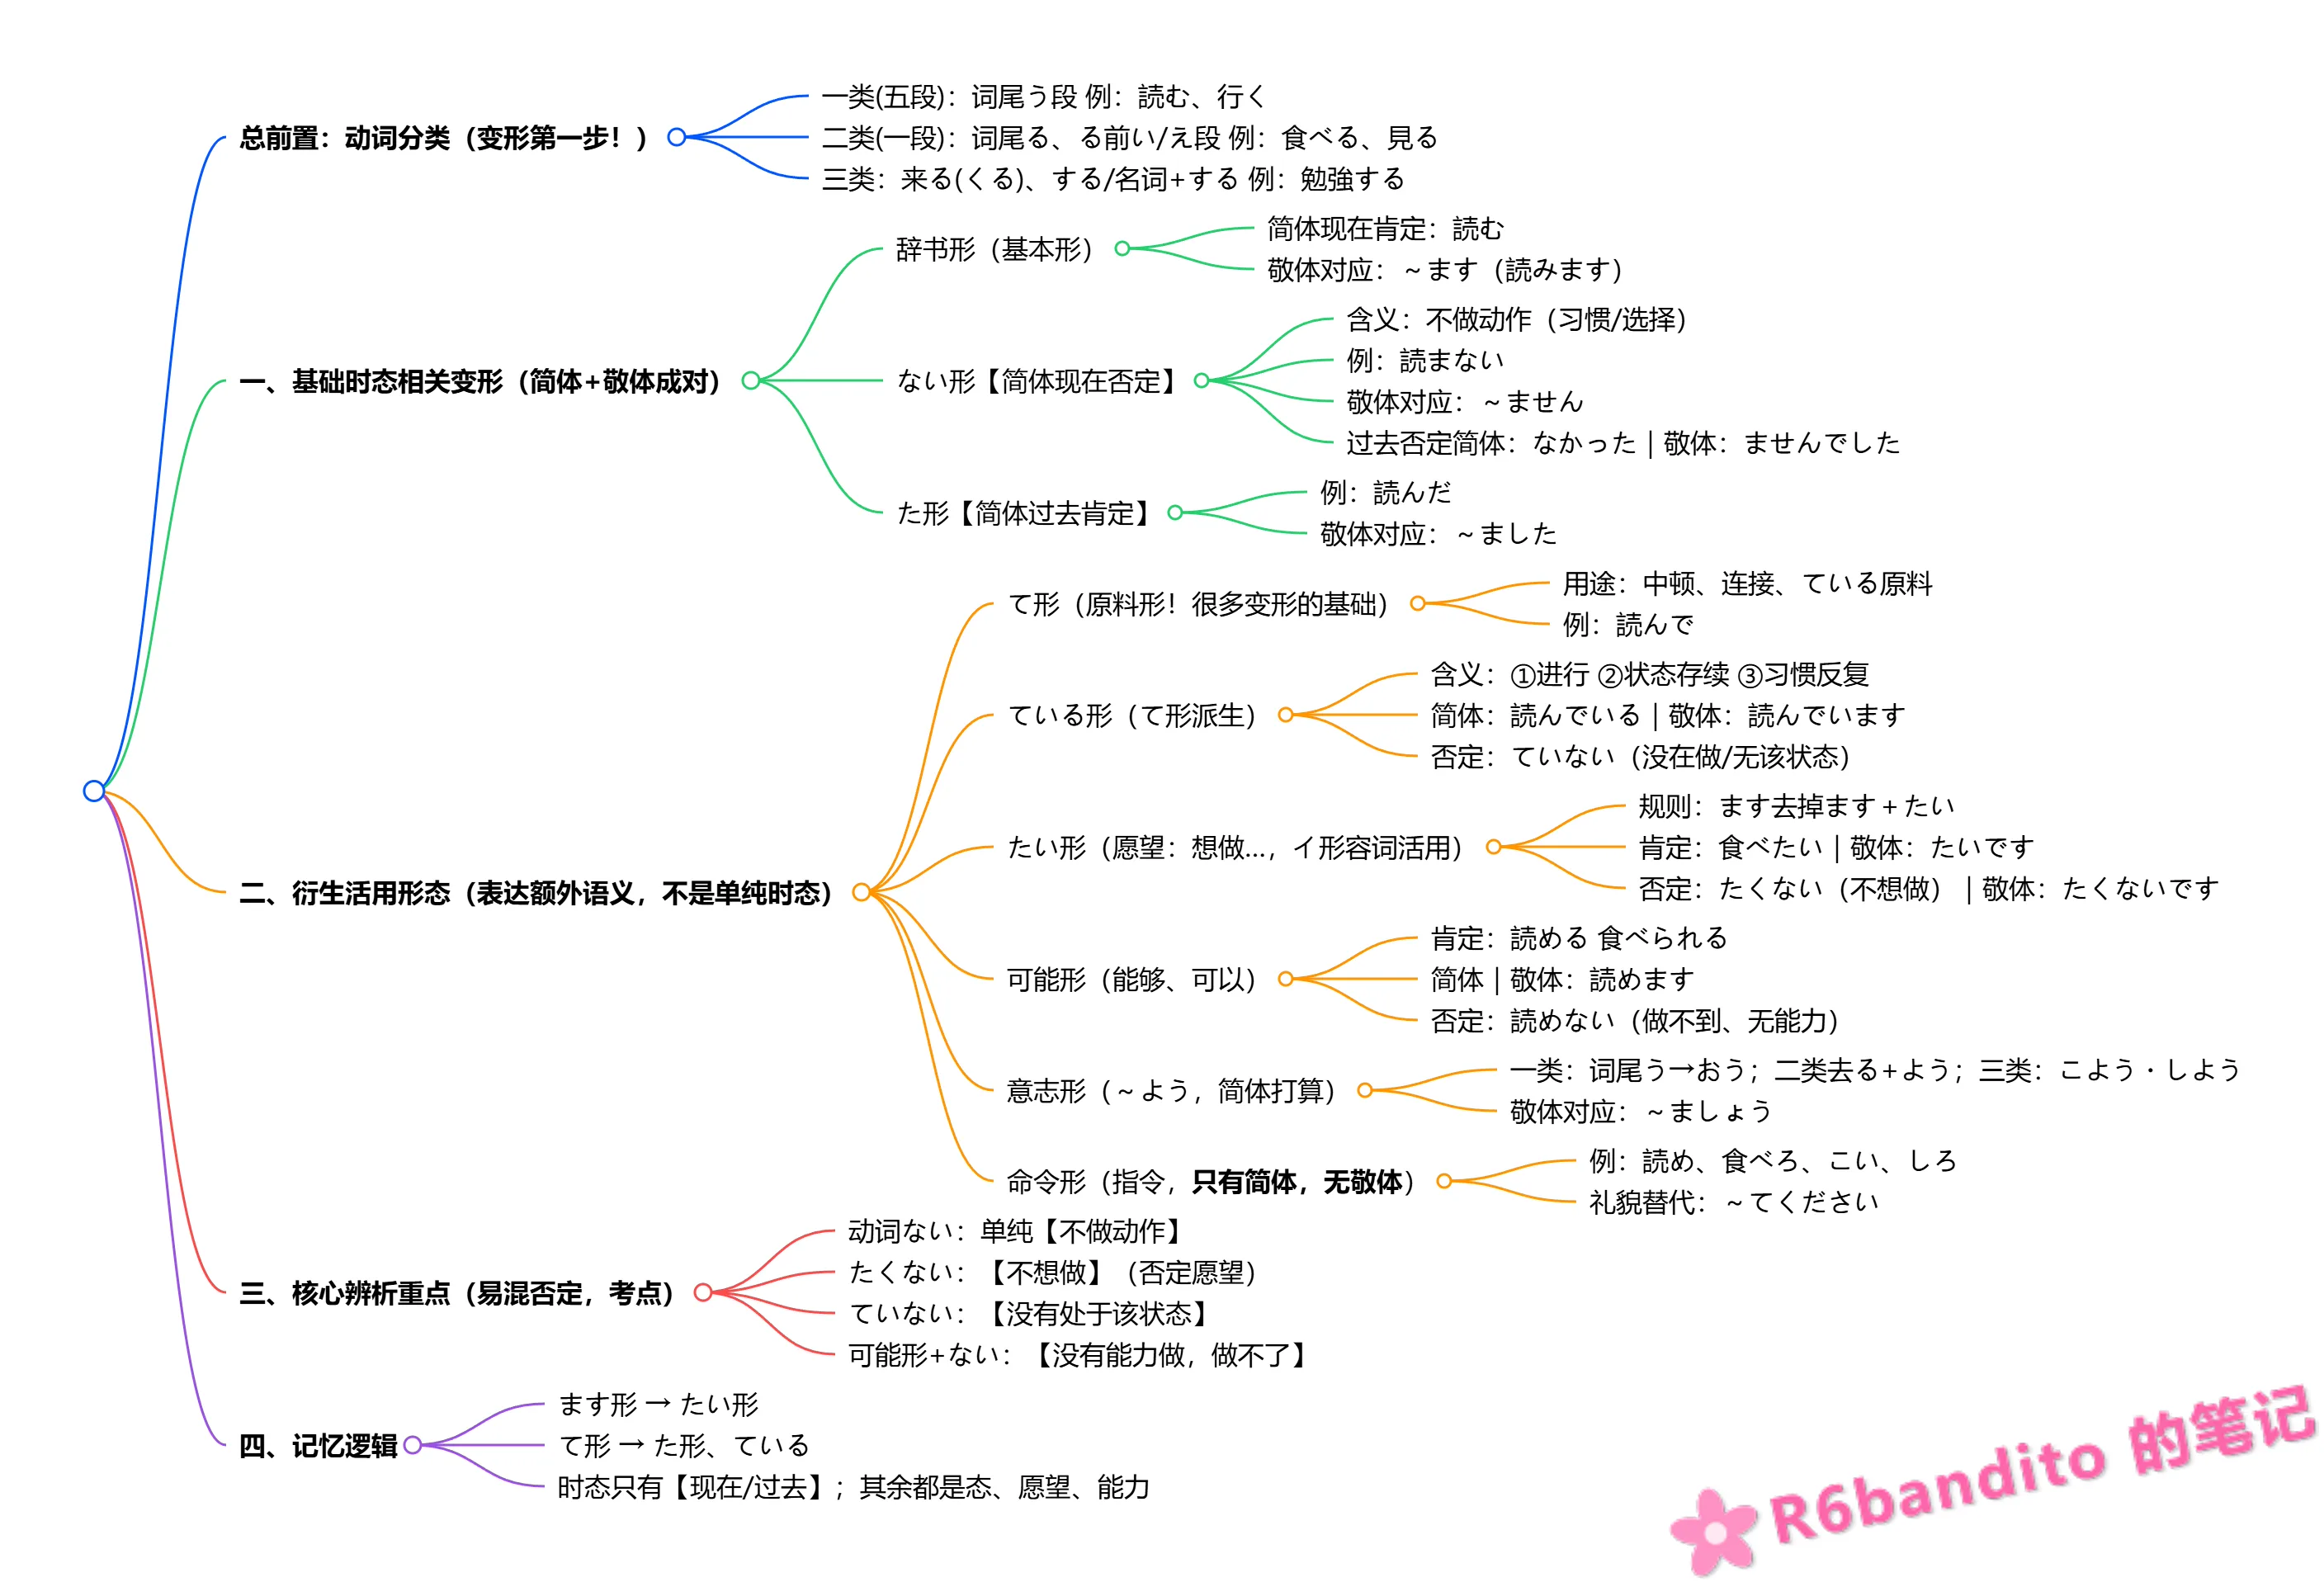
      <![CDATA[<p>日语学到现在也接触了不少词语的变形，在运用时虽然能够正确变形但是仍不熟练。因此在此处整理一份到目前阶段为止的高频变形规则，便于随时查阅与巩固。这里先给个包姐梳理的思维导图，后续参考该图进行整理：</p><img src="/2026/10/05/日语2026100501/日语2026100501_1.webp" style="zoom:80%;" /><h4 id="动词分类"><a href="#动词分类" class="headerlink" title="动词分类"></a>动词分类</h4><p>日语动词分为三类：<strong>一类动词（五段动词）、二类动词（一段动词）、三类动词（か・さ变动词）</strong>。</p><p>简单讲下区分：</p><ul><li><p><strong>一类动词（五段动词）</strong>：词尾在五十音表う段上。例：読む、行く、話す、買う </p></li><li><p><strong>二类动词（一段动词）</strong>：词尾る，る前面是い &#x2F; え段假名。例：食べる、見る、寝る。<br><del>（这其中又分为上一段动词与下一段动词。不过目前来看只要知道这个就行，实际运用时不会去区分这一点）</del></p></li><li><p><strong>三类动词（か・さ变动词）</strong>：其中か变动词就一个——来(く)る。する &#x2F; 名词 + する（勉強する、残業する）</p></li></ul><p>这里有几个十分高频的特殊词语并不遵循上述规则，要特殊记：</p><p><strong>入る（はいる）、走る（はしる）、切る（きる）、知る（しる）、減る（へる）</strong>。这几个词共同点都是符合二类动词规则，但是实际全是一类动词，后续变形时均要按照一类的规则来。尤其是<code>知る（しる）</code>出现频次很高。</p><hr><h4 id="当前阶段-N5-N4-所有变形整理"><a href="#当前阶段-N5-N4-所有变形整理" class="headerlink" title="当前阶段(N5-N4)所有变形整理"></a>当前阶段(N5-N4)所有变形整理</h4><ol><li>辞书形&#x2F;基本形</li><li>ます形</li><li>ない形</li><li>た形</li><li>て形</li><li>ている形</li><li>たい形</li><li>命令形</li><li>意志形</li><li>可能形</li></ol><p>接下来从辞书形开始挨个进行整理。</p><hr><h5 id="动词基本形-辞书形"><a href="#动词基本形-辞书形" class="headerlink" title="动词基本形&#x2F;辞书形"></a>动词基本形&#x2F;辞书形</h5><p>这就是日语动词变形之前的原貌，日语动词的变形是十分丰富的，但是最后剥开各个变形规则后底层还是它。新标日为了简单快速过渡到日语学习，开篇介绍的是动词ます形，在后续学习中再深入到基本形。但是学到目前阶段我认为必须优先记忆辞书形式，因此此处放到第一个整理。</p><p>日语语言表达分为简&#x2F;敬体，<strong>辞书形是简体的现在肯定时态</strong>。这个要记忆纯靠背单次积累词汇量。</p><p>你比如：食べる、行く、読む、勉強する。</p><p>这里抄一些平时经常遇见的动词的辞书形(也算是记记单词)：</p><blockquote><p>泊まる　結ぶ　撮る　取る　食べる</p><p>止まる　生まれる　回る　防ぐ　足りる</p></blockquote><hr><h5 id="动词ます形"><a href="#动词ます形" class="headerlink" title="动词ます形"></a>动词ます形</h5><p>动词ます形是<strong>敬体的现在肯定形式</strong>，上述的动词辞书形是<strong>简体的现在肯定形式</strong>。其变形规则根据动词分类有如下：</p><ul><li><strong>一类动词（五段）</strong>：词尾从う段变到前面的い段，后接ます。例如：行く→行きます、買う→買います。</li><li><strong>二类动词（一段）</strong>：词尾直接去る加ます。例如：食べる→食べます、見る→見ます。</li><li><strong>三类动词</strong>：来(く)る-&gt;来(き)ます（特殊变形，独一份）、～する变します，例如：勉強する→勉強します。</li></ul><p>私は毎朝パンを食べる &lt;—&gt; 私は毎朝パンを食べます。和辞书形对比下来二者含义和时态都是完全相同的，区别只是在于说话的对象是谁。同辈和亲密的对象之间往往是简体形；而对长辈以及不熟的人往往用敬体形。</p><hr><h5 id="动词ない形"><a href="#动词ない形" class="headerlink" title="动词ない形"></a>动词ない形</h5><p>有肯定形式，那自然有否定形式。动词ない形表示的就是<strong>简体现在时态的否定形式</strong>，与辞书形互为反义。其变形规则为：</p><ul><li><strong>一类动词（五段）</strong>：词尾变为对应あ段（也就是五十音表开头第一列），加ない。例如：話す→話さない、読む→読まない。<br>这里要强调一点：<strong>词尾为あ行上面的假名(あいうえお)的变形，词尾不是变为あ，而是变为わ</strong>！例如：買う→買わない、会う→会わない。</li><li><strong>二类动词（一段）</strong>：词尾去掉る加ない。例如：食べる→食べない、見る→見ない。</li><li><strong>三类动词</strong>：来る (くる)→来ない (こない)；する→しない。</li></ul><p>明日のパーティーは私が行かないの。（明天的派对我就不去了哦）</p><p><strong>敬体现在时态的否定形式</strong>为ません。例如：</p><p>私は毎日コーヒーを飲みません。（我每天不喝咖啡）</p><hr><h5 id="动词て形"><a href="#动词て形" class="headerlink" title="动词て形"></a>动词て形</h5><p>て形一般用作固定搭配、句子前后连接表动作顺序、轻微原因、同时状态以及中顿。其变形规则为：</p><ul><li><p><strong>一类动词（五段）</strong>：<br>如果词尾为：<strong>く・ぐ</strong>则发生い音变，即去掉く・ぐ变为いて&#x2F;いで。例如：泳ぐ→泳いで。</p><p>如果词尾为：<strong>つ・る・う</strong>则发生促音变，去掉词尾加促音って。例如：待つ→待って、取る→取って。</p><p>如果词尾为：<strong>ぬ・ぶ・む</strong>则发生拨音变，去掉词尾加んで。例如：飲む→飲んで、遊ぶ→遊んで、死ぬ→死んで。</p><p>如果词尾为：<strong>す</strong>则发生し音变（有点类似三类），去掉词尾加して。例如：話す→話して 。</p></li><li><p><strong>二类动词（一段）</strong>：去掉词尾る加て。例如：食べる→食べて、見る→見て。</p></li><li><p><strong>三类动词</strong>：来る→来て (きて)。～する→～して（和词尾为す的一类动词情况一样）。例如：勉強する→勉強して。</p></li></ul><p>表动作顺序：家に帰って、晩御飯を食べます。（回家然后吃饭）</p><p>表中顿：天気がよくてな、私の気持ちがいいよ。（天气很好啊，我心情很不错）（简体句）</p><p>固定搭配：君の名はここに書いてください。（请在这里写下你的名字）(～てください句型)</p><p>Ps：<code>行く</code>这个词要单独记忆，因为<code>行く</code>不是变成<code>行いて</code>！而是<code>行って</code>。还有上述分类时提到的入る（はいる）这几个特殊一类动词需要特别注意。</p><hr><h5 id="动词た形"><a href="#动词た形" class="headerlink" title="动词た形"></a>动词た形</h5><p>动词た形表示的是动词的<strong>简体过去时态的肯定形式</strong>，指示过去做过的动作。其<strong>变形规则和て形一样，区别只是在于将て变为た，で变为だ</strong>。</p><p>去年の夏休み、毎日2時間日本語を勉強した。（去年暑假，每天学习2小时日语）</p><p>昨日、友達と駅前の本屋へ行って、たくさん雑誌を買った。（昨天和朋友去车站前的书店里买了不少杂志）</p><p>对应的<strong>敬体过去时态的肯定形式</strong>为ました。例如：</p><p>昨日、友達とデパートへ行きました。（昨天和朋友去了百货商店（敬体））</p><p>对应的<strong>简体过去时态的否定形式</strong>为なかった（な<del>い</del>+かった)。例如：</p><p>昨日はパーティーに行かなかった。（昨天我没去派对）</p><p>对应的<strong>敬体过去时态的否定形式</strong>为ませんでした。例如:<br>昨日はパーティーに行きませんでした。（昨天我没去派对（敬体形））</p><p>这里要注意：结合ない形来看，梳理一下——动词时态分为<strong>现在、将来时态</strong>和<strong>过去时态</strong>两种，每一个时态都有各自对应的<strong>肯定形式</strong>和<strong>否定形式</strong>。而每个形式在语境上又分为<strong>敬体</strong>和<strong>简体</strong>。所以总的变换是有8种，这几个变换一定要分清楚。</p><hr><h5 id="ている形式"><a href="#ている形式" class="headerlink" title="ている形式"></a>ている形式</h5><p>ている形式本身并不表示时态或肯定否定。而是由て形派生出来表示动作的持续进行、某种日常习惯、职业身份、以及状态的持续。但是要注意：<strong>虽然自身并不携带时态以及肯否定，但是也具有时态等变形</strong>。这些变形是全部发生在いる身上的。</p><p><strong>变形规则</strong>：</p><p><strong>动词て形 + いる</strong>。いる是二类动词，所有变形参考二类动词规则即可。例如以持续进行为例：</p><blockquote><p>ている（简体现在肯定）：目前正在做的事</p><p>ていた（简体过去肯定）：过去某个时间节点下正在做的事</p><p>ていない（简体现在否定）：现在没在做某事</p><p>ていなかった（简体过去否定）：过去那个时间节点没在做某事</p><p>其各自的敬体形式分别是：</p><p>ています　ていました　ていません　ていませんでした</p></blockquote><ul><li><p><strong>表示动作的持续进行</strong>：<br>今、李さんは日本語の漫画を読んでいる。（小李现在正在看日语漫画）</p><p>彼はご飯を食べていた。（他当时正在吃饭）</p></li><li><p><strong>表示处于某种状态（也就是瞬间动词完成之后，动作的结果保留了下来）</strong>：</p><p>雨が止んでいるのに、彼は傘をさしている。（明明雨已经停了，他却还撑着伞）(撑伞这个动作维持)</p><p>窓が開いている。（窗户正开着）（不是正在开窗这个动作！而是窗户打开这个状态。这里面两个的区别涉及自他动词，此处不做讲解）</p><p>長い間東京に住んでいる。（我住在东京很久了） 这里要注意区分：長い間東京に住んでいた。(我之前在东京住了很久（意思现在已经不住了）)</p></li><li><p><strong>表示一种日常习惯</strong>：<br>毎週土曜日に私はAKB48のライブを見ている。（每周六我都会看AKB48的Live）（日常客观的一个长期习惯行为，不等于目前正在做）</p></li><li><p><strong>表示职业（目前正在从事的）</strong>：<br>佐藤さん今は北京で日本語の教師をしている。（佐藤目前在北京做日语老师）</p></li></ul><p>这里有一点要注意：<strong>表示存在关系的动词いる、ある不能套用ている的形式</strong>，也就是说不存在这种形式。</p><p>我之前写过这样一个句子：ママ、弟が今家にいていないの。（妈妈，现在弟弟不在家）</p><p>这个句子是个错句，原因在于いる存在动词没有再套用一个ている的说法。正确的写法应该是：</p><p>ママ、弟が今家にいないの。</p><hr><h5 id="动词-たい形式"><a href="#动词-たい形式" class="headerlink" title="动词 + たい形式"></a>动词 + たい形式</h5><p>たい和ている类似，本身不带时态和肯否定。表示一种愿望，在中文语境中可以译为“我想要…..”。这里要强调一下这个“我”字，也就是说：<strong>这个形态下，主语只能是说话人自己（我），不能用于形容别人想要</strong>。</p><p><strong>变形规则</strong>：</p><p>这个变形很简单，动词ます形去掉<del>ます</del>＋たい。至于辞书形怎么变到ます形，上述已经讲了。</p><p>例如：日本へとても行きたいな。（真想去日本啊）</p><p>含义是很简单的，但是这里重点在于活用形式。既然有现在想要做某事，那么肯定也有过去想要做某事，不想要做某事。<strong>たい形的活用规则与一类形容词规则是一样的</strong>。</p><ul><li>[简体现在否定] コーヒーを飲みたくない。（不想喝咖啡）</li><li>[简体过去否定] 昨日は何も食べたくなかった。（昨天啥也不想吃）</li><li>[敬体现在否定]  コーヒーを飲みたくないです。</li><li>[敬体过去否定] 昨日は何も食べたくなかったです。</li></ul><p>其它的变形不展示更多了，参考一类形容词即可。</p><hr>]]>
    </content>
    <id>https://r6blog.online/2026/10/05/%E6%97%A5%E8%AF%AD2026100501/</id>
    <link href="https://r6blog.online/2026/10/05/%E6%97%A5%E8%AF%AD2026100501/"/>
    <published>2026-10-05T08:33:25.000Z</published>
    <summary>
      <![CDATA[<p>日语学到现在也接触了不少词语的变形，在运用时虽然能够正确变形但是仍不熟练。因此在此处整理一份到目前阶段为止的高频变形规则，便于随时查阅与巩固。这里先给个包姐梳理的思维导图，后续参考该图进行整理：</p>
<img src="/2026/10/05/日语2026100501/]]>
    </summary>
    <title>N5-N4 动词变形规则整理</title>
    <updated>2026-10-08T07:15:10.251Z</updated>
  </entry>
  <entry>
    <author>
      <name>R6bandito</name>
    </author>
    <category term="日本語勉強する" scheme="https://r6blog.online/categories/%E6%97%A5%E6%9C%AC%E8%AA%9E%E5%8B%89%E5%BC%B7%E3%81%99%E3%82%8B/"/>
    <category term="日本語" scheme="https://r6blog.online/tags/%E6%97%A5%E6%9C%AC%E8%AA%9E/"/>
    <content>
      <![CDATA[<h4 id="形容词-名词小句修饰名词"><a href="#形容词-名词小句修饰名词" class="headerlink" title="形容词&#x2F;名词小句修饰名词"></a>形容词&#x2F;名词小句修饰名词</h4><p>小句即类似于英语中的从句概念，例如：“我想要一台操作简单的电脑”。本句中核心主干为“我想要电脑(コンピューターが欲しいです)”，具体是什么样的电脑呢？是“操作简单的电脑(操作が簡単なの)”。这便是一个典型的形容词小句修饰主干句名词的典型示例。</p><p><strong>接续规则</strong>：</p><ul><li><strong>一类形容词小句，形容词用基本形直接接续</strong>。</li><li><strong>二类形容词小句，形容词用 “二类形 + な” 的形式</strong>。</li><li><strong>名词小句，用 “名词 + の”　的形式</strong>。</li></ul><p><strong>示例如下</strong>：</p><ul><li>[形1小句] 空気がいい國へ旅行に行きたいです。（想要去<strong>空气好的国家</strong>旅行）</li><li>[形2小句] 料理が上手な人が好きです。（我喜欢<strong>对做饭很拿手的</strong>人）</li><li>[名词小句] 皮が手作りの餃子を食べたいです。（想要吃<strong>皮是纯手工制作的</strong>饺子）</li></ul><h4 id="动词小句修饰名词"><a href="#动词小句修饰名词" class="headerlink" title="动词小句修饰名词"></a>动词小句修饰名词</h4><p><strong>接续规则</strong>：</p><ul><li><strong>动词小句直接用动词简体形接续，表示某个习惯或将来状态</strong>。</li><li><strong>如果是形容已经发生的动作，那么应该使用动词た形（过去时态）</strong>。</li></ul><p><strong>示例如下</strong>：</p><ul><li>これは李さんにあげる本です。（这是我要给小李的书(将来时，现在在我手上还没给)）</li><li>あれは私が李さんにあげた本です。（那本是我给小李的书(过去时，已经给了，所属权不再归我)）</li><li>昨日会社を休んだ人は森さんです。（昨天请假没来公司的人是森先生）</li><li>明日来ない人は私が知らない。（我不知道明天谁不来(这里是简体否定形<code>来ない</code>修饰<code>人</code>)）</li><li>公園で歌っている人。(公园里正在唱歌的人(<code>ている</code> 正在持续的状态))</li></ul><h4 id="の-形式名词"><a href="#の-形式名词" class="headerlink" title="の　形式名词"></a>の　形式名词</h4><p>形式名词の作用就是：<strong>将动词&#x2F;形容词句子进行名词化</strong>，使其整体能够作为一个名词进行使用。动词・イ形容词简体 + <strong>の</strong> → 变成名词性质，可以当主语、宾语。</p><p>一般情况下，の名词化的小句做主语时，主语助词用は引导。例如：<br><strong>自転車に二人で乗る</strong>のは危ないです。（骑自行车带入很危险）</p><p>本句中，<code>自転車に二人で乗る</code>是一个动词小句，被の名词化之后以名词身份做主语。は是主语助词提示主题，表示“骑自行车带人”这件事，所以句子核心其实就是： A は B です的一个简单句型。</p><p>但是要注意：<strong>当被名词化的小句是“好きです”、“上手です”、“下手です”、“嫌いです”等这些表示情感和好恶的形容词作用的对象时，主语助词要用が</strong>。例如：</p><p>李さん、絵をかくのが好きですね。（小李，你很喜欢画画啊）</p><p><strong>例句</strong>：</p><ul><li>日本語で手紙を書くのは難しいですね。（用日语写信真难啊）</li><li>佐藤さんは写真を撮るのが本当に上手です。（佐藤很会拍照片）</li><li>テレビを消すのを忘れました。（忘关电视了）</li></ul><p><strong>附注</strong>：</p><p>こと和の一样，都可以将小句名词化。こと本意就是“这件事”的意思，可以用于名词化小句代指小句描述的这件事。接续规则和の一样，因此大部分情况下二者可以互相替换。</p><p>例如：日本語を勉強するのは難しいです　＝　日本語を勉強することは難しいです</p><p>但是以下情况不能互换：</p><ol><li>固定搭配，比如 <code>た＋ことがある</code>（曾经做过，经历过），只能用固定的搭配，比如此处的こと；再比如 <code>ことができる</code>（能力，能够做），也是只能用こと。</li><li>感官动词之前必须用の，比如 見る、聞こえる等等。<br>例如：李さんは森さんが車から降りるのを見ました。（小李看见森从车上下来了）</li><li>语言和思想行为方面的动词前只能用こと不能用の，比如 伝える、話す。<br>例如：李さんは森さんが休むことを伝えました。（小李转告了森请假的事）</li></ol><p>由于比较杂，这里引用一个梦子老师的口诀来记忆：<strong>除了语言和思想行为方面的动词，其它情况一律用の就不会错</strong>。</p><h4 id="でしょう-表推测"><a href="#でしょう-表推测" class="headerlink" title="でしょう　表推测"></a>でしょう　表推测</h4><p>表猜测，可能性在80%左右，读降调👇。你也可以将它理解为表确认（自己内心已经有一个看法，用于确认自己的看法对不对）。</p><p>でしょう在日常口语中的频率是比较高的，而且常常与たぶん（或许，也许）配合使用，加强语气。</p><p><strong>接续规则</strong>：</p><ul><li><strong>一类形容词&#x2F;动词 均用简体 + でしょう。</strong></li><li><strong>二类形容词词干&#x2F;名词 + でしょう。（名词&#x2F;二类形 去掉だ）</strong><br>例如:静かだ（二类形简体）-&gt; 静かでしょう（去掉だ）<br>ここは静かでしょう。（这里应该很安静吧）</li></ul><p><strong>先来看表推测情况的例句</strong>：</p><ul><li>明日の朝は大雨になるでしょう。（明早会下大雨吧）</li><li>いま桜の季節ですから、東京はたぶん賑やかでしょう。（现在是樱花的季节，东京大概很热闹吧）</li><li>その赤い服を着ない人はたぶん森さんだろう。（那个没穿红衣服的人也许是森吧）</li></ul><p>Ps：でしょう的简体形是だろう。</p><p><strong>再来看表确认情况的例句</strong>：</p><ul><li>李さん、明日パーティーに行くでしょう。（小李，明天的派对你会去吧）</li><li>也可以带有一定的质问语气：おかあさん、私の日記、見たでしょう。（老妈，你看了我的日记了吧）</li></ul><p>要注意：表确认情况时读上升调👆。</p><p>这里要提一嘴：でしょう没有过去式，如果要表示对过去的推测应该是 <code>动词た形+でしょう</code>，而不是<code>でしたでしょう</code>！</p><p>例如：昨日雨が降ったでしょう。（昨天应该下过雨了吧）</p><h4 id="かもしれません"><a href="#かもしれません" class="headerlink" title="かもしれません"></a>かもしれません</h4><p>也表示推测，但是这个可能性只有50%，也就是说可能会发生某事，但是没有でしょう那么确定。所有的接续规则和でしょう是一样的，所以把它和でしょう一块记忆就可以了。可以搭配もしかしたら（也许，说不定）一起使用。</p><p><strong>例句</strong>：</p><ul><li>森さんは今日会社を休むかもしれません。（森啊今天可能不来上班了）</li><li>もしかしたら、いま李さんは忙しいかもしれません。（也许现在小李正在忙吧）</li><li>明日の天気はもしかしたら大雨かもしれない。（明天天气也许会下大雨吧（かもしれない是简体形式））</li></ul><p>注意：一对相反形（肯定和否定）后面并列使用かもしれません可以表示“也许….也许….”句型。例如：</p><p>明日は雨が降るかもしれませんが、降らないかもしれませんよ。（明天也许下雨，也许不会下雨）</p><h4 id="ながら-同时进行的动作"><a href="#ながら-同时进行的动作" class="headerlink" title="ながら　同时进行的动作"></a>ながら　同时进行的动作</h4><p>ながら和中文语境中的”一边….一边….”是一样的。都是强调同时进行的两个动作，其中ながら后面接的是主要动作。要注意的是：ながら只能用于同一主体，也就是说不能写成“小李一边….，小森一边….”这种形式。</p><p><strong>接续规则</strong>：</p><ul><li><strong>动词的ます形去掉ます，后接ながら</strong>。</li></ul><p><strong>例句</strong>：</p><ul><li>李さんはテレビを見ながら、食事をしている。（小李边看电视边吃饭(吃饭是正在进行的动作，用ている表进行时)）</li><li>あのことを考えながら、歩いていた。（一边思考那件事一边走着）</li></ul><p>Ps：接续的两个动词都必须是可持续的动词，死ぬ等这些瞬时动词不能放进去。</p><h4 id="小句-時"><a href="#小句-時" class="headerlink" title="小句+時"></a>小句+時</h4><p><code>小句+時</code>表一个时间节点，如中文语境中的：“在我小的时候”(私が子供の時)。</p><p><strong>接续规则</strong>：</p><ul><li><strong>与前文小句接续规则是一样的，都是简体形小句</strong>。<br>形1&#x2F;动词 –&gt; 简体+時<br>形2 –&gt; + な+時<br>名词  –&gt; + の+時</li></ul><p>这里要注意的是：如果是动词小句，那么情况就有点特殊。因为动词时态分为现在时态和过去时态，如果动词小句为现在时态，那么表示整个小句所描述的那件事还没有发生；如果是过去时态，则表示动词小句修饰的那件事已经发生了。</p><p>这里光文字描述可能有些空洞，看下面的例子：</p><ul><li>日本に行く時、たくさんお土産を買いました。（要去日本的时候买了很多礼物）<br>这句话是动词现在时态小句，表示要去日本，但是在这个动作发生之前先发生了后面的购买礼物的动作。也就是说礼物不是在日本买的！</li><li>日本に行った時、たくさんお土産を買いました。（去日本后买了很多礼物）<br>动词过去时态小句，表示这个动作已经发生了。礼物是在去到日本之后才买的！</li></ul><p><strong>其它例句</strong>：</p><ul><li>天気がいい時、友達と野球をする。（天气好的时候会和朋友们一起打棒球）</li><li>仕事が暇な時、残業しない。（工作不忙的时候不用加班）</li><li>子供の時、横浜に住んでいた。（小时候住在横滨）</li></ul><p>Ps：<code>時</code>后面跟<code>に</code>可以表示一次性的，个别的情况。例如：</p><ul><li>この前、友達が病気の時に、私は看病しました。（前些天朋友生病时我照看了他）</li></ul><h4 id="名词-で-表原因、理由"><a href="#名词-で-表原因、理由" class="headerlink" title="名词+で　表原因、理由"></a>名词+で　表原因、理由</h4><p>助词で放到名词后可以表示原因、理由。例句：</p><ul><li>仕事で、楊さんとあっていたんですよ。（因为工作原因，我（那段时间）一直和杨先生见面来着）</li></ul><h4 id="动词-ている-形"><a href="#动词-ている-形" class="headerlink" title="动词 ている 形"></a>动词 ている 形</h4><p>前面我们学到了<code>动词+ている</code>表正在进行的动作。但是ている并不只有这一个用法，下面借此来梳理一下ている的多个用法：</p><ul><li><strong>正在进行时态</strong>：李さんは今電話をかけている。（小李现在正在打电话）</li><li><strong>结果、状态的存续</strong>：森さんは車を持っている。（森有一辆车）<br>直接按照中文语境根据不同动词译为”拥有、住在、认识、已婚”等等即可</li><li><strong>表示某种习惯的事</strong>：李さんは先月から、図書館で日本語を勉強している。（小李从上个月开始就日常在图书馆学日语）</li><li><strong>表反复、周期性的事件</strong>：週に1回日本語専門学校に通っている。（每周去一次日语培训学校）</li><li><strong>表职业</strong>：私は北京で日本語の教師をしています。（我是北京教日语的一名老师）</li></ul><p>这里要注意：表示反复和习惯时，只要是单纯描述一个客观事实的情况下，也可用基本形进行替换。</p><p>例如：週に1回日本語専門学校に通う。表示的也是同一个意思。</p><h4 id="て＋あげる／まらう／くれる-表抽象授受关系"><a href="#て＋あげる／まらう／くれる-表抽象授受关系" class="headerlink" title="て＋あげる／まらう／くれる　表抽象授受关系"></a>て＋あげる／まらう／くれる　表抽象授受关系</h4><p>在这之前已经学习过：あげる&#x2F;まらう&#x2F;くれる 用于授受关系。其中</p><ul><li><strong>あげる</strong>：表示说话人给他人某物，说话人做主语。<br>私は李さんに韓国で買ったCDをあげました。（我把我在韩国买的CD给了小李）</li><li><strong>まらう</strong>：表示说话人从他人那里获取某物，说话人做主语。<br>このマフラーは私が誕生日に森さんにもらいました。(这条毛巾是我生日的时候从森那里拿到的)</li><li><strong>くれる</strong>：他人给说话人某物，他人是主语。<br>これは森さんが[私に]くれた本です。（这是森给我的书）</li></ul><p>这些授受关系的词均可以译为中文里面的“给”，只要正确区分“给”的方向就行。</p><p>当这些授受关系词加上<code>て</code>之后，即：<br><code>动词て形 + あげる／まらう／くれる</code> 则表示一类抽象的授受关系，不再表示物理上的得到和给予，<strong>而是请别人帮我做某事或我主动帮别人做某事，是抽象概念</strong>。</p><ul><li><strong>てあげる</strong>：说话人一方主动帮别人做事。<br>森さんは年寄りの荷物を持ってあげました。（森帮老人拿了行李）</li><li><strong>てまらう</strong>：表示说话人接收了对方的恩惠或对方对自己的一些行为，蕴含有一种感谢之意。<br>私は森さんに東京を案内してもらいました。（森带我游览了东京）</li><li><strong>てくれる</strong>：他人做主语给说话人做事，其反问形式可以表示说话人请求别人做某事。<br>友達が面白い本を教えてくれました。(朋友给我介绍了一本有趣的书)<br>ごみを出してくれますか。（能帮我倒一下垃圾吗）</li></ul><p>这里要注意的是：</p><p><code>てあげる</code>如果是说话人直接就是动作主体时，会给人一种强加于人的印象，不太礼貌，因此对关系不近或地位高的人尽量不使用。例如对老师说：この本をあなたに貸してあげます。（我把这本书借给你）这句话语法本身没错，但是类似于中文语境“这本书是我借给你的&#x2F;这本书我就借给你吧”，给人一种自上而下的感觉<del>（虽然我也不太明白怎么读出这种感觉的(lll￢ω￢)）</del>。</p><p><code>てくれる</code> 在使用反问形式请求别人帮自己做某事时，还有一种更礼貌的用法：<code>てくれませんか</code>。这比直接反问要礼貌不少。例如：森君、この資料をコピーしてくれませんか。（森先生，能否帮忙打印下这份资料？）</p>]]>
    </content>
    <id>https://r6blog.online/2026/10/02/%E6%97%A5%E8%AF%AD2026100201/</id>
    <link href="https://r6blog.online/2026/10/02/%E6%97%A5%E8%AF%AD2026100201/"/>
    <published>2026-10-02T01:36:42.000Z</published>
    <summary>
      <![CDATA[<h4 id="形容词-名词小句修饰名词"><a href="#形容词-名词小句修饰名词" class="headerlink" title="形容词&#x2F;名词小句修饰名词"></a>形容词&#x2F;名词小句修饰名词</h4><p>小句即类似于英语中的从句概念，例如：“我]]>
    </summary>
    <title>《新标日初级第三版》 第七单元梳理</title>
    <updated>2026-10-08T07:15:10.251Z</updated>
  </entry>
  <entry>
    <author>
      <name>R6bandito</name>
    </author>
    <category term="网络通信" scheme="https://r6blog.online/categories/%E7%BD%91%E7%BB%9C%E9%80%9A%E4%BF%A1/"/>
    <category term="LwIP" scheme="https://r6blog.online/tags/LwIP/"/>
    <category term="TCP/IP" scheme="https://r6blog.online/tags/TCP-IP/"/>
    <content>
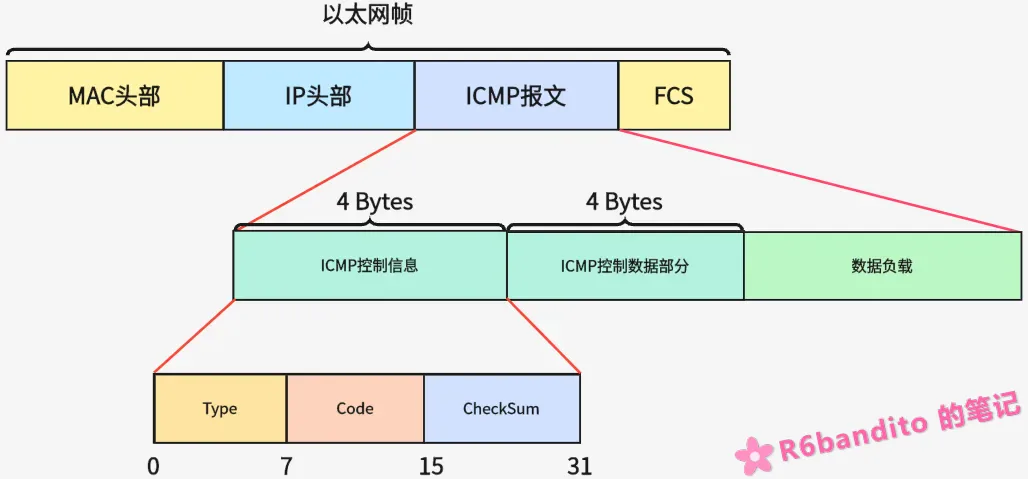
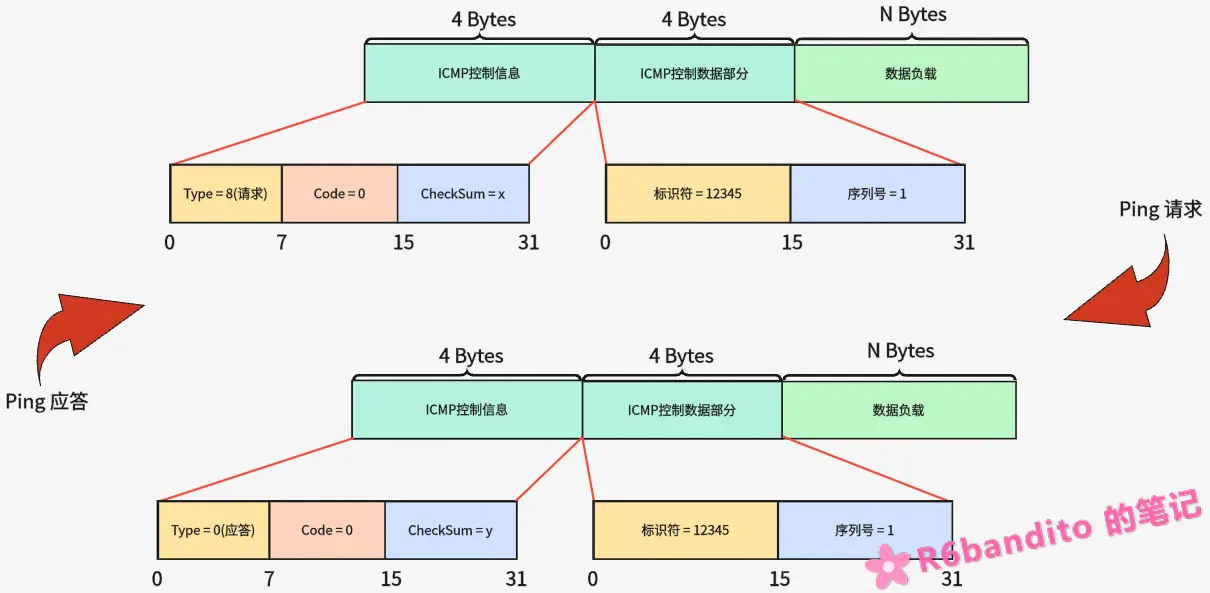
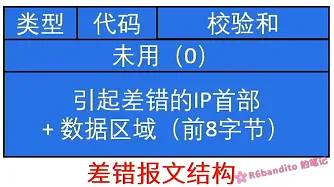
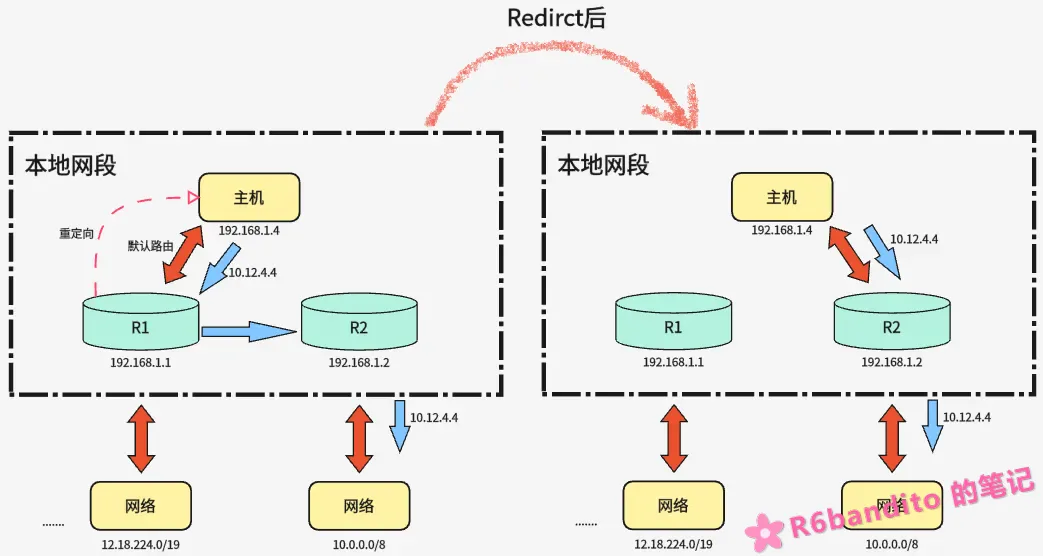
      <![CDATA[<h4 id="引言"><a href="#引言" class="headerlink" title="引言"></a>引言</h4><p>在IP网络环境中，我们已经知道：IP数据包的路由并不是完全可靠的，只是尽力而为。IP协议只负责尽可能将你的数据包送达对端，至于能否正确送达并不能完全保证。IP协议自身也并不提供任何的差错报告机制来保证数据递交的有效性，这就会出现一种情况：“我本机发出的数据包，对端是否正确收到？上层是否需要重新发一个过去？许久没和对端通信之后，对端是否还活着并正常提供服务？甚至我自己的网络环境怎么样，能不能和外界正常通信？”这些都是IP协议自身无法解决的问题。</p><p>因此我们就需要一个协议来<strong>传递整个通信过程中出现的异常行为，以及监控通信是否正常</strong>。这个协议就是：ICMP(Internet Control Message Protocol)。</p><hr><h4 id="什么是-ICMP？"><a href="#什么是-ICMP？" class="headerlink" title="什么是 ICMP？"></a>什么是 ICMP？</h4><p>ICMP 是网络层的一个重要的协议，<strong>负责传递网络层的差错和控制信息</strong>，不携带用户数据。虽然与IP、ARP协议同属于网络层，但是<strong>ICMP其实是依附在IP协议之上的一个更上层的协议</strong>。这一点就注定了ICMP的报文形式与ARP的报文形式有本质区别，下文将详细讲述。</p><p>这里要注意：ICMP不属于传输层，因此不涉及任何的端口概念。</p><p>ICMP有三大功能：<strong>IP重定向、差错信息传递（差错报文）、查询控制（查询报文）</strong>。</p><hr><h4 id="ICMP-报文格式"><a href="#ICMP-报文格式" class="headerlink" title="ICMP 报文格式"></a>ICMP 报文格式</h4><img src="/2026/09/28/嵌入式2026092801/2026092801_1.webp" style="zoom:67%;" /><p>ICMP报文是基于IP协议为基础构建的，也就是说其实ICMP本质也是一个IP包，ICMP的报文部分就是这个IP包的数据段。只是协议栈内部设计了单独处理这种类型报文的逻辑，这也就是我们说的ICMP协议了。</p><p>ICMP和ARP虽然共处于网络层，但是在报文形式上的本质区别是：<strong>ARP报文直接封装在以太网帧中，不需要有IP头部</strong>，ARP在这种前提下可以认为是完全脱离IP协议而独立的；而ICMP报文封装在IP中，与IP协议是一个上下的依赖关系。</p><p>ICMP报文控制头部固定8字节，这8个字节的布局如下表所示：</p><table><thead><tr><th align="left">字段</th><th align="left">长度</th><th align="left">说明</th></tr></thead><tbody><tr><td align="left">类型</td><td align="left">1 字节</td><td align="left">标识 ICMP 报文的大类</td></tr><tr><td align="left">代码</td><td align="left">1 字节</td><td align="left">类型的子分类</td></tr><tr><td align="left">校验和</td><td align="left">2 字节</td><td align="left">覆盖整个 ICMP 报文</td></tr><tr><td align="left">其余字段</td><td align="left">4字节</td><td align="left">含义取决于类型和代码</td></tr></tbody></table><p>这里讲讲数据部分取决于类型是什么意思：<strong>ICMP这8个字节的头部是固定不可变的</strong>。前四个字节（类型、代码、校验和）是<strong>完全通用</strong>的。<strong>后4个字节负载根据不同的ICMP报文类型，会采取不同的措施</strong>。</p><p>就以我们常见的Ping举例：对于Ping的Echo Request和Reply，ICMP数据负载那4个字节被划分为了——标识符(2字节)+序列号(2字节)；而对于重定向功能，后4个字节则被定义为新网关IP地址；而对于一些其它类型，则选择保留(全0)。所以总结就是：<strong>这4个字节始终存在于固定头部中，只是具体含义随报文类型而变化</strong>。</p><p>这里我还需要再说明一个地方：</p><p>先来看个示例，我们亲自抓一个Ping包看看。我们以Ping网关为例</p><figure class="highlight bash"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br></pre></td><td class="code"><pre><code class="hljs bash">Yukirin@DESKTOP-8BFBE1K:~$ ping -c 1 172.18.224.1<br>PING 172.18.224.1 (172.18.224.1) 56(84) bytes of data.<br>64 bytes from 172.18.224.1: icmp_seq=1 ttl=128 <span class="hljs-keyword">time</span>=0.299 ms<br><br>--- 172.18.224.1 ping statistics ---<br>1 packets transmitted, 1 received, 0% packet loss, <span class="hljs-keyword">time</span> 0ms<br>rtt min/avg/max/mdev = 0.299/0.299/0.299/0.000 ms<br><br>Frame 1: Packet, 98 bytes on wire (784 bits), 98 bytes captured (784 bits) on interface eth0, <span class="hljs-built_in">id</span> 0<br>....<br></code></pre></td></tr></table></figure><p>发现了吗？ping输出了一个56(84)大小的数据，而我们tshark抓到的包却显示98字节捕获。这里讲讲这几个数据为什么会出现差异：</p><ul><li><strong>56(84)</strong>：Ping中输出的56，指的是<strong>ICMP数据载荷长度</strong>，也就是我们上图中数据负载那一部分。而84指的是整个IP数据包的大小。此例中——我们 IP标准头(20字节)+ICMP控制头部(8字节)+ICMP数据负载部分(56字节) &#x3D; 84字节。</li><li><strong>98</strong>：tshark在抓包时抓的是整个以太网帧的长度，是货真价实跑在物理传输线路上的，因此要算上MAC头部(14字节)。即：84 + 14 &#x3D; 98字节。这里要注意：FCS校验和在抓包前通常已经被底层网卡硬件给校验完毕后去除了，所以抓不到也不显示。</li></ul><p>讲这个示例目的是为了分清ICMP控制数据部分和ICMP数据负载部分。ICMP控制头8字节，不代表整个ICMP报文就只能是8个字节，控制头后面有时还跟得有数据负载的！你比如我们可以以下列命令构造一个1400字节负载的Ping包</p><figure class="highlight bash"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br></pre></td><td class="code"><pre><code class="hljs bash">Yukirin@DESKTOP-8BFBE1K:~$ ping -c 1 -s 1400 172.18.224.1<br>PING 172.18.224.1 (172.18.224.1) 1400(1428) bytes of data.<br>1408 bytes from 172.18.224.1: icmp_seq=1 ttl=128 <span class="hljs-keyword">time</span>=0.374 ms<br><br>--- 172.18.224.1 ping statistics ---<br>1 packets transmitted, 1 received, 0% packet loss, <span class="hljs-keyword">time</span> 0ms<br>rtt min/avg/max/mdev = 0.374/0.374/0.374/0.000 ms<br></code></pre></td></tr></table></figure><p><strong>一定要正确区分控制头的数据部分和控制头之外的ICMP数据负载</strong>！</p><p>最后这里给出一个类型与代码对应表，后续将以该表为依据讲几个常用的类型：</p><table><thead><tr><th align="left">类型</th><th align="left">名称</th><th align="left">代码</th><th align="left">说明</th></tr></thead><tbody><tr><td align="left">0</td><td align="left">Echo Reply</td><td align="left">0</td><td align="left">ping 应答</td></tr><tr><td align="left">3</td><td align="left">Destination Unreachable</td><td align="left">0~15</td><td align="left">目标不可达</td></tr><tr><td align="left">5</td><td align="left">Redirect</td><td align="left">0~3</td><td align="left">重定向</td></tr><tr><td align="left">8</td><td align="left">Echo Request</td><td align="left">0</td><td align="left">ping 请求</td></tr><tr><td align="left">11</td><td align="left">Time Exceeded</td><td align="left">0&#x2F;1</td><td align="left">TTL 超时</td></tr><tr><td align="left">12</td><td align="left">Parameter Problem</td><td align="left">0~2</td><td align="left">参数错误</td></tr><tr><td align="left">13&#x2F;14</td><td align="left">Timestamp</td><td align="left">0</td><td align="left">时间戳（很少使用）</td></tr></tbody></table><hr><h4 id="ICMP-查询报文"><a href="#ICMP-查询报文" class="headerlink" title="ICMP 查询报文"></a>ICMP 查询报文</h4><p>ICMP查询机制里面，有多对查询类型报文：比如ping报文(类型8&#x2F;0)、时间戳(13&#x2F;14)这些都是ICMP查询机制里面包含的，但是其中很多均已废弃，并不常用。当前ICMP整个查询报文里面最常用的就是ping。</p><p>ping报文的作用是检测网络环境的连通性。其请求报文的类型(Type)为8，代码(Code)也为0；ping应答报文的类型为0，代码为0。ping报文ICMP控制头的低4字节数据部分是有使用的，这4个字节被拆分为了<strong>标识符(2字节)+序列号(2字节)</strong>。</p><ul><li><strong>标识符</strong>：用于区分由哪个进程发起的本次ping通信。</li><li><strong>序列号</strong>：区分这是同一个进程的第几个ping包。</li></ul><p>如下图就是一个ping请求与应答的ICMP报文部分</p><img src="/2026/09/28/嵌入式2026092801/2026092801_2.webp" style="zoom:67%;" /><p>可以看到，对于ping的回复基本上是将请求数据包原封不动送回去。由于类型改变了，因此CheckSum要重算，其它地方全部不动。</p><p>再看一个实际的抓包示例：</p><figure class="highlight bash"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br></pre></td><td class="code"><pre><code class="hljs bash">Yukirin@DESKTOP-8BFBE1K:~$ ping -c 1 -s 700 172.18.224.1<br><br>tcpdump: verbose output suppressed, use -v[v]... <span class="hljs-keyword">for</span> full protocol decode<br>listening on eth0, link-type EN10MB (Ethernet), snapshot length 262144 bytes<br>14:01:19.448455 IP 172.18.228.235 &gt; DESKTOP-8BFBE1K.mshome.net: ICMP <span class="hljs-built_in">echo</span> request, <span class="hljs-built_in">id</span> 13872, <span class="hljs-built_in">seq</span> 1, length 708<br>14:01:19.448852 IP DESKTOP-8BFBE1K.mshome.net &gt; 172.18.228.235: ICMP <span class="hljs-built_in">echo</span> reply, <span class="hljs-built_in">id</span> 13872, <span class="hljs-built_in">seq</span> 1, length 708<br></code></pre></td></tr></table></figure><p>该示例中，标识符就是13872，序列号为1表示是本次ping通信的第一个包。</p><p>一次完整的ping通信流程如下:</p><ul><li>上层触发ping通信。</li><li>协议栈内部构造ICMP Echo Request报文。</li><li>将ICMP信息报装入IP数据包中。查路由表决定下一跳，确定IP数据包的发送方向。</li><li>若目标设备处于同一网段，则对目标IP发起ARP解析以获取其MAC（若ARP表中无该条目或条目已过期，会先挂起发送动作并广播ARP。详见<a href="/2026/09/19/%E5%B5%8C%E5%85%A5%E5%BC%8F2026091902/" title="ARP 地址解析协议">ARP地址解析协议</a>）；若处于不同网段，则解析本网段网关的MAC，发给网关。</li><li>目标设备收到后，构造ICMP Reply并回送。</li><li>本机收到对方的回复后，计算往返时间。</li></ul><hr><h4 id="ICMP-差错报文"><a href="#ICMP-差错报文" class="headerlink" title="ICMP 差错报文"></a>ICMP 差错报文</h4><p>差错信息上报机制是ICMP协议的三大功能之一，差错报文专门用来通告网络通信中出现的各种问题。与查询报文不同，<strong>差错报文是单向通信</strong>！差错报文不能主动请求发送，只能在网络出问题时协议栈内部自行发送。</p><p>差错报文主要有以下几个类型：</p><p><strong>类型3</strong></p><table><thead><tr><th align="left">Code</th><th align="left">含义</th><th align="left">典型场景</th></tr></thead><tbody><tr><td align="left">0</td><td align="left">网络不可达</td><td align="left">没有路由</td></tr><tr><td align="left">1</td><td align="left">主机不可达</td><td align="left">主机不存在&#x2F;关机</td></tr><tr><td align="left">2</td><td align="left">协议不可达</td><td align="left">目标不支持该协议</td></tr><tr><td align="left">3</td><td align="left">端口不可达</td><td align="left"><strong>目标端口没人监听</strong></td></tr><tr><td align="left">4</td><td align="left">需要分片但 DF 置位</td><td align="left">MTU 问题</td></tr><tr><td align="left">5</td><td align="left">源路由失败</td><td align="left">—</td></tr><tr><td align="left">6</td><td align="left">目的网络未知</td><td align="left">—</td></tr><tr><td align="left">7</td><td align="left">目的主机未知</td><td align="left">—</td></tr><tr><td align="left">9&#x2F;10</td><td align="left">网络&#x2F;主机被管理员禁止</td><td align="left">防火墙</td></tr><tr><td align="left">13</td><td align="left">通信被管理员禁止</td><td align="left">防火墙</td></tr></tbody></table><p>类型3是平时见得最多的错误类型，例如错误访问了一个未被监听的端口，对端就会发来该类型的报文。这里以一个实际抓包为例：我们在Windows侧的UDP调试助手上发送一个UDP数据报给WSL2中Linux本机的未监听端口8081，同时抓取eth0网卡上的ICMP流量。抓到的数据如下：</p><figure class="highlight plaintext"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br><span class="line">19</span><br><span class="line">20</span><br><span class="line">21</span><br><span class="line">22</span><br></pre></td><td class="code"><pre><code class="hljs plaintext">Frame 1: Packet, 75 bytes on wire (600 bits), 75 bytes captured (600 bits) on interface eth0, id 0<br>    Section number: 1<br>    Interface id: 0 (eth0)<br>        Interface name: eth0<br>    Encapsulation type: Ethernet (1)<br>......<br>Internet Protocol Version 4, Src: 172.18.228.235, Dst: 172.18.224.1<br>.......<br>    Protocol: ICMP (1)  #ICMP包<br>    Header Checksum: 0xde88 [validation disabled]<br>    [Header checksum status: Unverified]<br>    Source Address: 172.18.228.235<br>    Destination Address: 172.18.224.1  #该ICMP包由172.18.228.235 发往--&gt; 172.18.224.1<br>    [Stream index: 0]<br>Internet Control Message Protocol<br>    Type: Destination unreachable (3)<br>        [Expert Info (Note/Response): Type indicates an error]<br>            [Type indicates an error]<br>            [Severity level: Note]<br>            [Group: Response]<br>    Code: 3 (Port unreachable)  # Type3 Code3 目标端口不可达<br>    ....<br></code></pre></td></tr></table></figure><p>这里重点来看ICMP部分。我们的UDP数据报从Windows虚拟网卡地址 <code>172.18.224.1</code> 发出，目标为 Linux 本机 <code>172.18.228.235</code> 的 8081 端口。由于Linux本机并未监听该端口，内核直接封装了一个 <strong>ICMP Type 3 Code 3（端口不可达）</strong> 报文，发送给发送方 <code>172.18.224.1</code>。注意，<code>172.18.224.1</code> 既是WSL的网关，也是Windows宿主机上虚拟网卡的IP，因此该ICMP报文直接到达宿主机，由宿主机的网络栈通知对应的UDP套接字，而无需经过额外的网关转发过程。</p><hr><p><strong>类型11</strong>:<strong>Time Exceed超时</strong></p><table><thead><tr><th align="left">Code</th><th align="left">含义</th></tr></thead><tbody><tr><td align="left">0</td><td align="left">TTL 耗尽（传输中）</td></tr><tr><td align="left">1</td><td align="left">分片重组超时</td></tr></tbody></table><p>类型11在平时也十分常见，当我们去尝试连接一个并不存在的地址、或在traceroute场景下经常会与该类型的包打交道。这里同样来看一个实际的抓包示例：这里我们尝试去连接一个不同网段的地址<code>172.16.224.1</code>看看会发生什么。</p><figure class="highlight bash"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br></pre></td><td class="code"><pre><code class="hljs bash"><span class="hljs-comment">#终端1 构建SYN包尝试连接 172.16.224.1:1240</span><br>Yukirin@DESKTOP-8BFBE1K:~$ <span class="hljs-built_in">sudo</span> hping3 -S -p 1240 -c 1 172.16.224.1<br><br><span class="hljs-comment">#终端2 抓通过网卡的ICMP流量</span><br>Yukirin@DESKTOP-8BFBE1K:~$ <span class="hljs-built_in">sudo</span> tshark -i eth0 -x icmp<br>Running as user <span class="hljs-string">&quot;root&quot;</span> and group <span class="hljs-string">&quot;root&quot;</span>. This could be dangerous.<br>Capturing on <span class="hljs-string">&#x27;eth0&#x27;</span><br></code></pre></td></tr></table></figure><p>执行后，两个终端分别得到如下输出：</p><figure class="highlight bash"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br></pre></td><td class="code"><pre><code class="hljs bash"><span class="hljs-comment">#终端1</span><br>HPING 172.16.224.1 (eth0 172.16.224.1): S <span class="hljs-built_in">set</span>, 40 headers + 0 data bytes<br>TTL 0 during transit from ip=10.3.255.38 name=UNKNOWN<br><br><span class="hljs-comment">#终端2 (抓到的ICMP流量原始数据(以太网帧))</span><br>0000  00 15 5d 2e 41 b5 00 15 5d 2e 1f 84 08 00 45 c0   ..].A...].....E.<br>0010  00 44 c0 bc 00 00 3c 01 23 15 0a 03 ff 26 ac 12   .D....&lt;.#....&amp;..<br>0020  e4 eb 0b 00 d6 4d 00 00 00 00 45 00 00 28 f1 33   .....M....E..(.3<br>0030  00 00 01 06 ab 8c ac 12 e4 eb ac 10 e0 01 04 c1   ................<br>0040  04 d8 42 0a 0d fa 65 71 57 19 50 02 02 00 b6 87   ..B...eqW.P.....<br>0050  00 00                                             ..<br></code></pre></td></tr></table></figure><p><code>TTL 0 during transit from ip=10.3.255.38 name=UNKNOWN</code>这里表示我们的包在传输途中TTL已经减为0了，被路由器丢弃。而丢弃该包的路由器正是 <code>10.3.255.38</code>，我们抓到的该包ICMP报文也是该路由器送出给我们的差错报文。 </p><p>在捕获的原始报文中，我们可以按照格式解析出以下数据</p><figure class="highlight plaintext"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br></pre></td><td class="code"><pre><code class="hljs plaintext">IP头：<br>45 c0              ← 版本 4，首部长度 20 字节<br>00 44              ← 总长度 68 字节<br>c0 bc              ← 标识<br>00 00              ← 标志 + 分片偏移<br>3c                 ← TTL = 60<br>01                 ← 协议 = 1（ICMP!）<br>23 15              ← 首部校验和<br>0a 03 ff 26        ← 源 IP：10.3.255.38（中间路由器）<br>ac 12 e4 eb        ← 目标 IP：172.18.228.235（我们的地址）<br><br>ICMP控制头：<br>0b                 ← 类型 = 11（Time Exceeded，超时）<br>00                 ← 代码 = 0（TTL 超时）<br>d6 4d              ← 校验和<br>00 00 00 00        ← ICMP控制头数据部分（类型11保留）<br></code></pre></td></tr></table></figure><p>这就是一个货真价实的类型11超时ICMP错误报文，由中间某段路由器发来告诉我们本地包已经被丢了，通信失败。</p><p>这里简单讲讲为什么会被丢。首先我们在WSL虚拟环境中的本机地址为 <code>172.18.228.235</code>，网关是<code>172.18.224.1</code>，本地网段的网络地址为<code>172.18.224.0/20(子网掩码:255.255.240.0)</code>。我们请求连接的对方是 <code>172.16.224.1</code>，我们用子网掩码去&amp;一下对方地址，得到 <code>172.16.224.0</code> !&#x3D; <code>172.18.224.0</code>。</p><p>因此我们的SYN请求包先被发给了我们的网关，然后由网关来到我们宿主机Windows本地，Windows本机查自己的ARP表也找不到该地址，只能继续发给Windows的对外网关。公网路由器并不知道<code>172.16.224.1</code>在哪，只能按默认网关路由，于是该包在网络环境中被反复路由，直到TTL耗尽。</p><p>路径大致是这样的： WSL –&gt; Windows –&gt; 校园网&#x2F;企业网 –&gt; 外部网络。</p><p>这里需要再多说明一点：看抓包的源码你会发现ICMP控制头之后，还带有不少负载数据。这是因为差错报文<strong>不仅需要指明是何种错误，还需要携带原始IP包的IP头部以及原始包的IP数据段至少前8字节</strong>。为什么至少8字节？因为在传输层TCP&#x2F;UDP头部中，前8字节刚好能够拿到源端口、目标端口以及序列号。如下所示：</p><figure class="highlight plaintext"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br></pre></td><td class="code"><pre><code class="hljs plaintext">45 00 00 28        ← 原始 IP 头开始<br>f1 33 00 00        ← 标识 + 标志<br>01 06 ab 8c        ← TTL=1，协议=6（TCP）<br>ac 12 e4 eb        ← 原始源 IP：172.18.228.235（本机）<br>ac 10 e0 01        ← 原始目标 IP：172.16.224.1（目标）<br>04 c1              ← 原始源端口：1217<br>04 d8              ← 原始目标端口：1240<br>42 0a 0d fa        ← 原始序列号<br>65 71 57 19        ← 原始确认号<br>50 02              ← 原始数据偏移 + 标志（SYN）<br>02 00              ← 原始窗口大小<br>b6 87              ← 原始校验和<br>00 00              ← 紧急指针<br></code></pre></td></tr></table></figure><p>这里数据段多从TCP头部中截取了12个字节。也就是说我们抓的该包中 <code>原始IP头部(20字节) + 原始IP数据段（也就是TCP头）（20字节） = 40字节</code>。多截取数据部分并没有问题，因为协议只规定了至少要8字节。</p><img src="/2026/09/28/嵌入式2026092801/2026092801_3.webp" style="zoom: 67%;" /><p>验算一下： </p><p><strong>MAC头14字节 + IP头20字节 + ICMP控制头8字节 + 原始IP头20字节 + 截取的原始IP数据段20字节 &#x3D; 82字节</strong>。正确</p><hr><p>ICMP差错报文是有硬性约束的，目的是为了防止差错报文引发互联网环境灾难。</p><ul><li><p><strong>ICMP差错报文如果本身也出错，那么将直接丢弃，不允许再次发回ICMP报文描述这次差错</strong>。<br>这个约束性质在很多网络资料中都会被简化为为了防止出现无限差错风暴而设计的，但是你实际去想一下拓扑会发现无限循环这种网络拓扑实际很难出现，这个特性更多是防止差错链变长占用带宽。</p><p>试想一下：假如允许使用差错回复差错，那么一个差错报文在长达数十跳的路由环境中假如频繁出现差错，那么这一整条线上会多出数个因此而诞生的ICMP报文占用带宽。</p></li><li><p><strong>不为广播&#x2F;多播发ICMP报文</strong>。</p><p>目标地址是多播或广播的包，出错时不允许发送ICMP报文。源地址是广播&#x2F;多播地址的包，也不会回复ICMP。</p><p>比如我们向本地广播地址发一个ping包，从底层视角来看这个ping包实际是被该网段下每个设备的以太网路硬件都收到了的，但是包被移交上层时协议栈发现该ICMP报文目标竟然是广播，直接就静默丢弃了。</p><p>这么做是为了防止攻击者利用广播进行攻击，假如攻击者伪造受害者不断ping广播，如果允许回复的话，那么受害者将瞬间被大量ICMP直接打瘫痪。</p></li><li><p><strong>不为非分片首片的包发差错</strong>。</p><p>如果一个包被分片了，只有第一个分片（offset &#x3D; 0）出错才回差错，后续分片不回。因为分片包只有首片携带了传输层的头部（TCP&#x2F;UDP），其它分片只携带数据，就算回了差错报文，发送方拿到后也获取不了有效信息反而多个差错报文会干扰发送方，还会多余占用带宽。</p></li></ul><hr><h4 id="重定向-Redirect"><a href="#重定向-Redirect" class="headerlink" title="重定向 Redirect"></a>重定向 Redirect</h4><p>除了类型3和类型11这种纯粹的差错上报，ICMP还有一类特殊的报文——重定向（类型5），它不仅能报告异常，还能主动优化主机的路由表。</p><p><strong>类型5</strong></p><table><thead><tr><th align="left">Code</th><th align="left">含义</th></tr></thead><tbody><tr><td align="left">0</td><td align="left">重定向<strong>网络</strong></td></tr><tr><td align="left">1</td><td align="left">重定向<strong>主机</strong></td></tr><tr><td align="left">2</td><td align="left">重定向<strong>服务类型 + 网络</strong></td></tr><tr><td align="left">3</td><td align="left">重定向<strong>服务类型 + 主机</strong></td></tr></tbody></table><p>重定向是ICMP报文的又一大应用之一，独特的点在于<strong>能够改变主机的路由表，影响主机的路由选择</strong>。</p><p>其原理是：当中间路由器发现主机使用的发送路径并不是最优且主机并未开启<strong>IP源路径</strong>选项时，路由器在向外递送报文的同时会向主机回复一个ICMP重定向报文，这个报文中涵盖了一个新的网关IP。主机收到该报文后，将自己的路由表的网关改为新网关IP，后续流量直接走新网关，不必再经过旧网关多绕一遍，提高通信效率。</p><p>例如下图所示：</p><img src="/2026/09/28/嵌入式2026092801/2026092801_4.webp" style="zoom:67%;" /><p>示例中，我们本机默认网关为R1，当我们本机需要与公网<code>10.12.4.4</code>进行通信时，将数据包发给网关R1（图中蓝色箭头），由R1代发给公网。R1收到后查路由表发现去往<code>10.0.0.0/8</code>更优的下一跳是R2，而且R1与R2与本机都在同一个网段。于是R1在将本次收到的数据包递交给R2的同时也回复一个ICMP重定向给本机，本机收到后将网关改为重定向的IP。后续到<code>10.12.4.4</code>的通信全部直接走R2，就不需要再经过R1绕一遍了。</p><p>这里讲讲ICMP的重定向触发条件：</p><ul><li>首先肯定是主机和路由器双方都必须允许ICMP重定向，这是根本条件。假如双端有任何一端不允许重定向，那么整个动作都无法完成，无论是否满足剩余条件。</li><li><strong>入接口必须等于出接口</strong>：一个包从路由器进来，如果进来与出去的流量都是走同一个接口，那么说明发送方和路由器在同一个网段，且下一跳也在同一个网段，这才可能触发重定向。例如上述示例，假设一个网络包从R1(eth0)进来（主机发给R1），R1查路由表发现这个包得给R2，而R2刚好处于同一网段，eth0可以直达，于是包就从eth0进入，eth0发出。满足条件。</li><li><strong>下一跳IP和包的源IP处于同一网段</strong>：这是肯定的，否则就算你R1给推荐了一个路由，但是与本机不处于同一网段，本机够不到，也是白搭。</li><li><strong>包没有被源路由</strong>：如果发送方IP选项内部已经指明了该包必须按照指定的路径发，那么路由器就不得擅自修改。</li><li><strong>源包不是路由器自己发的</strong>：路由器自己发的包，谈不上告诉别人改路由这个情况。</li></ul><p>在实验环境中，重定向很难出现，得在多路由环境下才能观测得到，所以此处不给出示例了。</p><p>当然，重定向和ARP的学习行为都是一把双刃剑。既然能改路由表，那就避免不了攻击。常见的重定向攻击便是攻击者伪造一个ICMP重定向报文，使得目标主机将路由改为攻击者，后续发给公网的数据全部被攻击者劫持和窃听。</p><p>所以当今互联网环境中，重定向功能基本都被主机默认关闭。关于优化问题现在也有不少可靠的动态路由协议，重定向的使用面已经比较窄了。</p><hr><h4 id="ICMP-其它应用"><a href="#ICMP-其它应用" class="headerlink" title="ICMP 其它应用"></a>ICMP 其它应用</h4><h5 id="Traceroute"><a href="#Traceroute" class="headerlink" title="Traceroute"></a>Traceroute</h5><p>traceroute算是ICMP报文一个十分经典的应用了，主要用于跟踪数据包被路由的每一跳节点。其核心原理就是：<strong>靠ICMP类型11的超时报文，让包故意在路径上失活，然后依次暴露路径上的每一跳直到包到达目的端</strong>。</p><p>这里需要知道，IP头部有一个TTL字段，含义是包的生存时间。TTL每经过一跳就会被中间路由器减1，当TTL减到0时，路由器便会丢弃该包，并向源IP回复一个ICMP 类型11的差错报文（超时）。</p><p>因此，我们就可以故意发 TTL &#x3D; 1、TTL &#x3D; 2、TTL &#x3D; 3….的包，每一跳路由器都会向我们回复一个ICMP报文，我们通过解析该报文即可获得对应的中间路由器的地址。每收到一个ICMP就暴露一跳，直到包到达目标。</p><p>来看下面一个推演流程，例如我们有以下网络拓扑：</p><figure class="highlight plaintext"><table><tr><td class="gutter"><pre><span class="line">1</span><br></pre></td><td class="code"><pre><code class="hljs plaintext">主机 H ── R1 ── R2 ── R3 ── 目标 T<br></code></pre></td></tr></table></figure><ul><li><strong>第一跳</strong>：TTL &#x3D; 1，由本机H-&gt;R1。R1收到包后TTL为0，向本机回复ICMP，本机收到ICMP后记录第一跳。</li><li><strong>第二跳</strong>：TTL &#x3D; 2，本机H-&gt;R2。R2收到后TTL为0回ICMP。本机记录R2。</li><li><strong>第三跳</strong>：TTL &#x3D; 3，同理本机收到ICMP后记录R3。</li><li><strong>第四跳</strong>：TTL &#x3D; 4，成功到达目标，目标T回复ICMP。本机收到后记录，本轮traceroute探测终止。</li></ul><p>关于traceroute的方法，可以自行构造ping包挨个递增TTL或自行构造UDP包访问对端未监听高端口，并自行递增TTL，这是手动的方法。目前也有许多自动化工具用于追踪，比如Linux上的traceroute工具。该工具并不预装，需要使用以下命令进行安装：</p><figure class="highlight bash"><table><tr><td class="gutter"><pre><span class="line">1</span><br></pre></td><td class="code"><pre><code class="hljs bash"><span class="hljs-built_in">sudo</span> apt install traceroute<br></code></pre></td></tr></table></figure><p>接下来就以该工具演示trace百度的一个实例：</p><figure class="highlight bash"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br></pre></td><td class="code"><pre><code class="hljs bash"><span class="hljs-comment">#终端1</span><br>Yukirin@DESKTOP-8BFBE1K:~$ <span class="hljs-built_in">sudo</span> tshark -i eth0 icmp<br><br><span class="hljs-comment">#终端2</span><br>Yukirin@DESKTOP-8BFBE1K:~$ traceroute baidu.com<br></code></pre></td></tr></table></figure><p>结果如下所示：</p><figure class="highlight bash"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br><span class="line">19</span><br><span class="line">20</span><br><span class="line">21</span><br><span class="line">22</span><br><span class="line">23</span><br><span class="line">24</span><br><span class="line">25</span><br><span class="line">26</span><br><span class="line">27</span><br><span class="line">28</span><br><span class="line">29</span><br><span class="line">30</span><br><span class="line">31</span><br><span class="line">32</span><br><span class="line">33</span><br><span class="line">34</span><br><span class="line">35</span><br><span class="line">36</span><br><span class="line">37</span><br><span class="line">38</span><br><span class="line">39</span><br><span class="line">40</span><br><span class="line">41</span><br><span class="line">42</span><br><span class="line">43</span><br></pre></td><td class="code"><pre><code class="hljs bash"><span class="hljs-comment">#终端1</span><br>Capturing on <span class="hljs-string">&#x27;eth0&#x27;</span><br>    1 0.000000000 172.18.224.1 → 172.18.228.235 ICMP 102 Time-to-live exceeded (Time to live exceeded <span class="hljs-keyword">in</span> transit)<br>    2 0.000000270 172.18.224.1 → 172.18.228.235 ICMP 102 Time-to-live exceeded (Time to live exceeded <span class="hljs-keyword">in</span> transit)<br>    3 0.000000340 172.18.224.1 → 172.18.228.235 ICMP 102 Time-to-live exceeded (Time to live exceeded <span class="hljs-keyword">in</span> transit)<br>    4 0.002513097    10.32.0.1 → 172.18.228.235 ICMP 70 Time-to-live exceeded (Time to live exceeded <span class="hljs-keyword">in</span> transit)<br>    5 0.002513378    10.32.0.1 → 172.18.228.235 ICMP 70 Time-to-live exceeded (Time to live exceeded <span class="hljs-keyword">in</span> transit)<br>    6 0.002513448    10.32.0.1 → 172.18.228.235 ICMP 70 Time-to-live exceeded (Time to live exceeded <span class="hljs-keyword">in</span> transit)<br>    7 0.002515427 10.50.255.253 → 172.18.228.235 ICMP 102 Time-to-live exceeded (Time to live exceeded <span class="hljs-keyword">in</span> transit)<br>    .....<br>    <br><span class="hljs-comment">#终端2</span><br>traceroute to baidu.com (111.63.65.103), 30 hops max, 60 byte packets<br> 1  DESKTOP-8BFBE1K.mshome.net (172.18.224.1)  0.194 ms  0.150 ms  0.136 ms<br> 2  10.32.0.1 (10.32.0.1)  2.637 ms  2.589 ms  2.575 ms<br> 3  10.50.255.253 (10.50.255.253)  2.547 ms  2.507 ms  2.505 ms<br> 4  58.213.28.201 (58.213.28.201)  4.023 ms  2.861 ms  3.984 ms<br> 5  221.226.71.189 (221.226.71.189)  2.822 ms 221.226.71.193 (221.226.71.193)  2.826 ms  2.809 ms<br> 6  * * *<br> 7  * * *<br> 8  * 202.97.126.73 (202.97.126.73)  21.666 ms *<br> 9  * 202.97.75.130 (202.97.75.130)  23.262 ms 202.97.118.34 (202.97.118.34)  23.245 ms<br>10  221.183.187.161 (221.183.187.161)  25.720 ms 221.183.86.49 (221.183.86.49)  28.528 ms 221.183.177.109 (221.183.177.109)  21.959 ms<br>11  221.183.94.25 (221.183.94.25)  27.418 ms  27.320 ms  27.293 ms<br>12  221.183.148.158 (221.183.148.158)  61.837 ms 221.183.137.222 (221.183.137.222)  34.077 ms 221.183.148.158 (221.183.148.158)  72.360 ms<br>13  * * *<br>14  112.54.105.42 (112.54.105.42)  40.671 ms 112.54.105.102 (112.54.105.102)  34.486 ms 112.54.105.110 (112.54.105.110)  25.103 ms<br>15  * * *<br>16  * * *<br>17  * * *<br>18  * * *<br>19  * * *<br>20  * * *<br>21  * * *<br>22  * * *<br>23  * * *<br>24  * * *<br>25  * * *<br>26  * * *<br>27  * * *<br>28  * * *<br>29  * * *<br>30  * * *<br></code></pre></td></tr></table></figure><p>这里可以看到我们的traceroute默认发的是ICMP。整个过程你会发现虽然确实暴露了不少中间路由节点，但是还有不少的***，这通常是正常现象，表示该跳中间节点并没有响应我们。</p><p>上述我们说过，每一跳会暴露对应中间路由，这是在理论推演的情况下进行的。实际上每个中间路由节点的配置不同，并不是每一个中间节点都会回复。这其中原因很多：有的服务器防火墙会拦截ICMP，导致探测包被挡、有的服务器默认不响应。你也可以采用UDP或TCP的形式进行追踪，不过此处不展开详细讨论。</p><p>关于Traceroute最后补充一点就是：</p><p><strong>不只有ICMP可以进行探测，UDP&#x2F;TCP都可以</strong>。</p><p>UDP模式的原理是：本机发UDP包访问对端高端口（这些端口往往不被监听），当UDP包处于中间路由器时，中间路由器回复ICMP超时。当包到达对端时触发ICMP：端口不可达，完成探测。</p><p>TCP模式是类似的：本机发起TCP握手连接，指定一个目标端口。当TCP包处于中间路由器时，中间路由器依旧回复ICMP超时。当包到达对端后，如果端口被监听，则对面会回复ACK；若端口未被监听，对面会回复RST。本机收到ACK&#x2F;RST后即可判断成功抵达对端，本次trace结束。</p><p>TCP优点在于能够直连对方的服务端口，防火墙往往会拦截ICMP和UDP高端口访问，但是不会拦截TCP的正常端口访问，因此防火墙穿透能力很高。</p><hr><h5 id="PMTUD-路径MTU发现"><a href="#PMTUD-路径MTU发现" class="headerlink" title="PMTUD (路径MTU发现)"></a>PMTUD (路径MTU发现)</h5><p>这也是一个很经典的应用：网络环境中，有时候底层链路的MTU往往是不同的，你比如以太网最大MTU为1500，假如我们为了效率都按照这个MTU来发包，看似没问题。但是数据包在网络中路由时会经过很多跳，有的跳底层MTU并没有1500，那么这个时候就会发生分片行为，降低效率。甚至当我们设置了不分片时，包会一直被丢弃，导致本机通信失败。</p><p>所以向对端发包时，我们需要知道整个路由上最小的一个MTU是多少，并以此为依据进行发送。这个时候就要用到PMTUD技术了。</p><p>其原理很简单：我们一开始先发一个大包，并设置不允许分片。大包发出去后若直达对端，说明是理想情况，整条路由路径上没有MTU瓶颈。若在中间某一跳卡住了，被卡住的那台中间路由器会回复ICMP类型3代码4（需要分片但不允许分片），并会携带一个MTU值，我们收到后就把包大小调整成新MTU的大小，继续发送。</p><p>循环上述操作，最终包会抵达对端，我们也成功探出了整条路径上最小的MTU大小。当然，这种方法肯定是有局限的，因为十分依赖ICMP报文。假如本地防火墙卡了ICMP、或中间路由器不响应ICMP、再或者ICMP路由时出错了，这些都是有可能的。</p><p>如果上层没有防御手段，那么表现就是通信挂掉了。本文只讲MTU的探测原理，所以这里不详细展开。</p><hr><h4 id="END"><a href="#END" class="headerlink" title="END"></a>END</h4>]]>
    </content>
    <id>https://r6blog.online/2026/09/28/%E5%B5%8C%E5%85%A5%E5%BC%8F2026092801/</id>
    <link href="https://r6blog.online/2026/09/28/%E5%B5%8C%E5%85%A5%E5%BC%8F2026092801/"/>
    <published>2026-09-28T01:27:41.000Z</published>
    <summary>
      <![CDATA[<h4 id="引言"><a href="#引言" class="headerlink" title="引言"></a>引言</h4><p>在IP网络环境中，我们已经知道：IP数据包的路由并不是完全可靠的，只是尽力而为。IP协议只负责尽可能将你的数据包送达对端，至于能否正确送达并]]>
    </summary>
    <title>ICMP Internet控制报文协议</title>
    <updated>2026-10-08T07:15:10.247Z</updated>
  </entry>
  <entry>
    <author>
      <name>R6bandito</name>
    </author>
    <category term="嵌入式" scheme="https://r6blog.online/categories/%E5%B5%8C%E5%85%A5%E5%BC%8F/"/>
    <category term="Note" scheme="https://r6blog.online/tags/Note/"/>
    <category term="Linux" scheme="https://r6blog.online/tags/Linux/"/>
    <content>
      <![CDATA[<h4 id="前言"><a href="#前言" class="headerlink" title="前言"></a>前言</h4><p>本篇文章用于记录一些Linux系统中的常用操作命令。Linux的命令系统是十分强大和复杂的，为了能够熟练进行系统操作，在这里归档一些常用命令以及常用参数，便于随时查看。如果需要更多更细节的一些操作命令，请自行查阅手册。</p><hr><h4 id="文件与目录操作命令"><a href="#文件与目录操作命令" class="headerlink" title="文件与目录操作命令"></a>文件与目录操作命令</h4><ul><li><p><code>pwd</code>：<strong>显示当前所处路径</strong></p><p>没有任何参数，单纯用来看自己当前处于什么位置。</p><figure class="highlight bash"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br></pre></td><td class="code"><pre><code class="hljs bash">user:~/work$ <span class="hljs-built_in">pwd</span><br>/home/Yukirin/work<br></code></pre></td></tr></table></figure></li><li><p><code>cd</code>：<strong>切换工作目录</strong></p><figure class="highlight bash"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br></pre></td><td class="code"><pre><code class="hljs bash"><span class="hljs-built_in">cd</span> /home/user/project   <span class="hljs-comment"># 进入绝对路径</span><br><span class="hljs-built_in">cd</span> project              <span class="hljs-comment"># 进入相对路径</span><br><span class="hljs-built_in">cd</span> ..                   <span class="hljs-comment"># 返回上一级</span><br><span class="hljs-built_in">cd</span> ../..                <span class="hljs-comment"># 返回上两级</span><br><span class="hljs-built_in">cd</span> ~                    <span class="hljs-comment"># 回到家目录（等价于 cd）</span><br><span class="hljs-built_in">cd</span> -                    <span class="hljs-comment"># 回到上一次所在目录</span><br></code></pre></td></tr></table></figure><p>这里要注意一下：<code>cd -</code> 不是进入上一级目录，而是类似于出栈撤回的操作。例如当前处于家目录，使用<code>cd /user/project/subdir</code> 跳转后，使用 <code>cd -</code> 回到的不是 <code>/user/project</code>，而是跳转之前的家目录。</p></li><li><p><code>ls</code>：<strong>列出当前目录下内容</strong></p><figure class="highlight bash"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br></pre></td><td class="code"><pre><code class="hljs bash"><span class="hljs-built_in">ls</span>                  <span class="hljs-comment"># 简单列出</span><br><span class="hljs-built_in">ls</span> -l               <span class="hljs-comment"># 长格式：权限、链接数、所有者、大小、时间、名字</span><br><span class="hljs-built_in">ls</span> -a               <span class="hljs-comment"># 显示隐藏文件（以 . 开头）</span><br><span class="hljs-built_in">ls</span> -h               <span class="hljs-comment"># 人类可读大小（配合 -l）</span><br><span class="hljs-built_in">ls</span> -lh              <span class="hljs-comment"># 最常用组合</span><br><span class="hljs-built_in">ls</span> -alh             <span class="hljs-comment"># 显示所有文件 + 长格式 + 易读大小</span><br><span class="hljs-built_in">ls</span> -t               <span class="hljs-comment"># 按修改时间排序（新的在前）</span><br><span class="hljs-built_in">ls</span> -r               <span class="hljs-comment"># 反向排序</span><br><span class="hljs-built_in">ls</span> -S               <span class="hljs-comment"># 按大小排序（大的在前）</span><br><span class="hljs-built_in">ls</span> -R               <span class="hljs-comment"># 递归列出子目录</span><br><span class="hljs-built_in">ls</span> -d */            <span class="hljs-comment"># 只列出目录本身，不展开内容</span><br><span class="hljs-built_in">ls</span> -i               <span class="hljs-comment"># 显示 inode 号</span><br></code></pre></td></tr></table></figure><p>实际开发中，最常用的组合是 <code>ls -alh</code> ，能够应对90%的使用场景。在一些Linux的发行版（例如我这个Ubuntu 26.04）会将该命令重定义为 <code>ll</code>，敲命令时直接使用<code>ll</code>更方便。</p><figure class="highlight bash"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br></pre></td><td class="code"><pre><code class="hljs bash">Yukirin@DESKTOP-8BFBE1K:~$ ll<br>total 76<br>-rw------- 1 Yukirin Yukirin  5426 Sep 25 16:51  .bash_history<br>-rw-r--r-- 1 Yukirin Yukirin   220 Sep 18 18:54  .bash_logout<br>....<br><br>Yukirin@DESKTOP-8BFBE1K:~$ <span class="hljs-built_in">ls</span> -alh<br>total 76K<br>-rw------- 1 Yukirin Yukirin 5.3K Sep 25 16:51  .bash_history<br>-rw-r--r-- 1 Yukirin Yukirin  220 Sep 18 18:54  .bash_logout<br>....<br></code></pre></td></tr></table></figure><p>可使用<code>type</code>命令检查是否有绑定，如果没有，自己绑定一个就可以了。</p><figure class="highlight bash"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br></pre></td><td class="code"><pre><code class="hljs bash">Yukirin@DESKTOP-8BFBE1K:~$ <span class="hljs-built_in">type</span> ll<br>ll is aliased to `<span class="hljs-built_in">ls</span> -alF<span class="hljs-string">&#x27;  </span><br></code></pre></td></tr></table></figure><p>我这里定义为 <code>-alF</code> ，给文件名加了类型标记。你也可以自己组合参数进行定义。</p><p>这里讲讲关于 <code>ls -alh</code> 打印出来的各项的含义</p><figure class="highlight bash"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br></pre></td><td class="code"><pre><code class="hljs bash">-rw-rw-r--  1  Yukirin Yukirin  153  Sep 26 15:52  file1.txt<br>│           │  │       │        │    │             │<br>│           │  │       │        │    │             └─ 文件名<br>│           │  │       │        │    └─ 最近一次修改时间<br>│           │  │       │        └─ 大小（字节）<br>│           │  │       └─ 所属组<br>│           │  └─ 所有者<br>│           └─ 硬链接计数<br>└─ 权限<br></code></pre></td></tr></table></figure></li><li><p><code>tree</code>：<strong>树状图显示目录结构</strong></p><figure class="highlight bash"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br></pre></td><td class="code"><pre><code class="hljs bash">tree                <span class="hljs-comment"># 递归显示</span><br>tree -L 1           <span class="hljs-comment"># 只显示 1 层</span><br>tree -L 2           <span class="hljs-comment"># 显示 2 层</span><br>tree -d             <span class="hljs-comment"># 只显示目录</span><br>tree -a             <span class="hljs-comment"># 显示隐藏文件</span><br>tree -h             <span class="hljs-comment"># 显示大小</span><br></code></pre></td></tr></table></figure><p><code>tree</code>命令可能并没有自带，如果使用<code>tree</code>提示找不到该命令，那么使用下列命令进行安装</p><figure class="highlight bash"><table><tr><td class="gutter"><pre><span class="line">1</span><br></pre></td><td class="code"><pre><code class="hljs bash"><span class="hljs-built_in">sudo</span> apt install tree<br></code></pre></td></tr></table></figure><p><code>tree</code>命令效果如下，在查看文件和目录时还是很方便的。</p><figure class="highlight bash"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br></pre></td><td class="code"><pre><code class="hljs bash">Yukirin@DESKTOP-8BFBE1K:~$ tree<br>.<br>├── C_Test<br>│   └── new.c<br>├── Untitled<br>├── WSL-Neovim排查记录.md<br>├── snap<br>│   └── glow<br>│       ├── 90<br>│       ├── common<br>│       └── current -&gt; 90<br></code></pre></td></tr></table></figure></li><li><p><code>mkdir</code>：<strong>目录创建</strong></p><figure class="highlight bash"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br></pre></td><td class="code"><pre><code class="hljs bash"><span class="hljs-built_in">mkdir</span> <span class="hljs-built_in">test</span>                  <span class="hljs-comment"># 创建单个目录</span><br><span class="hljs-built_in">mkdir</span> dir1 dir2 dir3        <span class="hljs-comment"># 创建多个目录</span><br><span class="hljs-built_in">mkdir</span> -p a/b/c              <span class="hljs-comment"># 递归创建多级目录</span><br><span class="hljs-built_in">mkdir</span> -m 755 <span class="hljs-built_in">test</span>           <span class="hljs-comment"># 创建时指定权限</span><br></code></pre></td></tr></table></figure><p>这里讲一下：父目录不存在，递归创建时必须带上 <code>-p</code> 参数。直接使用 <code>mkdir dir1/dir2/dir3</code> 是创建不了的</p><figure class="highlight bash"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br></pre></td><td class="code"><pre><code class="hljs bash">Yukirin@DESKTOP-8BFBE1K:~$ <span class="hljs-built_in">mkdir</span> dir1/dir2/dir3<br><span class="hljs-built_in">mkdir</span>: No such file or directory<br><br>Yukirin@DESKTOP-8BFBE1K:~$ <span class="hljs-built_in">mkdir</span> -p dir1/dir2/dir3<br>Yukirin@DESKTOP-8BFBE1K:~$ tree<br>├── dir1<br>│   └── dir2<br>│       └── dir3<br></code></pre></td></tr></table></figure><p>关于创建时指定权限：这里的 755 是<strong>八进制权限码</strong>，每一位对应一类用户的使用权限。</p><p>7-5-5 三位分别代表：</p><table><thead><tr><th align="left">位置</th><th align="left">对应对象</th><th align="left">英文</th></tr></thead><tbody><tr><td align="left">第 1 位</td><td align="left">文件所有者</td><td align="left">user (u)</td></tr><tr><td align="left">第 2 位</td><td align="left">所属组</td><td align="left">group (g)</td></tr><tr><td align="left">第 3 位</td><td align="left">其他人</td><td align="left">others (o)</td></tr></tbody></table><p>3位数字的各自计算方法：</p><table><thead><tr><th align="left">数字</th><th align="left">权限</th><th align="left">含义</th></tr></thead><tbody><tr><td align="left">0</td><td align="left"><code>---</code></td><td align="left">无权限</td></tr><tr><td align="left">1</td><td align="left"><code>--x</code></td><td align="left">只可执行</td></tr><tr><td align="left">2</td><td align="left"><code>-w-</code></td><td align="left">只可写</td></tr><tr><td align="left">3</td><td align="left"><code>-wx</code></td><td align="left">可写+执行</td></tr><tr><td align="left">4</td><td align="left"><code>r--</code></td><td align="left">只可读</td></tr><tr><td align="left">5</td><td align="left"><code>r-x</code></td><td align="left">可读+执行</td></tr><tr><td align="left">6</td><td align="left"><code>rw-</code></td><td align="left">可读+可写</td></tr><tr><td align="left">7</td><td align="left"><code>rwx</code></td><td align="left">全部权限</td></tr></tbody></table><p>所以755在这里表示：</p><figure class="highlight bash"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br></pre></td><td class="code"><pre><code class="hljs bash">7        5        5<br>rwx      r-x      r-x<br>所有者    组       其他人<br></code></pre></td></tr></table></figure><p>需要时直接查表算就行了。其实<code>mkdir</code>在指定权限时也支持符号写法：</p><figure class="highlight bash"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br></pre></td><td class="code"><pre><code class="hljs bash"><span class="hljs-built_in">mkdir</span> -m u=rwx,g=rx,o=rx <span class="hljs-built_in">test</span>    <span class="hljs-comment"># 等价于 755</span><br><span class="hljs-built_in">mkdir</span> -m a=rwx <span class="hljs-built_in">test</span>              <span class="hljs-comment"># a=所有人，等价于 777</span><br></code></pre></td></tr></table></figure><p>这些写法都是等价的，符号写法规律很明显，不用查表算数字，我比较喜欢这种方法；不过数字写法速度快，背下常规几种组合之后直接用就行。</p></li><li><p><code>rmdir</code>：<strong>空目录删除</strong></p><figure class="highlight bash"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br></pre></td><td class="code"><pre><code class="hljs bash"><span class="hljs-built_in">rmdir</span> <span class="hljs-built_in">test</span>                  <span class="hljs-comment"># 删除空目录</span><br><span class="hljs-built_in">rmdir</span> -p a/b/c              <span class="hljs-comment"># 递归删除空目录（a/b/c 都为空时）</span><br></code></pre></td></tr></table></figure><p>这个命令只能删除空目录，若目录内部有文件将删除失败。删除带文件的目录应该用下文的<code>rm -r</code> 命令，<code>rmdir</code>不是很常用，了解一下。</p></li><li><p><code>touch</code>：<strong>文件创建</strong></p><figure class="highlight bash"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br></pre></td><td class="code"><pre><code class="hljs bash"><span class="hljs-built_in">touch</span> file.txt              <span class="hljs-comment"># 创建空文件</span><br><span class="hljs-built_in">touch</span> file1 file2           <span class="hljs-comment"># 创建多个</span><br><span class="hljs-built_in">touch</span> -c file.txt           <span class="hljs-comment"># 文件不存在时不创建</span><br><span class="hljs-built_in">touch</span> -a file.txt           <span class="hljs-comment"># 只更新访问时间</span><br><span class="hljs-built_in">touch</span> -m file.txt           <span class="hljs-comment"># 只更新修改时间</span><br><span class="hljs-built_in">touch</span> -t 202609260830 file  <span class="hljs-comment"># 指定时间戳：YYYYMMDDhhmm</span><br></code></pre></td></tr></table></figure><p>这里讲一个有意思的点：<code>touch</code>原意其实并不是创建文件，touch的英文是触摸，原本设计的目的是修改文件的时间戳。不过当touch的目标文件不存在时，会先创建一个新文件。后续慢慢的就都使用该命令来创建文件了。</p></li><li><p><code>rm</code>：<strong>删除文件或目录</strong></p><figure class="highlight bash"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br></pre></td><td class="code"><pre><code class="hljs bash"><span class="hljs-built_in">rm</span> file.txt                 <span class="hljs-comment"># 删除文件</span><br><span class="hljs-built_in">rm</span> -i file.txt              <span class="hljs-comment"># 删除前询问</span><br><span class="hljs-built_in">rm</span> -f file.txt              <span class="hljs-comment"># 强制删除，不询问</span><br><span class="hljs-built_in">rm</span> -r <span class="hljs-built_in">dir</span>                   <span class="hljs-comment"># 递归删除目录</span><br><span class="hljs-built_in">rm</span> -rf <span class="hljs-built_in">dir</span>                  <span class="hljs-comment"># 递归强制删除（危险！）</span><br><span class="hljs-built_in">rm</span> -v file.txt              <span class="hljs-comment"># 显示删除过程</span><br></code></pre></td></tr></table></figure><figure class="highlight bash"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br></pre></td><td class="code"><pre><code class="hljs bash">Yukirin@DESKTOP-8BFBE1K:~/work$ <span class="hljs-built_in">rm</span> -i a.out<br><span class="hljs-built_in">rm</span>: remove regular file <span class="hljs-string">&#x27;a.out&#x27;</span>? n<br>Yukirin@DESKTOP-8BFBE1K:~/work$ ll<br>total 36<br>-rwxrwxr-x 1 Yukirin Yukirin 16608 Sep 25 16:41 a.out*<br></code></pre></td></tr></table></figure><p>这里要提醒一下：<code>rm -rf /</code> 是删除整个root跟目录的自杀式命令，永远不要执行。现在的发行版基本都会拒绝<code>rm -rf /</code>这个命令，但是最好自己在上层加入一些防误操作保护，不要依赖内部实现。</p><p><code>-v</code>参数会在终端打印删除了什么。如果需要知道具体删除了哪些文件，可以带上该参数。</p><figure class="highlight bash"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br></pre></td><td class="code"><pre><code class="hljs bash">Yukirin@DESKTOP-8BFBE1K:~/work$ <span class="hljs-built_in">rm</span> -v -i a.out<br><span class="hljs-built_in">rm</span>: remove regular file <span class="hljs-string">&#x27;a.out&#x27;</span>? y<br>removed <span class="hljs-string">&#x27;a.out&#x27;</span><br></code></pre></td></tr></table></figure><p>可以给<code>rm</code>命令加上别名，带上确认与反馈机制，防止误操作。</p><figure class="highlight bash"><table><tr><td class="gutter"><pre><span class="line">1</span><br></pre></td><td class="code"><pre><code class="hljs bash"><span class="hljs-built_in">alias</span> <span class="hljs-built_in">rm</span>=<span class="hljs-string">&#x27;rm -i&#x27;</span><br></code></pre></td></tr></table></figure><p>上面我们提到，<code>rm -r</code> 可以用于删除带文件的目录，日常使用删除目录的命令基本都是使用这个。</p><p>这里关于 <code>rm -rf</code> 的使用要注意一下：<code>rm -rfv dir1/dir2/dir3</code> 执行这行命令之后只会删除<code>dir3</code>以及<code>dir3</code>的所有子级目录！而不是摘掉<code>dir1/dir2/dir3</code>整棵树，<code>dir1/dir2</code> 都还在。如果想要摘掉 <code>dir1/dir2/dir3</code> 整棵树应该使用 <code>rm -rfv dir1</code>。这个地方不弄清楚很容易用错。</p><figure class="highlight bash"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br></pre></td><td class="code"><pre><code class="hljs bash">Yukirin@DESKTOP-8BFBE1K:~$ tree dir1/<br>dir1/<br>├── dir2<br>│   ├── dir3<br>│   └── nana.lua<br>└── lala.lua<br><br>2 directories, 3 files<br>Yukirin@DESKTOP-8BFBE1K:~$ <span class="hljs-built_in">rm</span> -rfv dir1/<br>removed <span class="hljs-string">&#x27;dir1/dir2/nana.lua&#x27;</span><br>removed <span class="hljs-string">&#x27;dir1/dir2/dir3&#x27;</span><br>removed directory <span class="hljs-string">&#x27;dir1/dir2&#x27;</span><br>removed <span class="hljs-string">&#x27;dir1/lala.lua&#x27;</span><br>removed directory <span class="hljs-string">&#x27;dir1/&#x27;</span><br>Yukirin@DESKTOP-8BFBE1K:~$ find dir1<br>find: ‘dir1’: No such file or directory<br></code></pre></td></tr></table></figure></li><li><p><code>cp</code>：<strong>复制文件和目录</strong></p><figure class="highlight bash"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br></pre></td><td class="code"><pre><code class="hljs bash"><span class="hljs-built_in">cp</span> file1 file2              <span class="hljs-comment"># 复制文件</span><br><span class="hljs-built_in">cp</span> file1 <span class="hljs-built_in">dir</span>/               <span class="hljs-comment"># 复制到目录</span><br><span class="hljs-built_in">cp</span> -r dir1 dir2             <span class="hljs-comment"># 递归复制目录</span><br><span class="hljs-built_in">cp</span> -a dir1 dir2             <span class="hljs-comment"># 归档复制，保留权限、时间、链接</span><br><span class="hljs-built_in">cp</span> -p file1 file2           <span class="hljs-comment"># 保留权限和时间</span><br><span class="hljs-built_in">cp</span> -i file1 file2           <span class="hljs-comment"># 覆盖前询问</span><br><span class="hljs-built_in">cp</span> -u file1 file2           <span class="hljs-comment"># 仅当源更新时才复制</span><br><span class="hljs-built_in">cp</span> -v file1 file2           <span class="hljs-comment"># 显示过程</span><br></code></pre></td></tr></table></figure><figure class="highlight bash"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br></pre></td><td class="code"><pre><code class="hljs bash">Yukirin@DESKTOP-8BFBE1K:~/dir1$ <span class="hljs-built_in">cp</span> -vp /home/Yukirin/work/tcp_client.c ../dir1/<br><span class="hljs-string">&#x27;/home/Yukirin/work/tcp_client.c&#x27;</span> -&gt; <span class="hljs-string">&#x27;../dir1/tcp_client.c&#x27;</span><br>Yukirin@DESKTOP-8BFBE1K:~/dir1$ <span class="hljs-built_in">ls</span> /home/Yukirin/dir1/<br>dir2  tcp_client.c<br></code></pre></td></tr></table></figure><p><code>-i</code>参数可以在即将发生覆盖行为时提醒用户。<code>cp</code>默认覆盖是静默无声的，某些情况下可能会导致误冲刷重要文件，所以建议使用别名将 <code>cp -i</code> 封装起来使用。</p><p>Ps：<code>-r</code> 只做递归复制，属性和链接等等不做保留、而 <code>-a</code> 不仅可以递归复制，同时还保留<strong>权限、所有者、时间戳、符号链接、硬链接、扩展属性等</strong>，尽量做到一模一样。你可以这么理解：<code>-r</code> 只管内容一样，<code>-a</code> 则是原封不动整个文件包括属性一起打包带走。所以做备份时首选 <code>-a</code> 。</p><figure class="highlight bash"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br></pre></td><td class="code"><pre><code class="hljs bash">Yukirin@DESKTOP-8BFBE1K:~/dir1$ <span class="hljs-built_in">cp</span> -iv tcp_client.c tcp_back.c<br><span class="hljs-built_in">cp</span>: overwrite <span class="hljs-string">&#x27;tcp_back.c&#x27;</span>? y<br><span class="hljs-string">&#x27;tcp_client.c&#x27;</span> -&gt; <span class="hljs-string">&#x27;tcp_back.c&#x27;</span><br></code></pre></td></tr></table></figure></li><li><p><code>mv</code>：<strong>移动文件&#x2F;重命名</strong></p><figure class="highlight bash"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br></pre></td><td class="code"><pre><code class="hljs bash"><span class="hljs-built_in">mv</span> file1 file2              <span class="hljs-comment"># 重命名</span><br><span class="hljs-built_in">mv</span> file1 <span class="hljs-built_in">dir</span>/               <span class="hljs-comment"># 移动到目录</span><br><span class="hljs-built_in">mv</span> dir1 dir2                <span class="hljs-comment"># 重命名目录</span><br><span class="hljs-built_in">mv</span> -i file1 file2           <span class="hljs-comment"># 覆盖前询问</span><br><span class="hljs-built_in">mv</span> -f file1 file2           <span class="hljs-comment"># 强制覆盖</span><br><span class="hljs-built_in">mv</span> -v file1 file2           <span class="hljs-comment"># 显示过程</span><br><span class="hljs-built_in">mv</span> -u file1 file2           <span class="hljs-comment"># 仅当源更新时才移动</span><br></code></pre></td></tr></table></figure><p><code>mv</code>的用法和参数与<code>cp</code>是一样的。<code>cp</code>是复制，<code>mv</code>是剪切，知道这个就好。</p></li><li><p><code>file</code>：<strong>查看文件类型</strong></p><figure class="highlight bash"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br></pre></td><td class="code"><pre><code class="hljs bash">file file.txt               <span class="hljs-comment"># 文本文件</span><br>file image.png              <span class="hljs-comment"># PNG 图片</span><br>file /bin/ls                <span class="hljs-comment"># ELF 可执行文件</span><br></code></pre></td></tr></table></figure><p>例如：</p><figure class="highlight bash"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br></pre></td><td class="code"><pre><code class="hljs bash">Yukirin@DESKTOP-8BFBE1K:~/dir1$ file tcp_back.c<br>tcp_back.c: C <span class="hljs-built_in">source</span>, ASCII text<br></code></pre></td></tr></table></figure></li><li><p><code>stat</code>：<strong>查看文件详细数据</strong></p><figure class="highlight bash"><table><tr><td class="gutter"><pre><span class="line">1</span><br></pre></td><td class="code"><pre><code class="hljs bash"><span class="hljs-built_in">stat</span> file.txt<br></code></pre></td></tr></table></figure><p>能够看到文件大小、权限、访问时间、修改时间等等。</p><figure class="highlight bash"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br></pre></td><td class="code"><pre><code class="hljs bash">Yukirin@DESKTOP-8BFBE1K:~/dir1$ <span class="hljs-built_in">stat</span> tcp_back.c<br>  File: tcp_back.c<br>  size: 1739            Blocks: 8          IO Block: 4096   regular file<br>Device: 8,48    Inode: 79667       Links: 1<br>Access: (0664/-rw-rw-r--)  Uid: ( 1000/ Yukirin)   Gid: ( 1000/ Yukirin)<br>Access: 2026-09-26 14:11:45.248891782 +0800<br>Modify: 2026-09-26 12:02:43.217786645 +0800<br>Change: 2026-09-26 12:02:43.217786645 +0800<br> Birth: 2026-09-26 12:01:09.162633570 +0800<br></code></pre></td></tr></table></figure></li><li><p><code>ln</code>：<strong>创建链接</strong></p><figure class="highlight bash"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br></pre></td><td class="code"><pre><code class="hljs bash"><span class="hljs-built_in">ln</span> file1 file2              <span class="hljs-comment"># 硬链接</span><br><span class="hljs-built_in">ln</span> -s file1 file2           <span class="hljs-comment"># 软链接（符号链接）</span><br><span class="hljs-built_in">ln</span> -sf file1 file2          <span class="hljs-comment"># 强制创建软链接，覆盖已有</span><br><span class="hljs-built_in">ln</span> -si file1 file2          <span class="hljs-comment"># 覆盖前询问</span><br><span class="hljs-built_in">ln</span> -sv file1 file2          <span class="hljs-comment"># 显示过程</span><br></code></pre></td></tr></table></figure><p>创建链接分为<strong>硬链接</strong>和<strong>软链接</strong>。使用 <code>ln</code> 命令默认创建硬链接；使用 <code>ln -s</code> 创建软连接。</p><p>软链接有点类似Windows桌面的快捷方式，是一个独立的小文件，其内容是指向目标的路径。软连接有自己的inode，如果软连接指向的目标被删除，那么访问软连接时会报：<code>No such file or directory</code> 错误。这是符合常理的，我们在Windows中若快捷方式失活（通常是指向的源文件已被删除），访问也是会报找不到文件错误的。</p><p>硬链接inode是相同的，举个例子：假如原件为 source1，使用 <code>ln</code> 命令为其创建硬链接 <code>source2</code>、 <code>source3</code>，那么source1、source2、source3的inode全都是相同的。这点区别于软链接，我们上面提到过，软链接是一个独立小文件，有自己的inode。    </p><p>由于共享inode，硬链接相当于是给原数据上了份保险：上面示例中我们删除掉source1，源数据并不会受损，而这个特性是软链接做不到的。</p><p>这个特性你可以这么理解：我们删除数据时并不是从底层直接销毁数据，而是销毁其指向该部分内存的指针。我们创建了两个硬链接，就相当于多维护了两个指向该块数据的指针。当我们删除source1时，由于2和3仍指向该块数据，所以我们仍然能够获取这块内存，在上层体现出来的就是未被删掉。只有当我们将1、2、3全部删除时，这块数据才是真正丢了，体现在上层就是数据被删除。这就是硬链接的一个特定和优势。</p><p>这里要注意硬链接的两个限制：</p><ul><li><strong>不能跨文件系统（因为 inode 只在同一文件系统内唯一）</strong></li><li><strong>不能对目录创建硬链接</strong></li></ul><p>软链接没有这个限制。</p><p>上文一直在提到 <code>inode</code>，这里讲讲 <code>inode</code> 是怎么回事：inode全称为 index node(索引节点)，是Unix文件系统用来描述一个文件的数据结构。你可以把它理解为一个结构体，内部是所指文件的元数据——例如权限、文件大小、所有者、所属组、链接计数等。其内部还维护有指向文件数据块的指针。</p><p>总的来说 <strong>inode &#x3D; 描述数据的元数据结构体 + 指向数据块的索引</strong>。</p></li></ul><hr><h4 id="文件查看"><a href="#文件查看" class="headerlink" title="文件查看"></a>文件查看</h4><ul><li><p><code>cat</code>：<strong>打印输出整个文件</strong></p><figure class="highlight bash"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br></pre></td><td class="code"><pre><code class="hljs bash"><span class="hljs-built_in">cat</span> file.txt                <span class="hljs-comment"># 输出全部内容</span><br><span class="hljs-built_in">cat</span> -n file.txt             <span class="hljs-comment"># 显示行号（所有行）</span><br><span class="hljs-built_in">cat</span> -b file.txt             <span class="hljs-comment"># 显示行号（跳过空行）</span><br><span class="hljs-built_in">cat</span> -s file.txt             <span class="hljs-comment"># 连续空行压缩为一行</span><br><span class="hljs-built_in">cat</span> -A file.txt             <span class="hljs-comment"># 显示不可见字符（$ 表示行尾，^I 表示 Tab）</span><br><span class="hljs-built_in">cat</span> file1 file2             <span class="hljs-comment"># 拼接多个文件输出</span><br><span class="hljs-built_in">cat</span> file1 file2 &gt; merged    <span class="hljs-comment"># 合并写入新文件</span><br><span class="hljs-built_in">cat</span> &gt; file.txt              <span class="hljs-comment"># 从键盘输入，Ctrl+D 结束</span><br></code></pre></td></tr></table></figure><p>我们这里有如下两个示例文件</p><figure class="highlight bash"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br></pre></td><td class="code"><pre><code class="hljs bash">file1.txt<br>The quick brown fox jumps over the lazy dog.<br>This sentence contains every letter of the alphabet.<br>It is often used <span class="hljs-keyword">for</span> typing practice and font testing.<br><br>file2.txt<br>Linux 的 <span class="hljs-built_in">cat</span> 命令全称是 concatenate，意思是连接。<br>它最常见的用途是查看文件内容，也可以把多个文件拼在一起。<br>配合重定向符号，还能快速创建或追加文件。<br></code></pre></td></tr></table></figure><p>使用 <code>cat file1 file2</code> 拼接输出可以得到：</p><figure class="highlight bash"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br></pre></td><td class="code"><pre><code class="hljs bash">Yukirin@DESKTOP-8BFBE1K:~/docTest$ <span class="hljs-built_in">cat</span> file1.txt file2.txt<br>The quick brown fox jumps over the lazy dog.<br>This sentence contains every letter of the alphabet.<br>It is often used <span class="hljs-keyword">for</span> typing practice and font testing.<br>Linux 的 <span class="hljs-built_in">cat</span> 命令全称是 concatenate，意思是连接。<br>它最常见的用途是查看文件内容，也可以把多个文件拼在一起。<br>配合重定向符号，还能快速创建或追加文件。<br></code></pre></td></tr></table></figure><p>将拼接的输出创建为一个新文件 file3.txt</p><figure class="highlight bash"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br></pre></td><td class="code"><pre><code class="hljs bash">Yukirin@DESKTOP-8BFBE1K:~/docTest$ <span class="hljs-built_in">cat</span> file1.txt file2.txt &gt; file3.txt<br>Yukirin@DESKTOP-8BFBE1K:~/docTest$ <span class="hljs-built_in">cat</span> file3.txt<br>The quick brown fox jumps over the lazy dog.<br>This sentence contains every letter of the alphabet.<br>It is often used <span class="hljs-keyword">for</span> typing practice and font testing.<br>Linux 的 <span class="hljs-built_in">cat</span> 命令全称是 concatenate，意思是连接。<br>它最常见的用途是查看文件内容，也可以把多个文件拼在一起。<br>配合重定向符号，还能快速创建或追加文件。<br></code></pre></td></tr></table></figure><p>使用 <code>cat &gt; 文件</code> 命令可以创建一个新文件，并且文件内容为你在终端输入的内容。输入完毕后 <code>Ctrl+D</code> 落盘。</p><p>一般小文件使用<code>cat</code>方便快速查看和编辑，对于大文件不要使用<code>cat</code>，会刷屏。如果不慎刷屏使用 <code>Ctrl+C</code> 强行终止本轮调用。</p></li><li><p><code>less</code>：<strong>分页查看</strong></p><figure class="highlight bash"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br></pre></td><td class="code"><pre><code class="hljs bash">less file.txt               <span class="hljs-comment"># 打开文件</span><br>less +F file.txt            <span class="hljs-comment"># 实时跟踪（类似 tail -f）</span><br>less -N file.txt            <span class="hljs-comment"># 显示行号</span><br>less -S file.txt            <span class="hljs-comment"># 不换行，超长行横向滚动</span><br>less -i file.txt            <span class="hljs-comment"># 搜索时忽略大小写</span><br></code></pre></td></tr></table></figure><p>分页查看用于日常查看大文件，内部支持简单的文本搜索功能，可以当作是一个简易的记事本。</p><p>进入分页模式后有如下几个常用命令：</p><table><thead><tr><th align="left">按键</th><th align="left">功能</th></tr></thead><tbody><tr><td align="left"><code>空格</code> &#x2F; <code>PageDown</code></td><td align="left">下一页</td></tr><tr><td align="left"><code>b</code> &#x2F; <code>PageUp</code></td><td align="left">上一页</td></tr><tr><td align="left"><code>g</code></td><td align="left">跳到文件头</td></tr><tr><td align="left"><code>G</code></td><td align="left">跳到文件尾</td></tr><tr><td align="left"><code>/pattern</code></td><td align="left">向下搜索</td></tr><tr><td align="left"><code>?pattern</code></td><td align="left">向上搜索</td></tr><tr><td align="left"><code>n</code></td><td align="left">下一个匹配</td></tr><tr><td align="left"><code>N</code></td><td align="left">上一个匹配</td></tr><tr><td align="left"><code>q</code></td><td align="left">退出</td></tr><tr><td align="left"><code>F</code></td><td align="left">进入实时跟踪模式（<code>Ctrl+C</code> 退出）</td></tr></tbody></table><p>注意：这里<code>less</code>的默认搜索是<strong>大小写敏感</strong>的，大小写输入错误是匹配不到的；如果不需要大小写敏感，可以使用<code>less -I</code> 打开文件。参数搜索栏支持基本的正则表达式，以下的形式都是可以的：</p><figure class="highlight bash"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br></pre></td><td class="code"><pre><code class="hljs bash">/^Error          <span class="hljs-comment"># 以 Error 开头的行</span><br>/error$          <span class="hljs-comment"># 以 error 结尾的行</span><br>/foo.*bar        <span class="hljs-comment"># foo 后跟任意字符再到 bar</span><br>/[0-9]\+         <span class="hljs-comment"># 一个或多个数字（注意 + 号要转义）</span><br></code></pre></td></tr></table></figure><p>搜索特殊字符时要记得转义，例如搜索&#x2F;本身要用：<code>/\/</code>。此处给一个文本中搜索IP地址的示例：</p><figure class="highlight bash"><table><tr><td class="gutter"><pre><span class="line">1</span><br></pre></td><td class="code"><pre><code class="hljs bash">/[0-9]\+\.[0-9]\+\.[0-9]\+\.[0-9]\+<br></code></pre></td></tr></table></figure></li><li><p><code>head</code>：<strong>查看文件开头</strong></p><figure class="highlight bash"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br></pre></td><td class="code"><pre><code class="hljs bash"><span class="hljs-built_in">head</span> file.txt               <span class="hljs-comment"># 默认前 10 行</span><br><span class="hljs-built_in">head</span> -n 20 file.txt         <span class="hljs-comment"># 前 20 行</span><br><span class="hljs-built_in">head</span> -n -5 file.txt         <span class="hljs-comment"># 除了最后 5 行，全部显示</span><br><span class="hljs-built_in">head</span> -c 100 file.txt        <span class="hljs-comment"># 前 100 字节</span><br><span class="hljs-built_in">head</span> -q file1 file2         <span class="hljs-comment"># 多文件时不显示文件名</span><br></code></pre></td></tr></table></figure><p>使用演示示例如下(还是以上文 file1.txt file2.txt 为例)：</p><figure class="highlight bash"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br><span class="line">19</span><br><span class="line">20</span><br><span class="line">21</span><br><span class="line">22</span><br><span class="line">23</span><br><span class="line">24</span><br><span class="line">25</span><br><span class="line">26</span><br><span class="line">27</span><br><span class="line">28</span><br><span class="line">29</span><br><span class="line">30</span><br><span class="line">31</span><br><span class="line">32</span><br><span class="line">33</span><br><span class="line">34</span><br></pre></td><td class="code"><pre><code class="hljs bash">Yukirin@DESKTOP-8BFBE1K:~/docTest$ <span class="hljs-built_in">cat</span> file1.txt<br>The quick brown fox jumps over the lazy dog.<br>This sentence contains every letter of the alphabet.<br>It is often used <span class="hljs-keyword">for</span> typing practice and font testing.<br><br>Yukirin@DESKTOP-8BFBE1K:~/docTest$ <span class="hljs-built_in">head</span> -n 1 file1.txt<br>The quick brown fox jumps over the lazy dog.<br><br>Yukirin@DESKTOP-8BFBE1K:~/docTest$ <span class="hljs-built_in">head</span> -n -1 file1.txt<br>The quick brown fox jumps over the lazy dog.<br>This sentence contains every letter of the alphabet.<br><br>Yukirin@DESKTOP-8BFBE1K:~/docTest$ <span class="hljs-built_in">head</span> -c 30 file1.txt<br>The quick brown fox jumps over<br><br>Yukirin@DESKTOP-8BFBE1K:~/docTest$ <span class="hljs-built_in">head</span> file1.txt file2.txt<br>==&gt; file1.txt &lt;==<br>The quick brown fox jumps over the lazy dog.<br>This sentence contains every letter of the alphabet.<br>It is often used <span class="hljs-keyword">for</span> typing practice and font testing.<br><br>==&gt; file2.txt &lt;==<br>Linux 的 <span class="hljs-built_in">cat</span> 命令全称是 concatenate，意思是连接。<br>它最常见的用途是查看文件内容，也可以把多个文件拼在一起。<br>配合重定向符号，还能快速创建或追加文件。<br><br>Yukirin@DESKTOP-8BFBE1K:~/docTest$ <span class="hljs-built_in">head</span> -n 2 file1.txt file2.txt<br>==&gt; file1.txt &lt;==<br>The quick brown fox jumps over the lazy dog.<br>This sentence contains every letter of the alphabet.<br><br>==&gt; file2.txt &lt;==<br>Linux 的 <span class="hljs-built_in">cat</span> 命令全称是 concatenate，意思是连接。<br>它最常见的用途是查看文件内容，也可以把多个文件拼在一起。<br></code></pre></td></tr></table></figure></li><li><p><code>tail</code>：<strong>查看文件尾部</strong></p><figure class="highlight bash"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br></pre></td><td class="code"><pre><code class="hljs bash"><span class="hljs-built_in">tail</span> file.txt               <span class="hljs-comment"># 默认后 10 行</span><br><span class="hljs-built_in">tail</span> -n 20 file.txt         <span class="hljs-comment"># 后 20 行</span><br><span class="hljs-built_in">tail</span> -n +5 file.txt         <span class="hljs-comment"># 从第 5 行开始，显示到末尾</span><br><span class="hljs-built_in">tail</span> -c 100 file.txt        <span class="hljs-comment"># 后 100 字节</span><br><span class="hljs-built_in">tail</span> -f log.txt             <span class="hljs-comment"># 实时跟踪新增内容（最常用！）</span><br><span class="hljs-built_in">tail</span> -F log.txt             <span class="hljs-comment"># 跟踪文件，文件被删除重建后继续跟踪</span><br><span class="hljs-built_in">tail</span> -f -n 100 log.txt      <span class="hljs-comment"># 先显示后 100 行，再实时跟踪</span><br></code></pre></td></tr></table></figure><p>该命令用法与<code>head</code>是一样的，此处不做过多阐述。这里讲讲什么叫实时跟踪：<code>tail -f</code>或 <code>tail -F</code> 可以启用实时跟踪功能。实时跟踪指的是，<strong>文件内容在增长时，终端自动跟随显示最新的追加内容</strong>。</p><p>例如我们使用 <code>tail -f log.txt</code> 监控日志文件，该条命令被执行后终端立即被挂起。当应用程序产生新日志并且写入到 <code>log.txt</code> 中时，终端会立即显示出来。</p><p><code>-f / -F</code> 两个参数都是开启文件跟踪，区别在于-f跟踪的是文件描述符，当文件移走后（例如该文件日志已满，需要mv到别的地方，并在原地重新创建新日志文件），-f跟踪的是旧文件，看不到新文件。</p><p>而-F跟踪的是文件名，所以旧文件移走并原地创建新文件后能够继续跟踪，而不会跟丢。日常看日志用 <code>-f</code>，如果日志会被轮转，移走重建，用 <code>-F</code> 更稳妥。</p></li><li><p><code>wc</code>：<strong>统计文件行数、字数、字节数</strong></p><figure class="highlight bash"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br></pre></td><td class="code"><pre><code class="hljs bash"><span class="hljs-built_in">wc</span> file.txt                 <span class="hljs-comment"># 输出：行数 单词数 字节数</span><br><span class="hljs-built_in">wc</span> -l file.txt              <span class="hljs-comment"># 只统计行数（最常用）</span><br><span class="hljs-built_in">wc</span> -w file.txt              <span class="hljs-comment"># 只统计单词数</span><br><span class="hljs-built_in">wc</span> -c file.txt              <span class="hljs-comment"># 只统计字节数</span><br><span class="hljs-built_in">wc</span> -m file.txt              <span class="hljs-comment"># 只统计字符数</span><br><span class="hljs-built_in">wc</span> -L file.txt              <span class="hljs-comment"># 最长行的长度</span><br><span class="hljs-built_in">ls</span> | <span class="hljs-built_in">wc</span> -l                  <span class="hljs-comment"># 统计当前目录文件数</span><br></code></pre></td></tr></table></figure><p>示例如下：</p><figure class="highlight bash"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br></pre></td><td class="code"><pre><code class="hljs bash">Yukirin@DESKTOP-8BFBE1K:~/docTest$ <span class="hljs-built_in">wc</span> file3.txt<br>  6  34 362 file3.txt<br></code></pre></td></tr></table></figure><p>输出从左至右分别为：该文件内容行数、单词数、总字节数。</p><p>这里讲讲 <code>wc -c</code> 与 <code>wc -m</code> 的区别：-c统计的是字节，-m统计的是字符。在全英文文本的情况下，二者是等价的，但是对于中文或其它语言等多字节字符时就完全不同。举个例子：文件1内容为：“Hello,World”，通过<code>wc -c</code> 或 <code>wc -m</code> 统计出来都是 11 个字节&#x2F;字符；文件2内容为：“你好世界”，由于中文字符为宽字符，UTF8中通常占3个字节，因此 <code>wc -c</code> 统计出来应为12个字节，<code>wc -m</code> 统计出来应为4个字符。这就是二者的差别。</p><p><code>wc -m</code> 的解析依赖当前的locale编码来判断一个字符是几个字节，如果locale没设置对那么 -m 计算出的字符数就是不准确的，这里要注意。</p></li><li><p><code>du</code>：<strong>查看文件及目录的磁盘占用空间</strong></p><figure class="highlight bash"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br></pre></td><td class="code"><pre><code class="hljs bash"><span class="hljs-built_in">du</span> file.txt                 <span class="hljs-comment"># 文件占用（块单位）</span><br><span class="hljs-built_in">du</span> -h file.txt              <span class="hljs-comment"># 人类可读（KB/MB/GB）</span><br><span class="hljs-built_in">du</span> -sh <span class="hljs-built_in">dir</span>/                 <span class="hljs-comment"># 目录总大小（最常用）</span><br><span class="hljs-built_in">du</span> -sh *                    <span class="hljs-comment"># 当前目录下每个文件/目录大小</span><br><span class="hljs-built_in">du</span> -h --max-depth=1         <span class="hljs-comment"># 只显示 1 层深度</span><br><span class="hljs-built_in">du</span> -ah <span class="hljs-built_in">dir</span>/                 <span class="hljs-comment"># 包含所有文件</span><br></code></pre></td></tr></table></figure><p>这里在使用时可能你会发现一个统计问题（还是以上述file1&#x2F;2&#x2F;3.txt为例）：</p><figure class="highlight bash"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br></pre></td><td class="code"><pre><code class="hljs bash">Yukirin@DESKTOP-8BFBE1K:~/docTest$ <span class="hljs-built_in">ls</span> -alh<br>-rw-rw-r--  1 Yukirin Yukirin  153 Sep 26 15:52 file1.txt<br>-rw-rw-r--  1 Yukirin Yukirin  209 Sep 26 15:52 file2.txt<br>-rw-rw-r--  1 Yukirin Yukirin  362 Sep 26 16:05 file3.txt<br><br>Yukirin@DESKTOP-8BFBE1K:~/docTest$ <span class="hljs-built_in">du</span> -sh *<br>4.0K    file1.txt<br>4.0K    file2.txt<br>4.0K    file3.txt<br><br>Yukirin@DESKTOP-8BFBE1K:~/docTest$ <span class="hljs-built_in">cd</span> ..<br>Yukirin@DESKTOP-8BFBE1K:~$ <span class="hljs-built_in">du</span> -sh docTest/<br>16K     docTest/<br></code></pre></td></tr></table></figure><p>发现了吗？我们文件大小为 153&#x2F;209&#x2F;362，通过磁盘占用统计出来竟然是4Kb？这里要强调一下：<code>du</code>的占用统计是从磁盘的角度来计算的，而磁盘是由簇和扇区构成的，簇是整个文件系统最小的分配单位，而簇又由多个扇区构成。目前我们的几个文件都只有几百字节，大小是很小的，但是依然需要占用一个簇和其中一个扇区，所以统计出来才为4Kb。这也侧面说明我们当前这个系统的文件系统最小扇区为4.0Kb。</p></li><li><p><code>df</code>：<strong>查看磁盘分区使用情况</strong></p><figure class="highlight bash"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br></pre></td><td class="code"><pre><code class="hljs bash"><span class="hljs-built_in">df</span> -h                       <span class="hljs-comment"># 人类可读（最常用）</span><br><span class="hljs-built_in">df</span> -h /home                 <span class="hljs-comment"># 只看指定挂载点</span><br><span class="hljs-built_in">df</span> -i                       <span class="hljs-comment"># 查看 inode 使用情况</span><br><span class="hljs-built_in">df</span> -T                       <span class="hljs-comment"># 显示文件系统类型</span><br></code></pre></td></tr></table></figure><p>这里要分清 <code>du/df</code> 的区别：<code>du</code>是针对单个文件以及目录进行磁盘占用统计，而<code>df</code>是从宏观上针对整个磁盘进行统计。</p></li><li><p><code>hexdump</code>：<strong>十六进制查看</strong></p><figure class="highlight bash"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br></pre></td><td class="code"><pre><code class="hljs bash">hexdump -C file.bin         <span class="hljs-comment"># 标准十六进制 + ASCII（最常用）</span><br>hexdump -C -n 64 file.bin   <span class="hljs-comment"># 只看前 64 字节</span><br>hexdump -C -s 128 file.bin  <span class="hljs-comment"># 从偏移 128 开始</span><br></code></pre></td></tr></table></figure><p>这是Linux用来以16进制查看文件的原生工具，在平时分析一些协议时也很常用。默认情况下每行输出16字节，半字分组。最左侧是偏移量，中间是数据内容：</p><figure class="highlight bash"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br></pre></td><td class="code"><pre><code class="hljs bash">Yukirin@DESKTOP-8BFBE1K:~/docTest$ hexdump file3.txt<br>0000000 6854 2065 7571 6369 206b 7262 776f 206e<br>0000010 6f66 2078 756a 706d 2073 766f 7265 7420<br>0000020 6568 6c20 7a61 2079 6f64 2e67 540a 6968<br>....<br></code></pre></td></tr></table></figure><p>不过这种方式不太直观，可以使用 <code>hexdump -C</code> 将其拆成标准16进制格式。</p><figure class="highlight bash"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br></pre></td><td class="code"><pre><code class="hljs bash">Yukirin@DESKTOP-8BFBE1K:~/docTest$ hexdump -C file3.txt<br>00000000  54 68 65 20 71 75 69 63  6b 20 62 72 6f 77 6e 20  |The quick brown |<br>00000010  66 6f 78 20 6a 75 6d 70  73 20 6f 76 65 72 20 74  |fox jumps over t|<br>00000020  68 65 20 6c 61 7a 79 20  64 6f 67 2e 0a 54 68 69  |he lazy dog..Thi|<br></code></pre></td></tr></table></figure><figure class="highlight bash"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br></pre></td><td class="code"><pre><code class="hljs bash">00000000  54 68 65 20 71 75 69 63  6b 20 62 72 ...         |Hello World.|<br>│         │                        │                       │<br>│         │                        │                       └─ ASCII 显示<br>│         │                        └─ 后8个字节<br>│         └─ 前8个字节<br>└─ 偏移量（十六进制!）<br></code></pre></td></tr></table></figure><p>不过<code>hexdump</code>不只可以看16进制，也可以其它进制的方式进行查看。其命令参数如下所示：</p><table><thead><tr><th align="left">选项</th><th align="left">作用</th></tr></thead><tbody><tr><td align="left"><code>-C</code></td><td align="left">规范 hex + ASCII</td></tr><tr><td align="left"><code>-b</code></td><td align="left">每字节显示为<strong>八进制</strong></td></tr><tr><td align="left"><code>-c</code></td><td align="left">每字节显示为<strong>字符</strong>（转义形式）</td></tr><tr><td align="left"><code>-d</code></td><td align="left">每字节显示为<strong>十进制</strong></td></tr><tr><td align="left"><code>-o</code></td><td align="left">每字节显示为<strong>八进制</strong>（两位）</td></tr><tr><td align="left"><code>-x</code></td><td align="left">每字节显示为<strong>十六进制</strong></td></tr><tr><td align="left"><code>-n N</code></td><td align="left">只显示<strong>前 N 字节</strong></td></tr><tr><td align="left"><code>-s N</code></td><td align="left"><strong>跳过</strong>前 N 字节再显示</td></tr><tr><td align="left"><code>-v</code></td><td align="left">不省略重复行（默认连续相同行会显示 <code>*</code>）</td></tr></tbody></table></li><li><p><code>xxd</code>：<strong>十六进制查看</strong></p><figure class="highlight bash"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br></pre></td><td class="code"><pre><code class="hljs bash">xxd file.bin                <span class="hljs-comment"># 十六进制 + ASCII</span><br>xxd -l 64 file.bin          <span class="hljs-comment"># 前 64 字节</span><br>xxd -s 128 file.bin         <span class="hljs-comment"># 从偏移 128 开始</span><br>xxd -r hex.txt &gt; file.bin   <span class="hljs-comment"># 反向：十六进制文本还原为二进制</span><br></code></pre></td></tr></table></figure><p>这个命令与上面的<code>hexdump</code>是高度重合的。区别在于，<code>hexdump</code>是系统原装的，而<code>xxd</code>是vim编辑器的附件工具包。如果你没有装Vim的话可能没有这个工具。xxd有反色显示，我个人比较喜欢xxd的观感，所以常用xxd。</p><p><code>xxd</code>还有个<code>hexdump</code>做不到的特性，那就是能够进行反向还原：将16进制重新还原回2进制。</p><figure class="highlight bash"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br></pre></td><td class="code"><pre><code class="hljs bash">xxd file.bin &gt; dump.txt        <span class="hljs-comment"># 导出为文本</span><br>xxd -r dump.txt &gt; back.bin     <span class="hljs-comment"># 从文本还原为二进制</span><br></code></pre></td></tr></table></figure><p><code>hexdump</code>没有这个功能，所以在做二进制&lt;-&gt;文本转换时使用<code>xxd</code>。</p></li><li><p><code>grep</code>：<strong>文本搜索</strong></p><figure class="highlight bash"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br></pre></td><td class="code"><pre><code class="hljs bash">grep <span class="hljs-string">&quot;error&quot;</span> log.txt            <span class="hljs-comment"># 搜索包含 error 的行</span><br>grep -i <span class="hljs-string">&quot;error&quot;</span> log.txt         <span class="hljs-comment"># 忽略大小写</span><br>grep -n <span class="hljs-string">&quot;error&quot;</span> log.txt         <span class="hljs-comment"># 显示行号</span><br>grep -v <span class="hljs-string">&quot;error&quot;</span> log.txt         <span class="hljs-comment"># 反向：不包含 error 的行</span><br>grep -c <span class="hljs-string">&quot;error&quot;</span> log.txt         <span class="hljs-comment"># 统计匹配行数</span><br>grep -r <span class="hljs-string">&quot;error&quot;</span> <span class="hljs-built_in">dir</span>/            <span class="hljs-comment"># 递归搜索目录</span><br>grep -rn <span class="hljs-string">&quot;error&quot;</span> <span class="hljs-built_in">dir</span>/           <span class="hljs-comment"># 递归 + 行号</span><br>grep -w <span class="hljs-string">&quot;error&quot;</span> log.txt         <span class="hljs-comment"># 只匹配整词</span><br>grep -A 3 <span class="hljs-string">&quot;error&quot;</span> log.txt       <span class="hljs-comment"># 显示匹配行及后 3 行</span><br>grep -B 3 <span class="hljs-string">&quot;error&quot;</span> log.txt       <span class="hljs-comment"># 显示匹配行及前 3 行</span><br>grep -C 3 <span class="hljs-string">&quot;error&quot;</span> log.txt       <span class="hljs-comment"># 前后各 3 行</span><br>grep -E <span class="hljs-string">&quot;err|warn&quot;</span> log.txt      <span class="hljs-comment"># 扩展正则（或）</span><br>grep -l <span class="hljs-string">&quot;error&quot;</span> *.txt           <span class="hljs-comment"># 只显示匹配的文件名</span><br></code></pre></td></tr></table></figure><p>grep是Linux中最常用的搜索工具。使用场景十分广泛，例如我要在某个文件或某几个文件中找内容：</p><figure class="highlight bash"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br></pre></td><td class="code"><pre><code class="hljs bash">grep <span class="hljs-string">&quot;error&quot;</span> app.log<br>grep -n <span class="hljs-string">&quot;TODO&quot;</span> *.c          <span class="hljs-comment"># -n 显示行号</span><br></code></pre></td></tr></table></figure><p>再或者配合管道，从输出中过滤出需要的内容：</p><figure class="highlight bash"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br></pre></td><td class="code"><pre><code class="hljs bash">ps aux | grep nginx         <span class="hljs-comment"># 找 nginx 进程</span><br><span class="hljs-built_in">ls</span> -alh | grep <span class="hljs-string">&quot;.txt&quot;</span>       <span class="hljs-comment"># 只看 txt 文件</span><br><span class="hljs-built_in">df</span> -h | grep <span class="hljs-string">&quot;/dev/sda&quot;</span>     <span class="hljs-comment"># 只看某个磁盘</span><br></code></pre></td></tr></table></figure><p><code>grep</code>还有个很强大的地方是支持基本正则表达式(BRE)和拓展正则表达式(ERE)，如果会用正则的话那么<code>grep</code>将非常高效和强大：</p><figure class="highlight bash"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br></pre></td><td class="code"><pre><code class="hljs bash">grep <span class="hljs-string">&quot;^Error&quot;</span> app.log          <span class="hljs-comment"># 以 Error 开头</span><br>grep <span class="hljs-string">&quot;done$&quot;</span> app.log           <span class="hljs-comment"># 以 done 结尾</span><br>grep -E <span class="hljs-string">&quot;error|fail|warn&quot;</span> app.log   <span class="hljs-comment"># 匹配多个词之一</span><br>grep -E <span class="hljs-string">&quot;[0-9]&#123;3&#125;-[0-9]&#123;4&#125;&quot;</span> file    <span class="hljs-comment"># 电话格式</span><br>grep <span class="hljs-string">&quot;colou\?r&quot;</span> file           <span class="hljs-comment"># 注意 ? 号转义</span><br></code></pre></td></tr></table></figure></li></ul><h4 id="查找与定位"><a href="#查找与定位" class="headerlink" title="查找与定位"></a>查找与定位</h4>]]>
    </content>
    <id>https://r6blog.online/2026/09/26/%E5%B5%8C%E5%85%A5%E5%BC%8F2026092601/</id>
    <link href="https://r6blog.online/2026/09/26/%E5%B5%8C%E5%85%A5%E5%BC%8F2026092601/"/>
    <published>2026-09-26T01:28:47.000Z</published>
    <summary>
      <![CDATA[<h4 id="前言"><a href="#前言" class="headerlink" title="前言"></a>前言</h4><p>本篇文章用于记录一些Linux系统中的常用操作命令。Linux的命令系统是十分强大和复杂的，为了能够熟练进行系统操作，在这里归档一些常用命令]]>
    </summary>
    <title>Linux 常用命令归档</title>
    <updated>2026-10-08T07:15:10.247Z</updated>
  </entry>
  <entry>
    <author>
      <name>R6bandito</name>
    </author>
    <category term="杂项" scheme="https://r6blog.online/categories/%E6%9D%82%E9%A1%B9/"/>
    <category term="Note" scheme="https://r6blog.online/tags/Note/"/>
    <category term="Linux" scheme="https://r6blog.online/tags/Linux/"/>
    <content>
      <![CDATA[<h4 id="现象及原因"><a href="#现象及原因" class="headerlink" title="现象及原因"></a>现象及原因</h4><p>环境: WSL2 + Ubuntu(26.04)。在环境中装好LazyVim插件后，发现编辑器的智能补全功能并不完善，C头文件以及相关函数不能够在补全菜单中显示。经查，是我系统虽然安装了<code>clangd</code>等前置，但LazyVim并不会直接使用系统里安装的工具，而是通过Mason包管理工具来链接外部工具。具体来说：LazyVim的默认策略是不直接启用这类语言服务器，而是把启用工作交给Mason系的组件；而Mason系只认自己安装的服务器。我的<code>clangd</code>是apt装在系统里的，Mason管理的指定位置里并没有它——两头都不认，所以尽管系统已经正确安装clangd，却谁都没有把它启用起来，该功能也就失效了。</p><h4 id="解决方法"><a href="#解决方法" class="headerlink" title="解决方法"></a>解决方法</h4><ul><li>首先应该确保在系统中正确安装开发环境：</li></ul><figure class="highlight bash"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br></pre></td><td class="code"><pre><code class="hljs bash">gcc --version<br>make --version<br>ld --version<br></code></pre></td></tr></table></figure><p>并补一条真实编译测试：</p><figure class="highlight bash"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br></pre></td><td class="code"><pre><code class="hljs bash"><span class="hljs-built_in">printf</span> <span class="hljs-string">&#x27;#include &lt;stdio.h&gt;\nint main(void)&#123;return 0;&#125;\n&#x27;</span> &gt; /tmp/t.c \<br>  &amp;&amp; gcc /tmp/t.c -o /tmp/t.bin &amp;&amp; /tmp/t.bin &amp;&amp; <span class="hljs-built_in">echo</span> <span class="hljs-string">&quot;编译链 OK&quot;</span><br></code></pre></td></tr></table></figure><p>确保基础编译工具链已被正确安装，若未安装请使用以下命令装前置：</p><figure class="highlight bash"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br></pre></td><td class="code"><pre><code class="hljs bash"><span class="hljs-built_in">sudo</span> apt update<br><span class="hljs-built_in">sudo</span> apt install -y build-essential<br></code></pre></td></tr></table></figure><ul><li><p>使用下列命令确保系统已安装clangd</p><figure class="highlight bash"><table><tr><td class="gutter"><pre><span class="line">1</span><br></pre></td><td class="code"><pre><code class="hljs bash"><span class="hljs-built_in">sudo</span> apt install clangd<br></code></pre></td></tr></table></figure><p>这里简单讲讲什么是clangd：clangd本质是一个常驻的C&#x2F;C++语义分析引擎服务，由LLVM开发，是编辑器实现智能补全的核心。在我们使用编辑器对源文件进行编辑时，clangd会在后台实时解析你的代码——做的事情和编译器的前半程一样（展开头文件与宏、构建语法树），但不产出可执行文件，而是通过这个过程获取你当前的代码结构。当你输入部分关键字(例如str)时，clangd会收集当前光标所处作用域内的所有可见符号（局部变量、参数、函数名，以及<code>#include</code>引入的声明），按前缀过滤后返回给编辑器。这也是为什么你在光标处输入str后，补全菜单会自动跳出 <code>strcmp</code>、<code>strcpy</code>等等符号。</p></li><li><p>前置全部正确安装之后，使用新增一个nvim的clangd.lua配置文件 <code>~/.config/nvim/lua/plugins/clangd.lua</code> 。在新创建的文件中将下列代码复制进去：</p><figure class="highlight lua"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br></pre></td><td class="code"><pre><code class="hljs lua"><span class="hljs-keyword">return</span> &#123;<br>  &#123;<br>    <span class="hljs-string">&quot;neovim/nvim-lspconfig&quot;</span>,<br>    opts = &#123;<br>      servers = &#123;<br>        clangd = &#123; mason = <span class="hljs-literal">false</span> &#125;, <br>      &#125;,<br>    &#125;,<br>  &#125;,<br>&#125;<br></code></pre></td></tr></table></figure><p>这段代码的含义是告诉LazyVim：clangd这个语言服务器不走Mason管理，直接使用本机系统已经装好的clangd。</p></li><li><p>用LazyVim打开一个源文件，可见自动补全已经正常运行（也可以用<code>:LspInfo</code>查看clangd是否处于attached状态）：</p><img src="/2026/09/25/嵌入式2026092501/2026092501_1.webp" style="zoom:67%;" /></li></ul><hr><h4 id="关于智能补全"><a href="#关于智能补全" class="headerlink" title="关于智能补全"></a>关于智能补全</h4><p>这里简单来聊聊LazyVim的智能补全机制，究竟是怎么做到智能补全的。首先得清楚：LazyVim本质上不是编辑器，而是针对Neovim打造的一套个性化配置。我们在使用编辑器时，用的是Neovim，而各种个性化以及智能化配置是由LazyVim配置而来的。</p><p>Neovim内置了LSP客户端，LSP是语言服务器协议，用于编辑器与语义分析服务(比如我们的clangd)之间的桥梁。其整个智能补全的简单工作流程如下：</p><ul><li>我们在编辑器中输入s-t-r三个字符，LSP会向clangd服务发送一条JSON信息，这条信息中包含文件路径和当前光标位置。注意，这里并不包含我们输入的内容——clangd会自己从文件内容里读取光标前的文本，提取出我们正在输入的词。</li><li>clangd收到信息后，定位到当前光标位置，并且收集所有可见的相关符号，过滤后返回给LSP。LSP收到后返回给上层服务进行综合排序，排序完毕后通过菜单呈现出来。这就是我们看到的智能补全菜单了。</li></ul>]]>
    </content>
    <id>https://r6blog.online/2026/09/25/%E5%B5%8C%E5%85%A5%E5%BC%8F2026092501/</id>
    <link href="https://r6blog.online/2026/09/25/%E5%B5%8C%E5%85%A5%E5%BC%8F2026092501/"/>
    <published>2026-09-25T05:02:38.000Z</published>
    <summary>
      <![CDATA[<h4 id="现象及原因"><a href="#现象及原因" class="headerlink" title="现象及原因"></a>现象及原因</h4><p>环境: WSL2 + Ubuntu(26.04)。在环境中装好LazyVim插件后，发现编辑器的智能补全功能并不完善]]>
    </summary>
    <title>LazyVim C开发环境智能补全问题</title>
    <updated>2026-10-08T07:15:10.247Z</updated>
  </entry>
  <entry>
    <author>
      <name>R6bandito</name>
    </author>
    <category term="杂项" scheme="https://r6blog.online/categories/%E6%9D%82%E9%A1%B9/"/>
    <category term="Note" scheme="https://r6blog.online/tags/Note/"/>
    <content>
      <![CDATA[<h4 id="前言"><a href="#前言" class="headerlink" title="前言"></a>前言</h4><p>本偏文章主要用于记录一些自己平时看到的觉得不错的笔面试题目，虽然偏八股但是仔细研究一下还是能从里面学到不少门道的。长期随缘更新，题目顺序不固定，目前先线性往下慢慢写吧。文章可能难免会有缺陷，若您发现问题还望通过邮箱及时与我联系，帮助我及时改正，不胜感激。</p><hr><h4 id="主目录"><a href="#主目录" class="headerlink" title="主目录"></a>主目录</h4><h5 id="typdef-int-INT-PTR-和-define-INT-PTR-int-在声明多个变量时有什么不同？"><a href="#typdef-int-INT-PTR-和-define-INT-PTR-int-在声明多个变量时有什么不同？" class="headerlink" title="typdef int* INT_PTR; 和 #define INT_PTR int* 在声明多个变量时有什么不同？"></a>typdef int* INT_PTR; 和 #define INT_PTR int* 在声明多个变量时有什么不同？</h5><p>这个题目有点意思，这里要清楚 #define 是宏替换，而 typedef 是类型重映射，这是二者的本质区别。看下面这个示例：</p><figure class="highlight c"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br></pre></td><td class="code"><pre><code class="hljs c"><span class="hljs-keyword">typedef</span> <span class="hljs-type">int</span>* INT_PTR;<br><span class="hljs-meta">#<span class="hljs-keyword">define</span> INT_PPTR int*</span><br><br><span class="hljs-type">void</span> <br><span class="hljs-title function_">test</span><span class="hljs-params">( <span class="hljs-type">void</span> )</span><br>&#123;<br>    INT_PTR a,b;<span class="hljs-comment">// a b 均为 INT_PTR 类型.</span><br>    INT_PPTR c,d;   <span class="hljs-comment">// c 为 int*，d为int.</span><br>&#125;<br></code></pre></td></tr></table></figure><p>在IDE中写出上述示例，你查看变量类型会发现 a,b 均为 INT_PTR 类型；而 c 为 int* 类型，d 为 int 类型，二者很明显是有区别的。原因在于：在 #define 宏定义情况下，<code>INT_PPTR c,d;</code>被展开为了 <code>int* c,d;</code>，编译器将其理解为一个 int* c 变量和一个 d 变量（C语言中，声明变量若未显示指明类型则默认为 int 型）。因此才会出现c，d类型不一致的情况。</p><p>而在类型重映射情况下，<code>INT_PTR a,b;</code> 被编译器解释为了 <code>INT_PTR a, INT_PTR b;</code> 即 <code>int* a, int* b;</code>，因此二者都是同一个类型。</p><hr><h5 id="什么是整数提升？unsigned-char-a-0xFF-if-a-0x00-这个条件成立吗？"><a href="#什么是整数提升？unsigned-char-a-0xFF-if-a-0x00-这个条件成立吗？" class="headerlink" title="什么是整数提升？unsigned char a &#x3D; 0xFF; if( a &#x3D;&#x3D; ~0x00 )这个条件成立吗？"></a>什么是整数提升？unsigned char a &#x3D; 0xFF; if( a &#x3D;&#x3D; ~0x00 )这个条件成立吗？</h5><p>首先，这个条件肯定是永远不会成立的。</p><p>这里涉及到C语言中一个类型运算规则：<strong>在C语言中，只要是参与运算的参数类型小于int，那么会先将该类型提升到int或uint再参与运算</strong>。而~0x00经过按位取反后，得到的结果应为<code>0xFFFFFFFF</code>，同时a经过提升变为<code>0x000000FF</code>参与比较，<code>0x000000FF</code> 很显然不等于 <code>0xFFFFFFFF</code>。因此这个条件永远是false。</p><hr><h5 id="0x01-3-1-结果是多少？为什么？"><a href="#0x01-3-1-结果是多少？为什么？" class="headerlink" title="0x01 &lt;&lt; 3 + 1 结果是多少？为什么？"></a>0x01 &lt;&lt; 3 + 1 结果是多少？为什么？</h5><p>嗯，很经典的一个问题，也很简单，考的是运算符优先级的问题。这里加法运算优先级高于位移优先级，因此实际等价于 <code>0x01 &lt;&lt; (3 + 1) = 0x01 &lt;&lt; 4 = 16</code> 。关于运算符优先级我这里不详细给出，只是强调一下：在实际运用中，如果不是很确定运算的优先级，那么请统一加括号，不要怕难看。哪怕是写成 <code>return (...(0x01 &lt;&lt; (3 + 1))...)</code> 这样都没有问题，因为计算是明确的。</p><hr><h5 id="定义一个结构，同一块内存访问能够存放4个字节数组，也能够作为32位整数访问，同时还支持按位访问。"><a href="#定义一个结构，同一块内存访问能够存放4个字节数组，也能够作为32位整数访问，同时还支持按位访问。" class="headerlink" title="定义一个结构，同一块内存访问能够存放4个字节数组，也能够作为32位整数访问，同时还支持按位访问。"></a>定义一个结构，同一块内存访问能够存放4个字节数组，也能够作为32位整数访问，同时还支持按位访问。</h5><p>很明显，同一块内存在不同情况下要搭建不同的内存模型，我们需要用到union联合体结构。</p><p>union联合体是一种C语言构造类型，<strong>所有成员共享同一块内存空间，其大小等于最大成员的大小，用于在同一内存中存储不同类型的数据以节省空间</strong>。这题相关结构定义如下所示：</p><figure class="highlight c"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br></pre></td><td class="code"><pre><code class="hljs c"><span class="hljs-keyword">typedef</span> <span class="hljs-class"><span class="hljs-keyword">union</span> &#123;</span><br>    <span class="hljs-type">uint8_t</span> <span class="hljs-built_in">array</span>[<span class="hljs-number">4</span>];<br>    <span class="hljs-type">uint32_t</span> var;<br>    <span class="hljs-class"><span class="hljs-keyword">struct</span> &#123;</span><br>        <span class="hljs-type">uint32_t</span> bit0 : <span class="hljs-number">1</span>;<br>        <span class="hljs-type">uint32_t</span> bit1 : <span class="hljs-number">1</span>;<br>        <span class="hljs-type">uint32_t</span> bit2 : <span class="hljs-number">1</span>;<br>        ...<br>        <span class="hljs-type">uint32_t</span> bit30: <span class="hljs-number">1</span>;<br>        <span class="hljs-type">uint32_t</span> bit31: <span class="hljs-number">1</span>;<br>    &#125; bits;<br>&#125; MyStructure;<br></code></pre></td></tr></table></figure><p>这里强调一下：位域这个结构可以详细了解下理论，但是少用。原因在于位域移植性很糟糕，在不同的字节序主机上同一套代码是完全不同的逻辑。因此在进行位操作时请使用相关操作符，而不是使用位域。</p><hr><h5 id="字符串反转（不借助新数组，原地反转一个字符串）"><a href="#字符串反转（不借助新数组，原地反转一个字符串）" class="headerlink" title="字符串反转（不借助新数组，原地反转一个字符串）"></a>字符串反转（不借助新数组，原地反转一个字符串）</h5><figure class="highlight c"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br></pre></td><td class="code"><pre><code class="hljs c"><span class="hljs-type">void</span> <br><span class="hljs-title function_">reverse_string</span><span class="hljs-params">( <span class="hljs-type">char</span> *str )</span><br>&#123;<br>    <span class="hljs-keyword">if</span> ( !str || <span class="hljs-built_in">strlen</span>(str) &lt; <span class="hljs-number">2</span> ) <span class="hljs-keyword">return</span>;<br><br>    <span class="hljs-type">char</span> *start = str;<br>    <span class="hljs-type">char</span> *end = str + <span class="hljs-built_in">strlen</span>(str) - <span class="hljs-number">1</span>;<br><br>    <span class="hljs-keyword">while</span>( start &lt; end )<br>    &#123;<br>        <span class="hljs-type">char</span> temp = *start;<br>        *start = *end;<br>        *end = temp;<br><br>        start++;<br>        end--;<br>    &#125;<br>&#125;<br></code></pre></td></tr></table></figure><p>这里不做过多讲解，直接给一轮流程图：</p><img src="/2026/09/22/嵌入式2026092201/2026092201_1.webp" style="zoom: 67%;" /><hr><h5 id="模拟实现-strcpy-与-memcpy"><a href="#模拟实现-strcpy-与-memcpy" class="headerlink" title="模拟实现 strcpy 与 memcpy"></a>模拟实现 strcpy 与 memcpy</h5><p>my_strcpy:</p><figure class="highlight c"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br></pre></td><td class="code"><pre><code class="hljs c"><span class="hljs-type">void</span> <br><span class="hljs-title function_">my_strcpy</span><span class="hljs-params">( <span class="hljs-type">char</span> *dest, <span class="hljs-type">const</span> <span class="hljs-type">char</span> *src )</span><br>&#123;<br>    <span class="hljs-keyword">if</span> ( !dest || !src )<br>        <span class="hljs-keyword">return</span>;<br><br>    <span class="hljs-keyword">while</span>( *src != <span class="hljs-string">&#x27;\0&#x27;</span> )<br>        *dest++ = *src++;<br><br>    *dest = <span class="hljs-string">&#x27;\0&#x27;</span>;<br>&#125;<br></code></pre></td></tr></table></figure><p>my_memcpy:</p><figure class="highlight c"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br></pre></td><td class="code"><pre><code class="hljs c"><span class="hljs-type">void</span> <br><span class="hljs-title function_">my_memcpy</span><span class="hljs-params">( <span class="hljs-type">void</span> *dest, <span class="hljs-type">const</span> <span class="hljs-type">void</span> *src, <span class="hljs-type">size_t</span> n )</span><br>&#123;<br>    <span class="hljs-keyword">if</span> ( !dest || !src || n == <span class="hljs-number">0</span> )<br>        <span class="hljs-keyword">return</span>;<br><br>    <span class="hljs-type">uint8_t</span> *d = (<span class="hljs-type">uint8_t</span> *)dest;<br>    <span class="hljs-type">const</span> <span class="hljs-type">uint8_t</span> *s = (<span class="hljs-type">const</span> <span class="hljs-type">uint8_t</span> *)src;<br>    <span class="hljs-keyword">while</span>( n-- )<br>        *d++ = *s++;<br>&#125;<br></code></pre></td></tr></table></figure><p>都是很简单的手写题，有个思路就行，不做过多讲解。</p><hr><h5 id="冒泡排序"><a href="#冒泡排序" class="headerlink" title="冒泡排序"></a>冒泡排序</h5><p>这里先简单讲讲冒泡排序的原理：</p><p>首先我们现在手上有一个待排无序数组<code>arr[5, 1, 7, 3, 2, 4]</code>。我们可以先在这6个数中，每两个数之间进行比较排序，将较大的数往后排。即：</p><blockquote><ol><li>5和1比较：(5&gt;1) ?  结果为True，5和1交换一次，原数组变为 arr[1, 5, 7, 3, 2, 4].</li><li>再拿5和7比较：(5&gt;7)? 结果为false，5和7不交换，数组保持不变.</li><li>7和3比较：(7&gt;3)? 结果为True，7和3交换一次，数组变为 arr[1, 5, 3, 7, 2, 4].</li><li>7和2比较：(7&gt;2)? 结果为True，7和2交换一次，数组变为 arr[1, 5, 3, 2, 7, 4].</li><li>7和4比较：(7&gt;4)? 结果为True，7和4交换一次，数组变为 arr[1, 5, 3, 2, 4, 7].</li></ol></blockquote><p>可以看到我们进行了5次比较，成功将整个序列中最大的数放到了最后。以上整个流程我们称之为一轮排序。既然经过一轮能选出一个最大的，那么我们下次排序剔除掉排好的这个，是不是又可以选出一个次最大的数据出来？最后，我们整个数组序列有6个元素，我们通过5轮排序，就能够将整个数组按从小到大的顺序进行序列化了。这就是冒泡排序的原理。以下是冒泡排序的参考程序实现：</p><figure class="highlight c"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br><span class="line">19</span><br><span class="line">20</span><br><span class="line">21</span><br><span class="line">22</span><br><span class="line">23</span><br><span class="line">24</span><br><span class="line">25</span><br><span class="line">26</span><br></pre></td><td class="code"><pre><code class="hljs c"><span class="hljs-type">void</span> <br><span class="hljs-title function_">bubble_sort</span><span class="hljs-params">( <span class="hljs-type">int</span> *arr, <span class="hljs-type">int</span> len )</span><br>&#123;<br>    <span class="hljs-keyword">if</span> ( !arr || len &lt; <span class="hljs-number">2</span> )<br>        <span class="hljs-keyword">return</span>;<br><br>    <span class="hljs-comment">/* 外层循环：排序轮数. */</span><br>    <span class="hljs-keyword">for</span>( <span class="hljs-type">uint8_t</span> i = <span class="hljs-number">0</span>; i &lt; len - <span class="hljs-number">1</span>; i++ )<br>    &#123;<br>        <span class="hljs-type">uint8_t</span> isSwapped = <span class="hljs-number">0</span>;<br>        <span class="hljs-comment">/* 内层循环：每轮需要的比较次数. */</span><br>        <span class="hljs-keyword">for</span>( <span class="hljs-type">uint8_t</span> j = <span class="hljs-number">0</span>; j &lt; len - <span class="hljs-number">1</span> - i; j++ )<br>        &#123;<br>            <span class="hljs-keyword">if</span> ( arr[j] &gt; arr[j + <span class="hljs-number">1</span>] )<br>            &#123;<br>                <span class="hljs-type">int</span> temp = arr[j];<br>                arr[j] = arr[j + <span class="hljs-number">1</span>];<br>                arr[j + <span class="hljs-number">1</span>] = temp;<br>                isSwapped = <span class="hljs-number">1</span>;<br>            &#125;<br>        &#125;<br><br>        <span class="hljs-keyword">if</span> ( !isSwapped )<br>            <span class="hljs-keyword">break</span>;<br>    &#125;<br>&#125;<br></code></pre></td></tr></table></figure><p>这里讲一下 <code>isSwapped</code> 这个标志位：这是个优化标志位，当我们给出的数组本来就是有序数组，或经过某轮排序后整体已经变为有序序列时，就没必要继续往下进行了。该标志位在数组已经有序后，其在下一轮的遍历流程中不会被置1（数组已经有序，不会再进行任何交换操作），此时检测到该标志位没有置1后，直接提前退出就可以了。</p><p>Ps：这里循环变量用的是u8，有溢出风险。此处只做演示说明，实际使用时根据具体情况来决定其类型。</p><hr><h5 id="一些位操作相关逻辑"><a href="#一些位操作相关逻辑" class="headerlink" title="一些位操作相关逻辑"></a>一些位操作相关逻辑</h5><p>位操作算是嵌入式基本功了，此处给出一些位操作相关逻辑：</p><figure class="highlight c"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br></pre></td><td class="code"><pre><code class="hljs c"><span class="hljs-comment">/* 将 reg 的第 x 位置1. */</span><br><span class="hljs-meta">#<span class="hljs-keyword">define</span> SET_BIT(reg, x)      ((reg) |= (0x01u &lt;&lt; (x)))</span><br><br><span class="hljs-comment">/* 将 reg 的第 x 位清0. */</span> <br><span class="hljs-meta">#<span class="hljs-keyword">define</span> CLEAR_BIT(reg, x)    ((reg) &amp;= (~(0x01u &lt;&lt; (x))))</span><br><br><span class="hljs-comment">/* 读取 reg 的第 x 位. */</span><br><span class="hljs-meta">#<span class="hljs-keyword">define</span> GET_BIT(reg, x)      (((reg) &gt;&gt; (x)) &amp; 0x01u)</span><br><br><span class="hljs-comment">/* 翻转 reg 的第 x 位. */</span><br><span class="hljs-meta">#<span class="hljs-keyword">define</span> TOGGLE_BIT(reg, x)   ((reg) ^= (0x01u &lt;&lt; (x)))</span><br></code></pre></td></tr></table></figure><p>“统计一个字节里面有多少个1” 这是一道非常经典的笔试题目，一个很简单的位移使用，我曾今也碰到过：</p><figure class="highlight c"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br></pre></td><td class="code"><pre><code class="hljs c"><span class="hljs-type">uint8_t</span> <br><span class="hljs-title function_">count_ones</span><span class="hljs-params">( <span class="hljs-type">uint8_t</span> data )</span><br>&#123;<br>    <span class="hljs-type">uint8_t</span> count = <span class="hljs-number">0</span>;<br>    <span class="hljs-keyword">for</span>( <span class="hljs-type">uint8_t</span> i = <span class="hljs-number">0</span>; i &lt; <span class="hljs-number">8</span>; i++ )<br>    &#123;<br>        <span class="hljs-keyword">if</span> ( (data &amp; (<span class="hljs-number">0x01</span> &lt;&lt; i)) )<br>            count++;<br>    &#125;<br><br>    <span class="hljs-keyword">return</span> count;<br>&#125;<br></code></pre></td></tr></table></figure><p>这是我曾经的写法，不能说是错的，但是还有一种更巧妙的写法：</p><figure class="highlight c"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br></pre></td><td class="code"><pre><code class="hljs c"><span class="hljs-type">uint8_t</span> <br><span class="hljs-title function_">count_ones</span><span class="hljs-params">( <span class="hljs-type">uint8_t</span> data )</span><br>&#123;<br>    <span class="hljs-type">uint8_t</span> count = <span class="hljs-number">0</span>;<br>    <span class="hljs-keyword">while</span>( data &gt; <span class="hljs-number">0</span> )<br>    &#123;<br>        data &amp;= (data - <span class="hljs-number">1</span>);<br>        count++;<br>    &#125;<br><br>    <span class="hljs-keyword">return</span> count;<br>&#125;<br></code></pre></td></tr></table></figure><p>怎么样？不管data是什么数，<code>data &amp; (data - 1)</code> 总能够把data最低位的一个1去丢。</p><p>例如<code>data = 0b1101 1010</code>、<code>data - 1 = 0b1101 1001</code> 。<code>data &amp; (data - 1) = 0b1101 1000</code> 看到没？经过一次操作将其最低的一个1去掉了，此时<code>count=1</code>。继续while循环直到<code>data = 0</code>，刚好把5个1全部去掉，<code>count=5</code>，这不就统计出来了吗？ 这个方法比较巧妙，后续求一个数是否是2的幂等数时，也会用到类似的思想。</p><hr><h5 id="单链表反转"><a href="#单链表反转" class="headerlink" title="单链表反转"></a>单链表反转</h5><p>单链表反转也是个比较经典的考点，这里用文字叙述有些不易理解，所以先以下图进行一个情景带入：</p><img src="/2026/09/22/嵌入式2026092201/2026092201_2.webp" style="zoom:80%;" /><p>翻转前链表的头节点为A，我们要求链表翻转后D为头节点，A为尾节点。这里我们采用三指针法进行翻转：</p><ul><li>定义三个指针 <code>curr</code>、<code>next</code>、<code>prev</code>。初始状态下，curr指向当前头节点，next与prev初始化为NULL。</li><li>将next指向<code>curr-&gt;next</code>。也就是用next记住当前curr节点的下一个节点，防止翻转curr后丢掉后继节点。</li></ul><img src="/2026/09/22/嵌入式2026092201/2026092201_3.webp" style="zoom: 67%;" /><ul><li>将curr当前节点翻转指向prev，并且同步更新prev和curr。</li></ul><img src="/2026/09/22/嵌入式2026092201/2026092201_4.webp" style="zoom:67%;" /><ul><li>重复上述操作，将next指向curr的next，然后对curr指向节点进行翻转，并同步更新curr与prev。</li></ul><img src="/2026/09/22/嵌入式2026092201/2026092201_5.webp" style="zoom:67%;" /><ul><li>一直循环该翻转操作，直到最后一个节点D也成功翻转，变为头节点。</li></ul><p>下列是三指针法进行单链表翻转的参考示例：</p><figure class="highlight c"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br><span class="line">19</span><br><span class="line">20</span><br><span class="line">21</span><br><span class="line">22</span><br><span class="line">23</span><br><span class="line">24</span><br><span class="line">25</span><br></pre></td><td class="code"><pre><code class="hljs c"><span class="hljs-keyword">typedef</span> <span class="hljs-class"><span class="hljs-keyword">struct</span> <span class="hljs-title">Node</span> <span class="hljs-title">Node</span>;</span><br><span class="hljs-class"><span class="hljs-keyword">struct</span> <span class="hljs-title">Node</span> &#123;</span><br>    <span class="hljs-type">uint8_t</span> data;<br>    Node *next;<br>&#125;;<br><br>Node *<br><span class="hljs-title function_">list_reverse</span><span class="hljs-params">( Node *head )</span><br>&#123;<br>    <span class="hljs-keyword">if</span> ( !head )  <span class="hljs-keyword">return</span> <span class="hljs-literal">NULL</span>;<br><br>    Node *curr = head;<br>    Node *next = <span class="hljs-literal">NULL</span>;<br>    Node *prev = <span class="hljs-literal">NULL</span>;<br><br>    <span class="hljs-keyword">while</span>( curr != <span class="hljs-literal">NULL</span> )<br>    &#123;<br>        next = curr-&gt;next;<br>        curr-&gt;next = prev;<br>        prev = curr;<br>        curr = next;<br>    &#125;<br><br>    <span class="hljs-keyword">return</span> prev;<br>&#125;<br></code></pre></td></tr></table></figure><hr><h5 id="数组单次遍历找最大值和次大值"><a href="#数组单次遍历找最大值和次大值" class="headerlink" title="数组单次遍历找最大值和次大值"></a>数组单次遍历找最大值和次大值</h5><p>数组找最值并不复杂，核心点在于一次循环必须找出最大和次大值。这里我们的思路是在给定数组的前两个元素中，先找出暂定最大值，剩下一个作为暂定次大值。后续从数组的第三个元素开始向后遍历，若找到一个比当前最大值还要大的元素，则更新当前最大值，同时用旧的最大值来更新次大值；若找到一个大于当前次大值，却又小于最大值的元素，则只更新次大值。一轮循环过后成功拿到最大、次大值。</p><p>程序示例如下：</p><figure class="highlight c"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br><span class="line">19</span><br><span class="line">20</span><br><span class="line">21</span><br><span class="line">22</span><br><span class="line">23</span><br><span class="line">24</span><br><span class="line">25</span><br><span class="line">26</span><br><span class="line">27</span><br><span class="line">28</span><br><span class="line">29</span><br><span class="line">30</span><br><span class="line">31</span><br><span class="line">32</span><br><span class="line">33</span><br><span class="line">34</span><br><span class="line">35</span><br><span class="line">36</span><br></pre></td><td class="code"><pre><code class="hljs c"><span class="hljs-type">void</span> <br><span class="hljs-title function_">find_max_sec</span><span class="hljs-params">( <span class="hljs-type">int</span> *arr, <span class="hljs-type">int</span> len, <span class="hljs-type">int</span> *Omax, <span class="hljs-type">int</span> *Osec )</span><br>&#123;<br>    <span class="hljs-keyword">if</span> ( !arr || len &lt; <span class="hljs-number">2</span> )<br>        <span class="hljs-keyword">return</span>;<br><br>    <span class="hljs-comment">/* 先在前两个元素中暂定最大值与次大值. */</span><br>    <span class="hljs-type">int</span> max = arr[<span class="hljs-number">0</span>];<br>    <span class="hljs-type">int</span> sec = arr[<span class="hljs-number">1</span>];<br>    <span class="hljs-keyword">if</span> ( max &lt; sec )<br>    &#123;<br>        <span class="hljs-type">int</span> temp = max;<br>        max = sec;<br>        sec = temp;<br>    &#125;<br><br>    <span class="hljs-comment">/* 从第三个元素开始遍历. */</span><br>    <span class="hljs-keyword">for</span>( <span class="hljs-type">uint32_t</span> i = <span class="hljs-number">2</span>; i &lt; len; i++ )<br>    &#123;<br>        <span class="hljs-comment">/* 找到比当前最大值还大的元素. 更新最大值与次大值. */</span><br>        <span class="hljs-keyword">if</span> ( arr[i] &gt; max )<br>        &#123;<br>            sec = max;<br>            max = arr[i];<br>        &#125;<br>        <span class="hljs-keyword">else</span> <span class="hljs-keyword">if</span> ( (arr[i] &gt; sec) &amp;&amp; (arr[i] != max) )<br>        &#123;<br>            <span class="hljs-comment">/* 找到大于次大值且小于最大值的元素. 仅更新次大值. */</span><br>            sec = arr[i];<br>        &#125;<br>    &#125;<br><br>    <span class="hljs-comment">/* 一轮遍历结束. 根据参数进行结果输出. */</span><br>    <span class="hljs-keyword">if</span> ( Omax ) *Omax = max;<br>    <span class="hljs-keyword">if</span> ( Osec ) *Osec = sec;<br>&#125;<br></code></pre></td></tr></table></figure><hr><h5 id="判断一个数是不是2的幂"><a href="#判断一个数是不是2的幂" class="headerlink" title="判断一个数是不是2的幂"></a>判断一个数是不是2的幂</h5><p>判断一个数是否是2的幂等数，你可能会想：直接对2循环取余判断是否为0不就完了吗？这有啥难的？确实，不过我们这里要讲的是通过位操作来判断2的幂等数。通过位操作进行判断是一个经典的笔试题，同时也有确切的应用场景。你比如在环形缓冲区中我们进行优化时就会用到该方法（详见：<a href="/2026/09/17/%E5%B5%8C%E5%85%A5%E5%BC%8F2026091701/" title="环形缓冲区(Ring Buffer)">环形缓冲区</a>）</p><figure class="highlight c"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br></pre></td><td class="code"><pre><code class="hljs c"><span class="hljs-type">int</span> <br><span class="hljs-title function_">is_power_of_two</span><span class="hljs-params">( <span class="hljs-type">uint32_t</span> data )</span><br>&#123;<br>    <span class="hljs-keyword">return</span> ((data &gt; <span class="hljs-number">0</span>) &amp;&amp; (data &amp; (data - <span class="hljs-number">1</span>)) == <span class="hljs-number">0</span>);<br>&#125;<br></code></pre></td></tr></table></figure><p>这里简单讲讲为什么2的幂等数能够使用 <code>data &amp; (data - 1) == 0</code> 来判断：因为2的幂等数在2进制中只有一个1，例如<code>64(0b0100 0000)</code>、<code>128(0b1000 0000)</code> 。这些数减去1后会把那个1变成0，而把剩下的0变成1。比如 <code>128 - 1 = 127(0b0111 1111)</code>，这样两个一做与运算<code>data &amp; (data - 1) = 0b1000 0000 &amp; 0b0111 1111 = 0</code> 结果不就是0吗？</p><p>一条 <code>data &amp; (data - 1)</code> 位运算在底层看来就是单纯一条指令，仅需一个时钟周期。而如果你采用循环取余的方式，由于底层没有专门的除法电路，其除法器通常是通过反复的减法、移位、试商等微码循环来实现的。这就意味着一条除法指令往往需要花费数十个时钟周期，还要涉及循环开销。这个性能帐我相信谁都能算明白。</p><hr><h5 id="define-SQUARE-x-x-x，那么-SQUARE-2-3-等于多少？"><a href="#define-SQUARE-x-x-x，那么-SQUARE-2-3-等于多少？" class="headerlink" title="#define SQUARE(x)   x*x，那么 SQUARE(2+3) 等于多少？"></a>#define SQUARE(x)   x*x，那么 SQUARE(2+3) 等于多少？</h5><p>这是个很典型的带参宏定义陷阱题。我们首先需要清楚宏定义的本质：<strong>在预处理阶段进行文本替换</strong>。也就是说你丢在括号里面的这一个表达式会原封不动的通过宏定义进行文本更换。</p><figure class="highlight c"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br></pre></td><td class="code"><pre><code class="hljs c"><span class="hljs-meta">#<span class="hljs-keyword">define</span> SQUARE(x)   x*x</span><br><br>SQUARE(<span class="hljs-number">2</span>+<span class="hljs-number">3</span>) -(宏定义展开)-&gt; <span class="hljs-number">2</span>+<span class="hljs-number">3</span>*<span class="hljs-number">2</span>+<span class="hljs-number">3.</span><br></code></pre></td></tr></table></figure><p>发现问题了吗？我们原意是计算<code>5*5 = 25</code>，结果宏定义展开后由于运算符优先级的作用，导致计算式变为了 <code>2+6+3 = 11</code> ，这就是带参宏定义很容易出现的问题。所以在进行宏定义时，入参必须写成如下形式：</p><figure class="highlight c"><table><tr><td class="gutter"><pre><span class="line">1</span><br></pre></td><td class="code"><pre><code class="hljs c"><span class="hljs-meta">#<span class="hljs-keyword">define</span> SQUARE(x)   ((x)*(x))</span><br></code></pre></td></tr></table></figure><p>通过括号来保证运算有一个确定的优先级，而不受运算符优先级的影响。</p><hr><h5 id="大小端字节序判断"><a href="#大小端字节序判断" class="headerlink" title="大小端字节序判断"></a>大小端字节序判断</h5><p>字节序判断这个已经无需多言了，相信只要看过笔试整理相关文章的100%都能遇到。这里简单讲讲什么是大小端字节序并给出两种判断方法。</p><p><strong>大端字节序(MSB)</strong>：多字节数据的高位字节存放在内存的低地址，低位字节存放在内存的高地址。例如 <code>0x12345678</code>这个32位数据存储在 0x1000 ~ 0x1003 这四个字节的位置。那么在MSB字节序下 0x1000 存的就是 0x12(高位字节)，对应的 0x1003存的就是 0x78(低位字节)。</p><p><strong>小端字节序(LSB)</strong>：多字节数据在内存中低地址存放低位字节，高地址存放高位字节的存储方式（低地址存低位，高地址存高位）。还是以上述 <code>0x12345678</code> 为例，在LSB字节序下面 0x1000 存的是 0x78(低位字节)，对应的 0x1003存的是 0x12(高位字节)。</p><p>二者的内存布局如下图所示：</p><img src="/2026/09/22/嵌入式2026092201/2026092201_6.webp" style="zoom: 67%;" /><p>以下给出两种方法来判断当前环境字节序：</p><ul><li>通过联合体(union)进行判断，这也是最为常见的一个方法。</li></ul><figure class="highlight c"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br></pre></td><td class="code"><pre><code class="hljs c"><span class="hljs-class"><span class="hljs-keyword">union</span> &#123;</span><br>    <span class="hljs-type">uint32_t</span> data;<br>    <span class="hljs-type">uint8_t</span> <span class="hljs-built_in">array</span>[<span class="hljs-number">4</span>];<br>&#125; uio;<br><br><span class="hljs-type">int</span> <br><span class="hljs-title function_">check_endian</span><span class="hljs-params">( <span class="hljs-type">void</span> )</span><br>&#123;<br>    uio.data = <span class="hljs-number">0x12345678u</span>l;<br>    <span class="hljs-comment">/* 返回 1 为MSB字节序；返回 0 为LSB字节序. */</span><br>    <span class="hljs-keyword">return</span> ((uio.<span class="hljs-built_in">array</span>[<span class="hljs-number">0</span>] == <span class="hljs-number">0x12</span>) ? <span class="hljs-number">1</span> : <span class="hljs-number">0</span>);<br>&#125;<br></code></pre></td></tr></table></figure><ul><li>通过指针强转进行判断。</li></ul><figure class="highlight c"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br></pre></td><td class="code"><pre><code class="hljs c"><span class="hljs-type">int</span> <br><span class="hljs-title function_">check_endian</span><span class="hljs-params">( <span class="hljs-type">void</span> )</span><br>&#123;<br>    <span class="hljs-type">uint32_t</span> i = <span class="hljs-number">1</span>;<br>    <span class="hljs-comment">/* 返回 1 为MSB字节序；返回 0 为LSB字节序. */</span><br>    <span class="hljs-keyword">return</span> (((*(<span class="hljs-type">uint8_t</span> *)&amp;i) == <span class="hljs-number">0</span>) ? <span class="hljs-number">1</span> : <span class="hljs-number">0</span>);<br>&#125;<br></code></pre></td></tr></table></figure><p>我们所使用的 <code>ARM Cortex-M</code> 架构就是典型的LSB字节序，而网络字节序是典型的MSB字节序。</p><hr><h5 id="I2C为什么需要上拉电阻？一般阻值为多大比较合适？"><a href="#I2C为什么需要上拉电阻？一般阻值为多大比较合适？" class="headerlink" title="I2C为什么需要上拉电阻？一般阻值为多大比较合适？"></a>I2C为什么需要上拉电阻？一般阻值为多大比较合适？</h5><p>首先从I2C的架构方面来入手，I2C可以用来进行<strong>多主多从</strong>组网，在多主机情况下，I2C总线上谁控制住时钟SCL谁就是本次通信的主机。I2C总线有线与仲裁机制，所以就算多个主机同时进行通信，最终在仲裁机制下只会有一个设备得以成功与从机建立通信。而在这仲裁期间，假如我们使用推挽输出，那么当一个设备输出高电平1，另一个设备接地输出低电平0时，那么在总线上就会出现一个从 VCC 直接短路到 GND 的回路，这回产生一个瞬时大电流很容易会导致GPIO口被烧毁。</p><p>因此在I2C上我们必须使用开漏输出，这意味着高电平无法输出到总线，那么这个时候就需要一个显式的外部上拉来完成总线电平输出高这个动作，这就是为什么需要外部上拉电阻。</p><p>这个上拉电阻的阻值在 3.3V 系统中，我们通常采用4.7kΩ比较合适。这个上拉电阻的阻值不能过大，也不能太小</p><ul><li>阻值过大的话由于RC电路特性，上升沿会变缓。若通信速率比较高的话很容易会出现在SCL还没充到高电平，SDA就可能已经被下拉到0了，导致通信误码、ACK丢失等问题。</li><li>阻值过小上升沿陡峭，适合较高速率的通信。但是同时总线上电流比较大，器件功耗大发热大，甚至如果电流超过了I2C器件的承载值的话可能会烧器件。</li></ul><hr><h5 id="I2C时钟拉伸"><a href="#I2C时钟拉伸" class="headerlink" title="I2C时钟拉伸"></a>I2C时钟拉伸</h5><p>正常情况下，I2C总线的时钟SCL是由主机控制的，但在某些情况下，由于主机通信速率过快从机处理不过来，部分从机会主动抓住SCL时钟线（从机拉低SCL），让主机无法继续产生时钟脉冲。从机处理完毕后再松开SCL，将SCL控制权交还给主机，继续进行接下来的通信。</p><p><strong>从机主动拽住SCL时钟线的这个机制就叫作I2C的时钟拉伸机制</strong>。</p><p>这里以一个具体的时序例子来看看时钟拉伸：</p><img src="/2026/09/22/嵌入式2026092201/2026092201_7.webp" style="zoom:67%;" /><p>正常情况下，主机将依次发出A、B、C、D、E五个脉冲，在脉冲高电平期间，SDA数据线被锁存，从机在高电平期间读取SDA数据线上的数据，这正是I2C总线的主机向从机写数据行为。</p><p>但是在①处，由于从机需要执行一些耗时操作（例如从机内部<code>E2PROM</code>写入行为），因此必须拽住SCL时钟，防止主机继续发送导致数据丢失、通信失败。</p><p>主机在经过B、C之间的数据建立时间后，主动释放时钟线想要让SCL被上拉到高电平进行数据采样。但是释放后主机发现SCL并没有按照预期升到高电平，于是推测目前有从机正在进行时钟拉伸动作，于是主机便等待并定时轮询SCL状态。</p><p>等到从机释放SCL后，后续通信流程正常进行。上述就是一次I2C时钟拉伸的流程。</p><p>这里我再强调下I2C时钟拉伸的时机：<strong>时钟拉伸是发生在SCL低电平期间的！也就是时钟拉伸发生的同时主机也是在拉低SCL的</strong>。从机不能够在SCL高电平期间拉低SCL!因为I2C中高电平是采样时间，如果从机提前拉低SCL会产生一个下降沿，相当于新产生了一个时钟边沿，破坏了主机时钟的完整性，会导致后续通信出问题！</p><hr><h5 id="中断服务函数注意事项"><a href="#中断服务函数注意事项" class="headerlink" title="中断服务函数注意事项"></a>中断服务函数注意事项</h5><p>中断ISR是硬实时上下文，阻塞中断会导致整个系统挂起，因此我们在编写ISR时要做到<strong>快、短、安全、可重入</strong>。</p><ul><li>中断内部不要调用延时或阻塞相关的API，会严重破坏系统实时性。</li><li>中断内部不要调用不可重入API，标准C的<code>malloc</code>就是个典型例子，<code>malloc</code>是非线程安全的，假如主循环中某处<code>malloc</code>调用被ISR中断了，而在ISR中又调用<code>malloc</code>，很容易会导致堆结构损坏。</li><li>对于一些需要在中断中修改，主程序判断使用的全局变量，请加上<code>volatile</code>。因为编译器在编译主循环代码时是感知不到ISR的，因此在某些极端条件下会过度优化导致程序逻辑出错。加上<code>volatile</code>禁止编译器进行重排和缓存。</li><li>记得及时清除中断标志，正确做法是进入ISR后应首先清除标志再进行逻辑，否则可能会因为某些路径提前退出ISR或忘记清除标志导致无限ISR风暴。</li><li>注意栈空间。ISR上下文使用的是MSP主栈指针，是会累积压栈的。什么叫累积压栈？举个例子：<br>当你从<code>main</code>中调用 <code>funcA()</code>，内部再调用<code>funcB()</code>时，你的调用栈是这样的：<code>main-&gt;funcA()-&gt;funcB()</code>。<br>这一整个调用链上的每个函数的内核通用寄存器以及栈局部数据结构都是压在MSP上的(裸机示例)，此时<code>funcB()</code>被ISR中断，ISR的整个栈是直接接着MSP中的<code>funcB()</code>继续往后压的。如果你的栈已经在前续调用中被使用得差不多了，此时ISR压上来很可能会栈溢出。这是个比较隐蔽的问题，要注意。</li><li>中断中不要进行复杂的逻辑处理和运算。这一点可以和第一点归于一类，都违反了中断的快、短准则，会影响系统实时性。要利用好中断下半段处理，将耗时操作挪到中断后半段去（例如FreeRTOS，在PendSV中进行任务切换，这其实也是利用了中段下半部分的处理机制）。</li></ul><hr><h5 id="I2C-死锁"><a href="#I2C-死锁" class="headerlink" title="I2C 死锁"></a>I2C 死锁</h5>]]>
    </content>
    <id>https://r6blog.online/2026/09/22/%E5%B5%8C%E5%85%A5%E5%BC%8F2026092201/</id>
    <link href="https://r6blog.online/2026/09/22/%E5%B5%8C%E5%85%A5%E5%BC%8F2026092201/"/>
    <published>2026-09-22T03:01:57.000Z</published>
    <summary>
      <![CDATA[<h4 id="前言"><a href="#前言" class="headerlink" title="前言"></a>前言</h4><p>本偏文章主要用于记录一些自己平时看到的觉得不错的笔面试题目，虽然偏八股但是仔细研究一下还是能从里面学到不少门道的。长期随缘更新，题目顺序不固]]>
    </summary>
    <title>一些嵌入式笔面试问题收录</title>
    <updated>2026-10-08T07:15:10.247Z</updated>
  </entry>
  <entry>
    <author>
      <name>R6bandito</name>
    </author>
    <category term="网络通信" scheme="https://r6blog.online/categories/%E7%BD%91%E7%BB%9C%E9%80%9A%E4%BF%A1/"/>
    <category term="Note" scheme="https://r6blog.online/tags/Note/"/>
    <category term="LwIP" scheme="https://r6blog.online/tags/LwIP/"/>
    <category term="TCP/IP" scheme="https://r6blog.online/tags/TCP-IP/"/>
    <content>
      <![CDATA[<h4 id="前言"><a href="#前言" class="headerlink" title="前言"></a>前言</h4><p>ARP全称为 <strong>Address Resolution Protocol</strong> 即地址解析协议。我们已经知道，IP网络中有IP地址这一概念。但是需要明白，在以太网环境中，数据帧在以太网上传输靠的是MAC地址，而IP只是逻辑地址负责逐跳传输。数据帧在传输过程中，不仅需要填上IP，还需要填上MAC地址才能正确在网络环境中路由。</p><p>那么在这个流程下，就会出现这样一个问题：<strong>我们知道对端的IP地址，但是不知道MAC地址，IP层在组帧的时候没有MAC组不了，自然这帧数据就无法通过网卡被发送出去</strong>。为了解决这个问题，我们就引入了ARP协议。</p><p>ARP协议的本质其实就是：<strong>通过IP逻辑地址来解析出设备的物理MAC地址</strong>。</p><hr><h4 id="ARP协议简介"><a href="#ARP协议简介" class="headerlink" title="ARP协议简介"></a>ARP协议简介</h4><p>了解ARP，首先得弄清楚其所处的位置。在通常情况下，我们可以认为ARP位于TCP&#x2F;IP四层经典模型（详见<a href="/2026/09/13/%E5%B5%8C%E5%85%A5%E5%BC%8F2026091301/" title="OSI 七层模型与 TCP&#x2F;IP 四层经典模型">OSI七层模型与TCP&#x2F;IP四层经典模型</a>）的网络层，与IP协议并列。</p><p>当我们在局域网中进行通信时，拿到的是目标主机的IP地址，但是IP只是逻辑地址，<strong>下层在通信时使用的是MAC地址</strong>。因此为了保证下一跳能够跳转到正确地址，IP层就会通过ARP协议获得对端的正确MAC地址，进而填入数据包发给下层去路由。</p><p>这里要提前说明一下：<strong>ARP协议只适用于同一网段</strong>，若两台设备位于不同网段，则不能够直接进行交互，需要交由网关进行代劳。</p><hr><h5 id="ARP报文格式"><a href="#ARP报文格式" class="headerlink" title="ARP报文格式"></a>ARP报文格式</h5><p>ARP报文格式如下图所示</p><img src="/2026/09/19/嵌入式2026091902/2026091902_1.webp" style="zoom:150%;" /><p>（<strong>勘误：图中FCS校验部分实际应为4字节，图中笔误写成了6字节，下同</strong>）</p><p>报文中各数据区含义定义如下：</p><table><thead><tr><th align="left">字段</th><th align="left">长度</th><th align="left">说明</th></tr></thead><tbody><tr><td align="left">硬件类型</td><td align="left">2 字节</td><td align="left">以太网为 1</td></tr><tr><td align="left">协议类型</td><td align="left">2 字节</td><td align="left">IPv4 为 0x0800</td></tr><tr><td align="left">硬件地址长度</td><td align="left">1 字节</td><td align="left">MAC 地址长度，6</td></tr><tr><td align="left">协议地址长度</td><td align="left">1 字节</td><td align="left">IP 地址长度，4</td></tr><tr><td align="left">操作码</td><td align="left">2 字节</td><td align="left">1&#x3D;请求，2&#x3D;应答</td></tr><tr><td align="left">发送方 MAC</td><td align="left">6 字节</td><td align="left">请求方的 MAC</td></tr><tr><td align="left">发送方 IP</td><td align="left">4 字节</td><td align="left">请求方的 IP</td></tr><tr><td align="left">目标 MAC</td><td align="left">6 字节</td><td align="left">请求时填 0，应答时填对方 MAC</td></tr><tr><td align="left">目标 IP</td><td align="left">4 字节</td><td align="left">要解析的目标 IP</td></tr></tbody></table><p>这里要注意一下，IP协议与ARP协议是并列的，所以ARP协议的报文直接封装在以太网帧中，而不是像ICMP一样封装在IP数据报中。</p><p>以太网帧头部的帧类型：<code>0x0800</code> 为IP数据包；<code>0x0806</code> 为ARP数据包。在ARP通信中均为<code>0x0806</code>表示该包数据包为ARP包，请协议栈按照ARP的格式进行解析和应答。</p><p>在以太网帧头中有一个目标MAC地址，在ARP数据报中也有一个目标MAC地址，这两个地址是不一样的，注意区分！在ARP请求时，以太网帧的目标MAC会填充为<code>FF:FF:FF:FF:FF:FF</code>，即广播地址。而ARP数据报中的目标MAC以0做占位；ARP回复时ARP应答数据报中的源MAC会被替换为所查询IP设备的物理MAC。这里先提前了解下，后续在讲述ARP流程时会详细阐述。</p><hr><h5 id="ARP工作流程"><a href="#ARP工作流程" class="headerlink" title="ARP工作流程"></a>ARP工作流程</h5><p>这里先引入一个情景：我们处于 <code>192.168.43.0</code> 网段，设备本机IP为 <code>192.168.43.114</code>，MAC地址为 <code>aa:bb:cc:dd:ee:ff</code>。在该网段中也存在一台设备G，其IP地址为 <code>192.168.43.127</code>，MAC地址为 <code>00:11:22:33:44:55</code>。</p><p>当我们要向设备G发送一段UDP数据报时，其流程如下：</p><ul><li><strong>待发数据在传输层打上UDP头部，派发到网络层</strong>。</li></ul><img src="/2026/09/19/嵌入式2026091902/2026091902_2.webp" style="zoom:80%;" /><ul><li><strong>UDP报文进入IP层后，IP在对其进行封装IP数据包时发现对端MAC地址未知，暂时挂起发送请求，并请求一次ARP响应</strong>。此时，ARP流程正式开始。</li></ul><p>协议栈构建一帧ARP报文，将自己的MAC和IP填入到“源MAC”与“源IP”中，并将目标IP填入。对于目标MAC，用0占位。随后将以太网帧头部的MAC硬编码为 <code>FF:FF:FF:FF:FF:FF</code> 广播地址，通过网卡发送出去。具体如下图：</p><p><img src="/2026/09/19/嵌入式2026091902/2026091902_3.webp"></p><p><strong>为什么ARP请求要发广播地址</strong>？</p><p>我们发起ARP请求目的是查询指定IP的MAC地址，因此必须发广播保证该网段下所有设备都能够收到，否则就失去了查询的意义。这里需要注意的是，这个广播只是本地网段广播，不会也不应该被网关转发。</p><ul><li><strong>该网段中所有设备都收到该ARP请求帧，并判断自身是否是被请求IP。如果不是，则记录下发送方的IP和MAC后丢弃该包（这里涉及ARP学习，于下文展开）；如果自身就是被请求IP，则记录发送方后构建ARP应答包回复</strong>。</li></ul><img src="/2026/09/19/嵌入式2026091902/2026091902_4.webp" style="zoom:80%;" /><p>如上图所示，设备A、B收到ARP请求后，发现请求IP并非自己，于是记录发送方后丢弃；设备G收到ARP请求后，发现请求的IP正是自己，于是将请求方的MAC和IP记录下来，同时自身构建一帧ARP应答报文（操作码为2），并正确填入双方信息后单播回我们本机。</p><ul><li><strong>本机接收到ARP应答包，交给协议栈ARP处理分支进行处理，将目标设备的MAC从数据报中提取出来放入ARP缓存表</strong>。</li><li><strong>现在我们本机已经有了目标IP设备的物理MAC地址，解挂之前的UDP数据报，正式封装发送</strong>。</li></ul><p>以上就是一个常规的ARP查询流程。</p><hr><h5 id="ARP缓存表"><a href="#ARP缓存表" class="headerlink" title="ARP缓存表"></a>ARP缓存表</h5><p>当然，如果每发一次数据都要ARP广播找一次设备，那效率就太低了。为了解决这个问题，我们可以很自然的想到将对方的MAC永久记录下来，这样下次直接查表就可以了。但是这又引入了另一个问题：如果表项固定，那么意味着我们每和一台设备通信，就会在内存中记录下该设备。在真正的网络环境中，拓扑往往是比较复杂的，这就意味着我们设备需要花费大量内存空间来存储每一个通信设备的MAC表项。而且设备在网络环境中MAC是可以被修改的，假如同一台设备MAC变了，那按照原表去查到的是旧MAC，那么发送出去的数据包直接就丢在网络环境中了。种种这些都是要解决的问题。</p><p>针对这种情况，协议提供了<strong>ARP缓存表</strong>这一结构。接下来我将以LwIP的实现为例进行阐述。</p><h6 id="表项结构"><a href="#表项结构" class="headerlink" title="表项结构"></a>表项结构</h6><p>ARP缓存表结构本质上是一个C结构体，以下是LwIP中ARP缓存表结构：</p><figure class="highlight c"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br></pre></td><td class="code"><pre><code class="hljs c"><span class="hljs-class"><span class="hljs-keyword">struct</span> <span class="hljs-title">etharp_entry</span> &#123;</span><br><span class="hljs-meta">#<span class="hljs-keyword">if</span> ARP_QUEUEING</span><br>    <span class="hljs-class"><span class="hljs-keyword">struct</span> <span class="hljs-title">etharp_q_entry</span> *<span class="hljs-title">q</span>;</span>   <span class="hljs-comment">/* 挂起的待发数据包队列 */</span><br><span class="hljs-meta">#<span class="hljs-keyword">endif</span></span><br>    <span class="hljs-type">ip4_addr_t</span> ipaddr;          <span class="hljs-comment">/* 目标 IP 地址 */</span><br>    <span class="hljs-class"><span class="hljs-keyword">struct</span> <span class="hljs-title">netif</span> *<span class="hljs-title">netif</span>;</span>        <span class="hljs-comment">/* 从哪个网卡可以到达目标 */</span><br>    <span class="hljs-class"><span class="hljs-keyword">struct</span> <span class="hljs-title">eth_addr</span> <span class="hljs-title">ethaddr</span>;</span>    <span class="hljs-comment">/* 目标 MAC 地址 */</span><br>    <span class="hljs-type">u16_t</span> ctime;                <span class="hljs-comment">/* 存活时间，用于老化 */</span><br>    <span class="hljs-type">u8_t</span>  state;                <span class="hljs-comment">/* 表项状态 */</span><br>&#125;;<br></code></pre></td></tr></table></figure><p>通常，ARP缓存表一个表项的结构应当包含如下字段：</p><ul><li><strong>IP地址(ipaddr)</strong>：该条表项对应的是哪个IP的MAC映射？</li><li><strong>MAC地址(ethaddr)</strong>：表项的核心，表示该IP设备对应的MAC地址。</li><li><strong>类型</strong>：ARP缓存表分为静态类型和动态类型，该字段用于指明该条表项的来源（手动静态配置的&#x2F;学习到的）。</li><li><strong>表项老化时间(ctime)</strong>：表项清扫时间。这里要明白，内存就那么多（尤其是在嵌入式系统中），我们不可能让大量表项常驻在内存中，必须定时对旧的不活跃的连接进行清扫，释放内存。而清扫动作的根据就是表项老化时间。</li><li><strong>网络接口(netif)</strong>：记录该表项对应的对端设备通过哪个网卡可以到达。</li></ul><p>这里你会发现LwIP的实现中并没有类型(type)字段，却多了一个<code>state</code>字段。其实LwIP内部是维护了一个状态机的，而“类型”作为其中一个状态被融合进了里面。关于LwIP的ARP状态机，本篇文章不展开说明。</p><hr><h6 id="动态表项与表项老化"><a href="#动态表项与表项老化" class="headerlink" title="动态表项与表项老化"></a>动态表项与表项老化</h6><p>缓存表分为了<strong>动态表项</strong>和<strong>静态表项</strong>，动态表项一个最大的特征就是具备表项老化的机制。</p><p>缓存表老化本质上就是：<strong>给每条ARP表项设定了一个生命周期，该周期通过每次通信进行重置。当该生命周期超时后将会被降级重新验证或删除以释放空间</strong>。</p><p>缓存表老化是维护系统稳健性的一个关键举措：在网络环境中MAC和IP是可能发生变化的（比如更换网卡&#x2F;IP给另一台设备），而且每个设备自身的内存空间都是有限的。如果表项一直不老化，那么表项越积越多，新旧混杂，占用空间越来越大，将导致内存枯竭或网络帧错误路由。</p><p><strong>缓存表老化流程</strong>：</p><ul><li>当我们通过ARP广播与一台设备建联时，此时ARP缓存表中该表项被正式建立并可用。此时协议栈内部会启动一个定时器记录从此刻开始的老化时间。</li><li>在这个老化时间计数期间，若双方再次发生通信，则老化时间被重置（这是符合预期的，表示对端活跃在线，自然要重置老化时间），重新进行计数；若在此期间未发生通信，则定时器继续计数。</li><li>若老化定时器超时，则该条表项将从就绪状态（<code>STABLE</code>）被撤下，转为待验证状态（状态改为<code>STABLE_REREQUESTING</code>）。此时，LwIP协议栈会立即广播一个ARP请求等待对方应答。若重复几次对方都无应答，则立即删除该表项并释放内存。</li></ul><p>这里要说明一点：上述流程我们是采用LwIP的视角来叙述其行为的，然而在Linux这些现代系统中，其行为略有差异。在Linux中，老化定时器超时后表项状态将由 <code>REACHABLE</code> 变为 <code>STALE</code>，此时Linux并不会像LwIP一样广播ARP，而是继续维护<code>STALE</code>状态，并维护一个stale超时时间，当stale再次超时时该表项将会被删除。在<code>STALE</code>期间，若仍有数据需要发送，内核不会挂起数据等待验证结果，而是先把数据照常发出，同时启动一个短暂的验证窗口（详见下文）。</p><p>更重要的一点是：Linux 在验证机制上比 LwIP 更机智——<code>STALE</code> 表项并不会被周期性地主动保活，只有当它<strong>再次被使用</strong>（也就是恰好有数据要发往这个目标设备）时，内核才会启动验证流程，而且验证的第一步甚至不需要发 ARP：</p><ol><li>状态先由 <code>STALE</code> 转为 <code>DELAY</code>，数据包照常发出；内核在默认 5 秒的窗口内等待”上层反馈”；</li><li>若窗口内上层协议给出了可达性确认（典型如 TCP 收到了对方的 ACK），内核直接认定该表项仍然 <code>REACHABLE</code>——<strong>一个 ARP 包都不需要发</strong>；</li><li>若窗口内没有任何确认，状态转为 <code>PROBE</code>，此时内核才主动发出<strong>单播ARP请求</strong>去探测对端，收到正确应答后恢复为 <code>REACHABLE</code>；连续探测失败则标记为不可达并最终回收。</li></ol><p>这里还有一个容易忽略的细节：<strong>UDP流量触发验证时，必然走到第 3 步</strong>。因为 UDP 天生没有确认机制，5 秒窗口内不可能等到”上层反馈”，所以内核只能老老实实发 ARP 探测。</p><p>而 <code>STALE</code> 条目本身的回收是在 GC 周期中完成的：一段时间内没有被使用过的条目会被直接删除；若近期被使用过，则只会刷新其时间戳，使其继续存活。下面这条抓包记录就是一次 <code>PROBE</code> 探测的过程：</p><figure class="highlight c"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br></pre></td><td class="code"><pre><code class="hljs c"><span class="hljs-number">17</span>:<span class="hljs-number">18</span>:<span class="hljs-number">09.143971</span> <span class="hljs-number">00</span>:<span class="hljs-number">15</span>:<span class="hljs-number">5</span>d:e6:af:b7 &gt; <span class="hljs-number">00</span>:<span class="hljs-number">15</span>:<span class="hljs-number">5</span>d:e6:fc:<span class="hljs-number">69</span>, ethertype <span class="hljs-title function_">ARP</span> <span class="hljs-params">(<span class="hljs-number">0x0806</span>)</span>, length 42: Request who-has 172.18.224.1 tell 172.18.228.235, length 28<br>    <br>17:18:09.144126 00:15:5d:e6:fc:69 &gt; 00:15:5d:e6:af:b7, ethertype <span class="hljs-title function_">ARP</span> <span class="hljs-params">(<span class="hljs-number">0x0806</span>)</span>, length 42: Reply 172.18.224.1 is-at 00:15:5d:e6:fc:69, length 28<br></code></pre></td></tr></table></figure><p>可以看到，该记录正是一次 <code>PROBE</code> 探测：内核为验证该表项是否仍然有效，主动向 <code>172.18.224.1</code> 发出了一个<strong>单播</strong> ARP 请求，对方也正确回复了 ARP 应答，此后该条目恢复为 <code>REACHABLE</code>。相比 LwIP 过期广播重问的做法，Linux 这种策略更节省局域网带宽。</p><p>下面再来看一次完整的实测。实验里我们清空ARP表后先 ping 一次网关把表项建立起来，随后不再做任何操作，静置等待表项自然老化。期间系统后台进行了一次NTP校时（一次典型的UDP流量），恰好触发了上面这套验证流程：</p><figure class="highlight c"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br></pre></td><td class="code"><pre><code class="hljs c"><span class="hljs-comment">// 抓包视角（时间戳为与上一行的间隔）</span><br>+<span class="hljs-number">18.236899</span>  <span class="hljs-number">172.18</span>.<span class="hljs-number">228.235</span>.<span class="hljs-number">35583</span> &gt; <span class="hljs-number">185.125</span>.<span class="hljs-number">190.122</span>.<span class="hljs-number">123</span>: NTPv4, Client, length <span class="hljs-number">188</span><br>            <span class="hljs-comment">// NTP 请求发出（此时表项为 STALE，转发时随即转入 DELAY）</span><br>+<span class="hljs-number">0.189621</span>   <span class="hljs-number">185.125</span>.<span class="hljs-number">190.122</span>.<span class="hljs-number">123</span> &gt; <span class="hljs-number">172.18</span>.<span class="hljs-number">228.235</span>.<span class="hljs-number">35583</span>: NTPv4, Server, length <span class="hljs-number">188</span><br>            <span class="hljs-comment">// NTP 应答到达（UDP 无确认机制，DELAY 窗口不会因此提前结束）</span><br>+<span class="hljs-number">4.823691</span>   <span class="hljs-number">00</span>:<span class="hljs-number">15</span>:<span class="hljs-number">5</span>d:e6:fc:<span class="hljs-number">69</span> &gt; <span class="hljs-number">00</span>:<span class="hljs-number">15</span>:<span class="hljs-number">5</span>d:e6:af:b7, ethertype ARP: Request who-has <span class="hljs-number">172.18</span>.<span class="hljs-number">228.235</span><br>            <span class="hljs-comment">// 网关也向我们发了一个 ARP 请求（网关侧行为，与本机验证流程无关）</span><br>+<span class="hljs-number">0.000015</span>   <span class="hljs-number">00</span>:<span class="hljs-number">15</span>:<span class="hljs-number">5</span>d:e6:af:b7 &gt; <span class="hljs-number">00</span>:<span class="hljs-number">15</span>:<span class="hljs-number">5</span>d:e6:fc:<span class="hljs-number">69</span>, ethertype ARP: Reply<br>            <span class="hljs-comment">// 我们回复网关</span><br>+<span class="hljs-number">0.117068</span>   <span class="hljs-number">00</span>:<span class="hljs-number">15</span>:<span class="hljs-number">5</span>d:e6:af:b7 &gt; <span class="hljs-number">00</span>:<span class="hljs-number">15</span>:<span class="hljs-number">5</span>d:e6:fc:<span class="hljs-number">69</span>, ethertype ARP: Request who-has <span class="hljs-number">172.18</span>.<span class="hljs-number">224.1</span><br>            <span class="hljs-comment">// DELAY 窗口超时转入 PROBE，向网关发出单播 ARP 请求</span><br>+<span class="hljs-number">0.000158</span>   <span class="hljs-number">00</span>:<span class="hljs-number">15</span>:<span class="hljs-number">5</span>d:e6:fc:<span class="hljs-number">69</span> &gt; <span class="hljs-number">00</span>:<span class="hljs-number">15</span>:<span class="hljs-number">5</span>d:e6:af:b7, ethertype ARP: Reply<br>            <span class="hljs-comment">// 网关回复，探测完成</span><br></code></pre></td></tr></table></figure><figure class="highlight c"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br></pre></td><td class="code"><pre><code class="hljs c"><span class="hljs-comment">// 状态视角（ip neigh show 逐秒采样）</span><br><span class="hljs-number">19</span>:<span class="hljs-number">35</span>:<span class="hljs-number">44</span>  <span class="hljs-number">172.18</span>.<span class="hljs-number">224.1</span> dev eth0 lladdr <span class="hljs-number">00</span>:<span class="hljs-number">15</span>:<span class="hljs-number">5</span>d:e6:fc:<span class="hljs-number">69</span> STALE<br><span class="hljs-number">19</span>:<span class="hljs-number">35</span>:<span class="hljs-number">47</span>  <span class="hljs-number">172.18</span>.<span class="hljs-number">224.1</span> dev eth0 lladdr <span class="hljs-number">00</span>:<span class="hljs-number">15</span>:<span class="hljs-number">5</span>d:e6:fc:<span class="hljs-number">69</span> DELAY       <span class="hljs-comment">// NTP 请求触发验证</span><br><span class="hljs-number">19</span>:<span class="hljs-number">35</span>:<span class="hljs-number">52</span>  <span class="hljs-number">172.18</span>.<span class="hljs-number">224.1</span> dev eth0 lladdr <span class="hljs-number">00</span>:<span class="hljs-number">15</span>:<span class="hljs-number">5</span>d:e6:fc:<span class="hljs-number">69</span> REACHABLE   <span class="hljs-comment">// 探测成功，恢复就绪</span><br></code></pre></td></tr></table></figure><p>可以看到，从NTP请求发出到单播ARP出现，前后恰好间隔约 5 秒，状态机完整走了一圈 <code>STALE → DELAY → PROBE → REACHABLE</code>。这里还有一个特别容易误判的点：由于 5 秒后 PROBE 一发即中，<code>PROBE</code> 状态只存在极短的一瞬间，逐秒采样时甚至完全看不到它。如果只看结果，很容易产生”内核在 STALE 很久之后突然自己发 ARP 保活”的错觉——实际上触发它的，往往只是后台一个不起眼的周期性UDP流量（如NTP、SSDP等），并不是内核在主动保活。</p><p>当ARP缓存表已满，但是又需要插入新表项时，会优先淘汰需要验证（也就是已经超时待验证的）表项。若所有表项均处于就绪状态时，则按LRU规则，以ctime老化时间为根据淘汰最旧的动态表项。</p><hr><h6 id="静态表项"><a href="#静态表项" class="headerlink" title="静态表项"></a>静态表项</h6><p>动态表项的设计固然好，但是仍有部分尴尬的问题用动态表项处理起来并不方便：</p><ul><li>某些情况下我们的服务器、固定的上位机等这些设备的IP-MAC映射是不会轻易改变的，如果网段中设备每次与他们通信都从走一遍 “发现&#x2F;验证” 流程的话，将会占用网络带宽，降低通信效率。</li><li>有的设备可能处于安全考虑并不响应ARP（防火墙），或者设备裁切了一个十分精简的TCP&#x2F;IP协议栈，甚至没有ARP处理逻辑。此时根本无法使用动态表逻辑建立有效的连接表项。</li></ul><p>在这种情况下，我们就需要引入<strong>静态表项</strong>来解决问题。<strong>静态表项没有老化机制，由用户手段配置之后其内存永久生效</strong>。</p><p>LwIP中，关于静态表项的实现是采用了一个 <code>ETHARP_STATE_STATIC</code> 状态融入进表项的<code>state</code>字段来实现的。在协议栈内核表项老化处理逻辑中，会优先判断该条目状态是否为 <code>ETHARP_STATE_STATIC</code> ，如果是则直接跳过该条表项的老化检查逻辑（静态表项不允许老化）。其实现类似于下列伪代码：</p><figure class="highlight c"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br></pre></td><td class="code"><pre><code class="hljs c"><span class="hljs-type">void</span> <span class="hljs-title function_">lwip_arp_timeoutLogic</span><span class="hljs-params">( <span class="hljs-type">void</span> )</span><br>&#123;<br>    ....<br>    <span class="hljs-keyword">for</span>( 遍历所有表项 )<br>    &#123;<br>      <span class="hljs-keyword">if</span> ( arp_table[x].state == ETHARP_STATE_STATIC )<br>        <span class="hljs-keyword">continue</span>;<span class="hljs-comment">// 静态表项. 直接跳过老化逻辑.</span><br>        <br>      ....后续老化判断逻辑.<br>    &#125;<br>&#125;<br></code></pre></td></tr></table></figure><p>LwIP内部也提供了对应的API接口来添加&#x2F;删除一条静态ARP条目，由于本篇文章并不深究LwIP内部，因此此处不展开叙述。</p><p>这里要说明一下的是：<strong>静态表项不仅不会老化，还不会被淘汰</strong>。</p><p>当ARP缓存表满却又需要插入新表项时，ARP协议内核并不会动静态表项，而是按上述的淘汰规则来踢出动态表项。当整个ARP表都是静态表项时，新条目将分配失败，返回错误。</p><p>这里给一下静态表项与动态表项的区别：</p><table><thead><tr><th align="left">维度</th><th align="left">动态表项</th><th align="left">静态表项</th></tr></thead><tbody><tr><td align="left"><strong>来源</strong></td><td align="left">ARP 自动学习</td><td align="left">手动配置</td></tr><tr><td align="left"><strong>状态</strong></td><td align="left"><code>STABLE</code> &#x2F; <code>REREQUESTING</code>  (LwIP)</td><td align="left"><code>STATIC</code>   (LwIP)</td></tr><tr><td align="left"><strong>老化</strong></td><td align="left">参与老化，超时降级重请求</td><td align="left"><strong>永不老化</strong></td></tr><tr><td align="left"><strong>淘汰</strong></td><td align="left">表满时可能被 LRU 淘汰</td><td align="left"><strong>永不被淘汰</strong></td></tr><tr><td align="left"><strong>回收</strong></td><td align="left">会被清理</td><td align="left"><strong>不会被清理</strong></td></tr><tr><td align="left"><strong>适用场景</strong></td><td align="left">普通设备通信</td><td align="left">网关、固定上位机、不响应 ARP 的设备</td></tr></tbody></table><p>这里还是要再次强调，静态表项不具备自动感知能力，在更换设备后不会自动更新。如果对端更换了IP-MAC映射，需要手动重新配置或者设计时直接使用动态表项去处理。应只给一些例如网关之类的必要设备配置静态表项，其余设备交给动态表项处理，不能都配置成静态表项。</p><hr><h5 id="ARP学习"><a href="#ARP学习" class="headerlink" title="ARP学习"></a>ARP学习</h5><p>在上文中我们多次提到过ARP学习，前面我们讲ARP工作流程时，本机广播请求，设备G回复应答，本机把设备G的映射存入缓存表——这个过程就叫作<strong>ARP学习</strong>。当然，ARP学习并不只局限于两个指定IP设备之间，实际上任何ARP报文到达时，设备都可以触发学习行为（具体是否学习，取决于协议栈的实现策略）。</p><p>还是回到上文工作流程中的例子：我们设备向本网段广播了一个ARP请求，设备A、B收到该ARP请求包后，发现目标并不是自己，但是ARP报文本身就携带了本机的IP-MAC映射，为什么不顺手存下来？这样的话假如A、B需要和本机之间通信就不用再ARP了。因此设备A、B都会将本机的IP-MAC映射作为新条目加入到各自的ARP缓存表中。</p><p>ARP自主学习行为的好处是很明显的：<strong>能够减少整个网段的ARP次数，提高网络通信效率</strong>。</p><p>不过ARP自主学习是有安全风险的，这也是为什么该功能作为可选功能而不是强制实施再每个设备上。</p><p>若设备无条件信任每一个ARP的IP-MAC映射，那么攻击者只需要伪造一份ARP报文，就能随意改写网段中其他设备的缓存表——这就是<strong>ARP欺骗</strong>。ARP协议本身没有任何认证机制，这个机制带来的副作用在协议层面是无解的。</p><h6 id="ARP欺骗"><a href="#ARP欺骗" class="headerlink" title="ARP欺骗"></a>ARP欺骗</h6><p>ARP攻击方法很简单，一台普通主机就能发出来，主要有两种：</p><ul><li><strong>伪造应答</strong>：将自己伪造为网关，直接广播一帧”网关IP的MAC是我”的ARP应答。收到应答的设备会更新已有表项，于是全段设备的网关映射当场被改写，这是最经典的手法。</li><li><strong>伪造请求</strong>：ARP请求报文同样携带发送方IP-MAC映射，攻击者只要构造一个源信息虚假的请求，收到请求的设备也会顺手把伪造映射记进缓存表。这条路径有时更隐蔽，因为它看起来只是一次普通的询问。</li></ul><p>以冒充网关为例，看看一次广播的打击面到底有多大：所有已存在网关表项的设备，表项会被立即改写。这些设备发往网关的流量（也就是全部出网流量）都会先发给攻击者——从这个意义上讲，一次广播就完成了对<strong>全段设备出向流量</strong>的劫持。若攻击者再开启IP转发，重新将这些流量发回真正的网关，那么就会营造一种网络仍在正常运行的假象，实际上整个网段的流量已经被中间人劫持了。</p><p>不过即便如此，现代网络中大量流量都有<code>HTTPS</code>等加密保护，攻击者拿到的也只是密文，所以现实中纯粹的ARP攻击更多被用于断网DoS，或是把流量牵引到钓鱼页面。</p><h6 id="防护思路"><a href="#防护思路" class="headerlink" title="防护思路"></a>防护思路</h6><p>因此ARP自主学习这一机制在ARP协议中作为可选项给出，LwIP中也提供了编译选项<code>ETHARP_TRUST_IP_MAC</code>用于控制ARP的行为。当然，也有以下的一些方式来进行防护：</p><ul><li><strong>使用静态表项</strong>：正如上文所说，给网关等关键设备配置静态表项，从根本上拒绝动态改写。</li><li><strong>交换机的安全机制</strong>：DHCP Snooping + 动态ARP检测（DAI），由交换机校验ARP报文的合法性、丢弃伪造报文；</li><li><strong>监控工具</strong>：arpwatch 之类的工具持续监听网段内的ARP活动，IP-MAC对应关系变化时及时告警；</li></ul><p>可以看到，ARP的无条件学习问题在协议层面无解，所有防护手段的本质都是在协议之外给它补上信任：要么靠人工配置（静态表项），要么靠网络设备的行为约束（交换机安全机制）。</p><hr><h4 id="结语"><a href="#结语" class="headerlink" title="结语"></a>结语</h4><p>写这篇文章时花了不少时间查阅网络资料，同时根据自己对ARP的理解尽可能的将其叙述清楚。文中涉及到的示例在我的本地环境中已经验证过了一遍，如果您在阅读时发现文章中出现理论错误，还望能够通过邮箱与我联系，帮助我及时修正，不胜感激。</p>]]>
    </content>
    <id>https://r6blog.online/2026/09/19/%E5%B5%8C%E5%85%A5%E5%BC%8F2026091902/</id>
    <link href="https://r6blog.online/2026/09/19/%E5%B5%8C%E5%85%A5%E5%BC%8F2026091902/"/>
    <published>2026-09-19T04:54:59.000Z</published>
    <summary>
      <![CDATA[<h4 id="前言"><a href="#前言" class="headerlink" title="前言"></a>前言</h4><p>ARP全称为 <strong>Address Resolution Protocol</strong> 即地址解析协议。我们已经知道，IP网]]>
    </summary>
    <title>ARP 地址解析协议</title>
    <updated>2026-10-08T07:15:10.247Z</updated>
  </entry>
  <entry>
    <author>
      <name>R6bandito</name>
    </author>
    <category term="杂项" scheme="https://r6blog.online/categories/%E6%9D%82%E9%A1%B9/"/>
    <category term="Note" scheme="https://r6blog.online/tags/Note/"/>
    <content>
      <![CDATA[<p>最近在Windows11上捣鼓WSL2，跑了一个ubuntu的26.04系统。在Windows上启动WSL服务后，发现我blog在本地跑不起来了，即构建后出现以下错误：</p><figure class="highlight c"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br></pre></td><td class="code"><pre><code class="hljs c">INFO  === Checking package dependencies ===<br>INFO  === Checking theme configurations ===<br>INFO  === Registering Hexo extensions ===<br>FATAL Permission denied. You can<span class="hljs-string">&#x27;t use port 4000.</span><br><span class="hljs-string">FATAL Something&#x27;</span>s wrong. Maybe you can find the solution here: https:<span class="hljs-comment">//hexo.io/docs/troubleshooting.html</span><br></code></pre></td></tr></table></figure><p>根据<code>FATAL</code>日志可知我们的 <code>localhost:4000</code> 貌似在引入WSL之后被占用了。</p><p>进一步了解发现：我们的Windows作为宿主机，在启用Hyper-V服务后，系统的部分端口会被Hyper-V占用。终端使用以下命令查看被保留的端口：</p><figure class="highlight shell"><table><tr><td class="gutter"><pre><span class="line">1</span><br></pre></td><td class="code"><pre><code class="hljs shell">netsh int ipv4 show excludedportrange protocol=tcp<br></code></pre></td></tr></table></figure><p>输出</p><figure class="highlight shell"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br><span class="line">19</span><br><span class="line">20</span><br><span class="line">21</span><br><span class="line">22</span><br></pre></td><td class="code"><pre><code class="hljs shell">协议 tcp 端口排除范围<br><br>开始端口    结束端口<br>----------    --------<br>        80          80<br>      3421        3520<br>      3583        3682<br>      3683        3782<br>      3783        3882<br>      3883        3982<br>      3983        4082<br>      4083        4182<br>      4183        4282<br>      4283        4382<br>      4383        4482<br>      4483        4582<br>      4583        4682<br>      4683        4782<br>      5357        5357<br>     50000       50059     *<br><br>* - 管理的端口排除。<br></code></pre></td></tr></table></figure><p>可以发现我们的4000端口处于 3983~4082 之间被保留了。这也是为什么我们的程序跑不起来的原因。</p><p>这里要说明一点：<strong>保留区是动态划分的，也就是说每次重启都会随机划分，所以我们程序端口越高，越不容易和保留区撞车</strong>。</p><p><strong>解决方法：</strong></p><ul><li>将我们程序端口开在保留区之外的区域，例如4800以上（4783 以上大片空闲，不容易撞上保留区）。</li><li>修改动态端口范围</li></ul><figure class="highlight shell"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br></pre></td><td class="code"><pre><code class="hljs shell">netsh int ipv4 set dynamicport tcp start=55000 num=10536<br>netsh int ipv6 set dynamicport tcp start=55000 num=10536<br></code></pre></td></tr></table></figure><p>以上两行命令可以将动态端口保留区强制限制在 55000 ~ 65536 这个区间，这样就不容易和我们的程序冲突。</p><ul><li>对于我们一些常用端口，可以强制进行保留。</li></ul><figure class="highlight shell"><table><tr><td class="gutter"><pre><span class="line">1</span><br></pre></td><td class="code"><pre><code class="hljs shell">netsh int ipv4 add excludedportrange protocol=tcp startport=4000 numberofports=1<br></code></pre></td></tr></table></figure><p>以上命令执行后，port4000将不会被划入保留端口。</p><hr><p>不止是blog，端口随机保留会导致例如代理等服务不可访问，出现一些“有时可用，有时又不可用”的灵异问题。后续若再出现此类类似问题，应先从这方面考虑。</p>]]>
    </content>
    <id>https://r6blog.online/2026/09/19/%E5%B5%8C%E5%85%A5%E5%BC%8F2026091901/</id>
    <link href="https://r6blog.online/2026/09/19/%E5%B5%8C%E5%85%A5%E5%BC%8F2026091901/"/>
    <published>2026-09-19T00:35:06.000Z</published>
    <summary>
      <![CDATA[<p>最近在Windows11上捣鼓WSL2，跑了一个ubuntu的26.04系统。在Windows上启动WSL服务后，发现我blog在本地跑不起来了，即构建后出现以下错误：</p>
<figure class="highlight c"><table><tr><td class]]>
    </summary>
    <title>Hyper-V 端口占用问题</title>
    <updated>2026-10-08T07:15:10.247Z</updated>
  </entry>
  <entry>
    <author>
      <name>R6bandito</name>
    </author>
    <category term="语言" scheme="https://r6blog.online/categories/%E8%AF%AD%E8%A8%80/"/>
    <category term="C/C++" scheme="https://r6blog.online/tags/C-C/"/>
    <content>
      <![CDATA[<h4 id="什么是环形缓冲区"><a href="#什么是环形缓冲区" class="headerlink" title="什么是环形缓冲区?"></a>什么是环形缓冲区?</h4><p>嵌入式C中，环形缓冲区是一个<strong>基于数组的简单可靠的环回线性数据存取结构</strong>。核心是通过一个写指针(我习惯叫head)，一个读指针(tail)管理数据的写入和读取，并用循环取模或位与等操作实现回绕的特性。环形缓冲区解决了传统线性缓冲区频繁分配与释放导致的内存碎片、效率低下等问题。</p><p>接下来给一个简单流程示意图例：</p><ul><li><strong>初始时，读写指针均位于缓冲区起始，此时缓冲区为空状态</strong>，如图</li></ul><img src="/2026/09/17/嵌入式2026091701/2026091701_1.webp" style="zoom:80%;" /><ul><li><strong>数据由<code>Head</code>写入，写入后<code>Head</code>索引移动到下一待写入位置。</strong></li></ul><img src="/2026/09/17/嵌入式2026091701/2026091701_2.webp" style="zoom:80%;" /><ul><li><strong>缓冲区中数据由<code>Tail</code>读出，读出后<code>Tail</code>索引移动到下一待读取位置</strong>。</li></ul><img src="/2026/09/17/嵌入式2026091701/2026091701_3.webp" style="zoom:80%;" /><ul><li><strong><code>Head</code>写满后回绕到缓冲区起始，<code>Tail</code>同理</strong>。</li></ul><img src="/2026/09/17/嵌入式2026091701/2026091701_4.webp" style="zoom:80%;" /><p>以上便是环形缓冲区正常工况下数据存取的一个简单模型。内部一些具体细节将在下文展开，上述流程只是为了简单了解下环形缓冲区的工作原理。从上述可看出：</p><ol><li><strong>环形缓冲区本质是一个FIFO队列，先进先出</strong>。</li><li><strong>读写数据时间复杂度均为O(1)，无需移动任何数据</strong>。</li><li><strong>读写索引到缓冲区边界后自动发生回绕</strong>。</li></ol><p>环形缓冲区是嵌入式系统中十分重要且常用的一个数据结构，在<strong>串口收发场景</strong>；<strong>DMA数据缓冲场景</strong>；<strong>传感器数据缓存场景</strong>等均有很广泛的运用。</p><hr><h4 id="环形缓冲区的数据结构"><a href="#环形缓冲区的数据结构" class="headerlink" title="环形缓冲区的数据结构"></a>环形缓冲区的数据结构</h4><p>要设计一个环形缓冲区，有3个要素是必须的：</p><ul><li><strong>缓冲区数组</strong>：这就是我们的缓冲区物理空间，后续我们所有的操作均基于该缓冲区上进行。</li><li><strong>读&#x2F;写索引</strong>：环形缓冲区灵魂所在，利用两个索引的平移和回绕在线性数组上天然实现环形特性。注意我们这里一直说的是“索引”，所以本质其实应该是一个u16&#x2F;u32变量，不要定义为指针类型复杂化问题！</li></ul><p>这里提前说明一下：还有一个要素是 <strong>有效数据长度</strong> ，但是该要素是否必须取决于你的缓冲区实现策略，这里我使用的是<strong>牺牲槽判空法</strong>的策略，因此不需要该元素。</p><p>通过上面的叙述，我们可以定义出一个结构如下：</p><figure class="highlight c"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br></pre></td><td class="code"><pre><code class="hljs c"><span class="hljs-meta">#<span class="hljs-keyword">define</span> RING_BUF_SIZE(64u)</span><br><span class="hljs-keyword">typedef</span> <span class="hljs-class"><span class="hljs-keyword">struct</span> &#123;</span><br>    <span class="hljs-type">uint8_t</span> buffer[RING_BUF_SIZE];<span class="hljs-comment">/* 缓冲区 */</span><br>    <span class="hljs-type">uint16_t</span> head;<span class="hljs-comment">/* 写索引 */</span><br>    <span class="hljs-type">uint16_t</span> tail;<span class="hljs-comment">/* 读索引 */</span><br>&#125; rBuf_t;<br></code></pre></td></tr></table></figure><p>每向缓冲区写一次数据，<code>head</code>索引步进一格；每从缓冲区读一次数据，<code>tail</code>索引步进一格。这个流程是明确且易懂的，但是这其中涉及到几个问题需要考虑清楚：怎么判断缓冲区是空状态？怎么判断缓冲区是满状态？回绕具体是怎么个回绕法？接下来我们就来详细讲讲。</p><hr><h4 id="环形缓冲区判空判满策略"><a href="#环形缓冲区判空判满策略" class="headerlink" title="环形缓冲区判空判满策略"></a>环形缓冲区判空判满策略</h4><p>关于状态判断，你可能会这么想：“既然是环形缓冲区，那么当<code>head</code>追上<code>tail</code>时不就满了吗？那么等量关系很简单直接就是 <code>head == tail</code> 。” 这么想其实没错，但是忽略了一个前提：我们在初始化状态(也就是初始空状态)时已经满足等量关系 <code>head == tail</code> 。若 <code>head == tail</code> 也用来判满，那么会出现一个等量关系对应两种不同的状态，这肯定是不能成立的。</p><p>因此我们需要一个办法来区分空和满状态，这里有三种常见方法。这里详细讲讲我使用最多的方法：</p><ul><li><strong>牺牲一个空槽位进行判满</strong>。</li></ul><p>顾名思义，该方法的核心思想是：<strong>永久牺牲掉一个槽位用于判满操作，例如我们缓冲区大小为64个槽，那么在该方法下，我们最多可用的空间只有63个槽位</strong>。</p><p>原理是这样的，既然 <code>head == tail</code> 无法使用，那么我们使用 <code>head + 1 == tail</code> 不就可以了吗？在写入槽位之前提前判断下一个槽位是不是读索引，如果是那么说明除开当前这个空槽之外，缓冲区已经满了。此时我们牺牲掉这个空位置，并抛出缓冲区满事件供上层处理。</p><img src="/2026/09/17/嵌入式2026091701/2026091701_5.webp" style="zoom:80%;" /><p>上图示例中，缓冲区总大小 <code>Size == 8</code>。但是在该方法下可用的大小永远只有7个槽。</p><p>Ps：这里要强调下，判满条件不能直接写 <code>head + 1 == tail</code> ，我们要将回绕考虑进去，因此正确的逻辑应该是 <code>(head + 1) % Size == tail</code>。上述的写法是我未将回绕考虑进去的简写，注意区分。</p><p>牺牲一个空槽位的方法在嵌入式实践中比较常见，因为其不需要维护额外的变量，简单可靠。其代价仅仅只是浪费一格存储单元，这个代价我们基本可以忽略不计。</p><ul><li><strong>维护一个计数变量进行判满</strong>。</li></ul><p>如前文所述，我们在缓冲区结构中可以多维护一个<strong>有效数据长度</strong>的要素。如下</p><figure class="highlight c"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br></pre></td><td class="code"><pre><code class="hljs c"><span class="hljs-meta">#<span class="hljs-keyword">define</span> RING_BUF_SIZE(64u)</span><br><span class="hljs-keyword">typedef</span> <span class="hljs-class"><span class="hljs-keyword">struct</span> &#123;</span><br>    <span class="hljs-type">uint8_t</span> buffer[RING_BUF_SIZE];<span class="hljs-comment">/* 缓冲区 */</span><br>    <span class="hljs-type">uint16_t</span> head;<span class="hljs-comment">/* 写索引 */</span><br>    <span class="hljs-type">uint16_t</span> tail;<span class="hljs-comment">/* 读索引 */</span><br>    <span class="hljs-type">uint16_t</span> count;<span class="hljs-comment">/* 缓冲区中有效数据条目计数 */</span><br>&#125; rBuf_t;<br></code></pre></td></tr></table></figure><p>每当往缓冲区写入一个数据时，<code>count++</code>；从缓冲区读出一个数据时，<code>count--</code>。可用 <code>RING_BUF_SIZE == count ?</code> 来判断缓冲区是否已满。 用 <code>count == 0</code> 来判断缓冲区是否已空。</p><p>这个方法就是多维护一个变量，多一次非原子的读写操作（生产者和消费者均需要访问该变量），但是只要保证在临界区操作或串行化访问的话，其实并不会出任何问题。这种方式其实并没有什么太大的弊端，也比较直观，所以可以采用该方法实现，不过我个人还是习惯上一种方式。</p><ul><li><strong>镜像指示，标志翻转判满</strong>。</li></ul><p>这个和第二个有些类似，需要在缓冲区结构中维护一个标志位flag。</p><figure class="highlight c"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br></pre></td><td class="code"><pre><code class="hljs c"><span class="hljs-meta">#<span class="hljs-keyword">define</span> RING_BUF_SIZE(64u)</span><br><span class="hljs-keyword">typedef</span> <span class="hljs-class"><span class="hljs-keyword">struct</span> &#123;</span><br>    <span class="hljs-type">uint8_t</span> buffer[RING_BUF_SIZE];<span class="hljs-comment">/* 缓冲区 */</span><br>    <span class="hljs-type">uint16_t</span> head;<span class="hljs-comment">/* 写索引 */</span><br>    <span class="hljs-type">uint16_t</span> tail;<span class="hljs-comment">/* 读索引 */</span><br>    <span class="hljs-type">uint16_t</span> flag;<span class="hljs-comment">/* 标志位(应初始化为0) */</span><br>&#125; rBuf_t;<br></code></pre></td></tr></table></figure><p>当初始为空状态时，我们用 <code>(head == tail) &amp;&amp; (flag == 0)</code> 可判断当前缓冲区为空；当我们往缓冲区写入数据时，该次写入完毕后若 <code>head == tail</code> 则表示<strong>写索引</strong>追上了<strong>读索引</strong>，此时我们应将 <code>flag = 1</code> 表示缓冲区已满并向上层抛出一个事件；同样的，当本次读取完毕后若 <code>head == tail</code> 则表示读索引追上了写索引，应将 <code>flag = 0</code> 表示缓冲区为空。</p><p>镜像指示位法的优势在于<strong>单生产者单消费者场景下天然无锁安全</strong>：<code>flag</code> 只在“写追上读”时被写方置 1，只在“读追上写”时被读方置 0，不存在竞态。缺点是无法直接知道当前有多少数据。</p><p>这个方式了解一下即可，我个人并不建议使用这种方式，因为该方式类似于是上一个的下位替代，唯一的线程安全优势其实并不是那么绝对——在可能存在竞争的场景下我们均会采取临界区等手段来规避风险，所以在该种场景下采用<code>count</code>其实也是安全的，还能够精确进行计数。</p><hr><h4 id="环形缓冲区绕回特性"><a href="#环形缓冲区绕回特性" class="headerlink" title="环形缓冲区绕回特性"></a>环形缓冲区绕回特性</h4><p>缓冲区在物理上是线性的，因此要实现环形缓冲，自动回绕就必须在软件逻辑上下功夫。我们通常使用对索引取余的方式来完成回绕，其计算公式如下：</p><figure class="highlight c"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br></pre></td><td class="code"><pre><code class="hljs c">关于写索引： (head + <span class="hljs-number">1</span>) % Size<br>关于读索引： (tail + <span class="hljs-number">1</span>) % Size<br>其中，Size为缓冲区大小.<br></code></pre></td></tr></table></figure><p>举个例子：我们有一个32槽位的缓冲区，已经装了29个数据，其布局如下所示。目前<code>head</code>的值为31(注意不是30，因为写索引指向的是下一个待写的槽位)。</p><img src="/2026/09/17/嵌入式2026091701/2026091701_6.webp" style="zoom:80%;" /><p>当再次发生写入操作时，该包数据被放入head指向的最后一个槽位(Buf[31])，随后执行 <code>(head + 1) % Size</code>更新索引。<code>head + 1 = 32；32 % 32 = 0</code> 看见了吗，索引自动的正确回绕到了Buf[0]。后续的写入操作又继续重复上述的缓冲区写入流程。<code>tail</code>读取索引也是同样的回绕方式。</p><p>这种取余的方式进行回环是通用且常见的方式，接下来介绍另一种效率更高的方式。</p><ul><li><strong>通过按位与(&amp;)操作进行逻辑绕回。</strong></li></ul><p>这里要说明一下：该方法并不通用，只有在缓冲区大小<code>Size</code>为2的幂等数情况下才可以使用。这是因为<strong>只有当<code>Size</code>是2的幂时，<code>size - 1</code>的二进制才是全1，按位与才能等价于取模。</strong></p><p>其索引更新的计算公式为</p><figure class="highlight c"><table><tr><td class="gutter"><pre><span class="line">1</span><br></pre></td><td class="code"><pre><code class="hljs c">(head + <span class="hljs-number">1</span>) &amp; (Size - <span class="hljs-number">1</span>);<br></code></pre></td></tr></table></figure><p>举个例子：</p><figure class="highlight c"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br></pre></td><td class="code"><pre><code class="hljs c">Size = <span class="hljs-number">8</span>  --&gt; <span class="hljs-number">0b1000</span><br>head = <span class="hljs-number">7</span><br>(head + <span class="hljs-number">1</span>) = <span class="hljs-number">0b1000</span>;<br>(Size - <span class="hljs-number">1</span>) = <span class="hljs-number">0b0111</span>;<br>(head + <span class="hljs-number">1</span>) &amp; (Size - <span class="hljs-number">1</span>) = <span class="hljs-number">0b1000</span> &amp; <span class="hljs-number">0b0111</span>;<br>很明显，最后按位与出来的结果是<span class="hljs-number">0.</span> 索引正确回绕<br></code></pre></td></tr></table></figure><p>这种方式最明显的优势就是速度极快，比通用的取余方式能快出不少，所以在设计缓冲区时其缓冲区大小尽量设置为2的幂等数，这样就能使用该方式进一步提升程序效率。</p><hr><p>环形缓冲区<strong>本质上它就是一段线性数组加上两个索引，靠取模或位与实现逻辑上的首尾相连</strong>；判空判满的重点在于“如何区分空和满”，牺牲槽位法、计数变量法、镜像指示位法各有取舍，选哪个取决于你的场景。回绕是这套机制的灵魂——物理上是线性的，逻辑上却是环形的。</p>]]>
    </content>
    <id>https://r6blog.online/2026/09/17/%E5%B5%8C%E5%85%A5%E5%BC%8F2026091701/</id>
    <link href="https://r6blog.online/2026/09/17/%E5%B5%8C%E5%85%A5%E5%BC%8F2026091701/"/>
    <published>2026-09-17T06:35:09.000Z</published>
    <summary>
      <![CDATA[<h4 id="什么是环形缓冲区"><a href="#什么是环形缓冲区" class="headerlink" title="什么是环形缓冲区?"></a>什么是环形缓冲区?</h4><p>嵌入式C中，环形缓冲区是一个<strong>基于数组的简单可靠的环回线性数据存取结构</]]>
    </summary>
    <title>环形缓冲区(Ring Buffer)</title>
    <updated>2026-10-08T07:15:10.247Z</updated>
  </entry>
  <entry>
    <author>
      <name>R6bandito</name>
    </author>
    <category term="网络通信" scheme="https://r6blog.online/categories/%E7%BD%91%E7%BB%9C%E9%80%9A%E4%BF%A1/"/>
    <category term="Note" scheme="https://r6blog.online/tags/Note/"/>
    <category term="LwIP" scheme="https://r6blog.online/tags/LwIP/"/>
    <category term="TCP/IP" scheme="https://r6blog.online/tags/TCP-IP/"/>
    <content>
      <![CDATA[<h4 id="前言"><a href="#前言" class="headerlink" title="前言"></a>前言</h4><p>入门网络通信的第一步，自然是IP地址体系。IP这个概念在网络通信中十分重要，是通信能否建立的必须前提。在现实世界里，我们要寄一封信，必须在信封上写清楚地址——哪个省、哪个市、哪条街、几号门。网络通信中也是一样的，每个设备都有自己的一个“门牌号”，数据包从你家送到他家，靠的就是这个地址。</p><p>要准确的送达数据包，在网络环境中每个设备就必须有一个唯一地址，这个地址就是IP地址。</p><p>IP地址分为 <code>IPv4</code> 与 <code>IPv6</code>，目前主流的依然是IPv4，本文所述的IP地址体系也是基于IPv4进行的。</p><p>IPv4地址由32位二进制组成，每个字节(8位)划分成一段，采用点分十进制书写便于阅读（例如：<code>192.168.1.10</code>）。一个IP地址内部包含两层信息：<strong>网络号</strong>与<strong>主机号</strong>。</p><p><strong>网络号</strong>有点类似于小区中的楼栋，每一个网络号对应一个网络地址，也就是小区中的一个单元楼。楼里面有许多房间，每个房间就住着一个主机，也就是我们所说的<strong>主机号</strong>。同一单元楼的主机可以互相“串门”，但是不同单元楼的主机如果需要互相通信，则需要找门卫，也就是我们所说的网关代为传达。这里我们是以现实中小区进行一个比拟便于理解，实际行为也确实是这样的。</p><p>下面就以此为基础，详述IPv4的地址体系。</p><hr><h4 id="IPv4地址体系"><a href="#IPv4地址体系" class="headerlink" title="IPv4地址体系"></a>IPv4地址体系</h4><h5 id="IPv4地址的表示"><a href="#IPv4地址的表示" class="headerlink" title="IPv4地址的表示"></a>IPv4地址的表示</h5><p>地址的表述我们在前言其实已经讲过了，这里再说明一下。IPv4地址本质是一个 <strong>32位无符号整数</strong>：</p><figure class="highlight c"><table><tr><td class="gutter"><pre><span class="line">1</span><br></pre></td><td class="code"><pre><code class="hljs c"><span class="hljs-number">11000000</span> <span class="hljs-number">10101000</span> <span class="hljs-number">00000001</span> <span class="hljs-number">00001010</span><br></code></pre></td></tr></table></figure><p>为了便于表示，我们将其每字节隔开，采用点分十进制表述如下：</p><figure class="highlight c"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br></pre></td><td class="code"><pre><code class="hljs c"><span class="hljs-number">11000000</span> --&gt; <span class="hljs-number">0</span>d192<br><span class="hljs-number">10101000</span> --&gt; <span class="hljs-number">0</span>d168<br><span class="hljs-number">00000001</span> --&gt; <span class="hljs-number">0</span>d1<br><span class="hljs-number">00001010</span> --&gt; <span class="hljs-number">0</span>d10<br><span class="hljs-comment">// 点分拼接后如下.</span><br><span class="hljs-number">192.168</span>.<span class="hljs-number">1.10</span><br></code></pre></td></tr></table></figure><p>IPv4 地址总量有 <code>2^32 = 4,294,967,296</code>，约合 42.9亿。别看这么多，目前是已经枯竭了的，当前网络环境普遍采用了NAT技术来重映射IP地址，并划分公网与私网段。</p><p>关于该技术详见：<a href="/2026/09/14/%E5%B5%8C%E5%85%A5%E5%BC%8F2026091401/" title="NAT 地址转换">NAT 地址转换</a>。</p><hr><h5 id="IPv4相关核心概念"><a href="#IPv4相关核心概念" class="headerlink" title="IPv4相关核心概念"></a>IPv4相关核心概念</h5><p>在详细了解IP地址之前，需要先厘清几个概念：</p><p><strong>网络号</strong>与<strong>主机号</strong>：一个IP地址会被子网掩码划分为两个区域，分别为网络号和主机号。当IP地址中主机号全为0时，其代表的就是<strong>网络地址</strong>，标识的是整个网段的起始地址。<strong>主机号</strong>就是该网段中某一设备的编号。</p><p><strong>子网掩码</strong>是目前划分网络地址与主机地址的“度量衡”。在当前网络环境中，普遍使用的是CIDR无类地址（详见下文）划分机制，其子网掩码可以按如下形式表示：</p><figure class="highlight c"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br></pre></td><td class="code"><pre><code class="hljs c"><span class="hljs-number">192.168</span>.<span class="hljs-number">1.10</span>/<span class="hljs-number">24</span><br>CIDR 划分： 前<span class="hljs-number">24</span>位为网络位，后<span class="hljs-number">8</span>位为主机位.<br>其子网掩码为 网络位全<span class="hljs-number">1</span>，主机位全<span class="hljs-number">0.</span> 即：<br><span class="hljs-number">255.255</span>.<span class="hljs-number">255.0</span><br></code></pre></td></tr></table></figure><p>知道子网掩码后，我们就可以给出精确的网络地址与主机地址的划分机制：</p><p><strong>使用IP地址与子网掩码进行与(&amp;)运算，其运算结果就是网络地址。</strong></p><p>例如：</p><figure class="highlight c"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br></pre></td><td class="code"><pre><code class="hljs c"><span class="hljs-number">192.168</span>.<span class="hljs-number">43.1</span>/<span class="hljs-number">24</span><br>子网掩码：<span class="hljs-number">255.255</span>.<span class="hljs-number">255.0</span><br><span class="hljs-number">192.168</span>.<span class="hljs-number">43.1</span> &amp; <span class="hljs-number">255.255</span>.<span class="hljs-number">255.0</span> = <span class="hljs-number">192.168</span>.<span class="hljs-number">43.0</span><br><span class="hljs-number">192.168</span>.<span class="hljs-number">43.0</span>  即为网络地址.<br></code></pre></td></tr></table></figure><p>主机号自然就是剩下的8位，总共就<code>2^8 = 256</code>个主机地址。值得注意的是：<strong>子网掩码还用来区分网段</strong>。如何确定两个设备是否处于同一网段？就用两个设备的IP地址分别去与（&amp;）上子网掩码，若与出来的网络地址相同则说明两个设备处于同一网段。</p><p><strong>广播地址</strong>是主机号全为1的地址，其作用是向本网段内所有设备广播数据。广播地址是一个特殊的地址，不能单独分给某一个设备。例如上述示例中：<code>192.168.43.0</code>这个网段的广播地址就在<code>192.168.43.255</code>。当该网段内某个设备向该地址发送一个数据包后，整个地址位于<code>192.168.43.x(x!=0 &amp;&amp; x!= 255)</code>都能够收到该包数据。</p><p><strong>可用主机范围</strong>是该网段中，所有能够划给使用使用的具体IP地址的一个范围。这其中需要剔除掉本网段广播地址与网络地址。例如在<code>192.168.43.x</code>网段中，需要剔除掉<code>192.168.43.0(网络地址)</code>和<code>192.168.43.255(广播地址)</code>。剩下的可分配地址范围为<code>192.168.43.1~192.168.43.254</code>，这就是可用的主机地址范围。</p><p><strong>网关</strong>：网关是出网段的“大门”，<strong>不同网段之间需要通信必须经过网关转发</strong>。同时，网络拓扑有本地局域网与公网之分，本地局域网中的设备想要与公网服务器进行通信其流量必须经过本地网关出站，外部公网服务器回复的流量也必须经过本地网关入站才能路由到本地局域网的指定设备。</p><p>可以把网关理解为一栋“楼”的“楼长”，楼与楼之间的通信事务由网关进行管理，不能让楼中的“居民”直接插手楼间通信事务。</p><hr><h5 id="IP地址的分类"><a href="#IP地址的分类" class="headerlink" title="IP地址的分类"></a>IP地址的分类</h5><h6 id="有类地址"><a href="#有类地址" class="headerlink" title="有类地址"></a>有类地址</h6><p>早期，IP地址被划分为了五类地址，称作有类地址。如下表所示：</p><table><thead><tr><th align="left">类别</th><th align="left">首位</th><th align="left">第一字节范围</th><th align="left">默认掩码</th><th align="left">用途</th></tr></thead><tbody><tr><td align="left"><strong>A</strong></td><td align="left">0</td><td align="left">1 ~ 126</td><td align="left"><code>/8</code></td><td align="left">超大型网络</td></tr><tr><td align="left"><strong>B</strong></td><td align="left">10</td><td align="left">128 ~ 191</td><td align="left"><code>/16</code></td><td align="left">中型网络</td></tr><tr><td align="left"><strong>C</strong></td><td align="left">110</td><td align="left">192 ~ 223</td><td align="left"><code>/24</code></td><td align="left">小型网络</td></tr><tr><td align="left"><strong>D</strong></td><td align="left">1110</td><td align="left">224 ~ 239</td><td align="left">—</td><td align="left">组播</td></tr><tr><td align="left"><strong>E</strong></td><td align="left">1111</td><td align="left">240 ~ 255</td><td align="left">—</td><td align="left">保留&#x2F;实验</td></tr></tbody></table><p>比如我们家庭常见的<code>192.168.1.2</code>等等这类IP地址就属于C类地址，用于小型网络。一些网络例如<code>10.124.12.10</code>这类地址就属于A类大型网络。</p><p>但是目前这种分类已被废弃，原因是地址划分过于死板，不灵活。举个例子：假如南京某高校使用了A类地址，其网络地址为<code>10.0.0.0</code>，让我们算一下该网段拢共支持多少设备：</p><figure class="highlight c"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br></pre></td><td class="code"><pre><code class="hljs c">按掩码为 <span class="hljs-number">255.0</span>.<span class="hljs-number">0.0</span> 来算,其主机位有<span class="hljs-number">24</span>位.<br><span class="hljs-number">2</span>^<span class="hljs-number">24</span> - <span class="hljs-number">2</span> = <span class="hljs-number">16</span>,<span class="hljs-number">777</span>,<span class="hljs-number">214.</span><br></code></pre></td></tr></table></figure><p>看到了吗？一个网段能容纳1670万台设备，实际上远远用不到这么多。</p><p>这就说明旧式五类划分，要不就划分过大浪费；要不就划分过小不满足，例如C类地址一个网段才 <code>2^8 - 2 = 254</code> 台设备。</p><p>所以现代网络已抛弃有类划分，改用 CIDR。</p><hr><h6 id="CIDR-无类地址"><a href="#CIDR-无类地址" class="headerlink" title="CIDR (无类地址)"></a>CIDR (无类地址)</h6><p>现代地址体系中，已不再按类进行IP地址的划分，取而代之的是CIDR无类地址机制。</p><p>无类地址：即用<code>/n</code>表示一个IP地址中的网络号的位数。也就是说我们可以将任何一个网络切分成一个子网络，按需进行切割。这个机制十分灵活，规避掉了按类型进行划分的弊端。</p><p>例如：</p><figure class="highlight c"><table><tr><td class="gutter"><pre><span class="line">1</span><br></pre></td><td class="code"><pre><code class="hljs c"><span class="hljs-number">192.168</span>.<span class="hljs-number">1.10</span>/<span class="hljs-number">24</span><br></code></pre></td></tr></table></figure><p><code>/24</code>表示该IP地址中，前24位是网络号，后8位是主机号，所以可以计算出该网段中可用主机地址共有<code>2^8 - 2 = 254</code>个，对应原来的C类地址。</p><p>再来看一个示例：</p><figure class="highlight c"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br></pre></td><td class="code"><pre><code class="hljs c"><span class="hljs-number">10.20</span>.<span class="hljs-number">30.40</span>/<span class="hljs-number">12</span><br>--&gt; 子网掩码：<span class="hljs-number">255.240</span>.<span class="hljs-number">0.0</span><br></code></pre></td></tr></table></figure><p>该IP中，第一个字节8位与第二个字节的高4位为网络号(<code>\12</code>)，剩下的20位为该网段中所有的主机号。</p><ul><li><strong>网络地址</strong>：<code>10.20.30.40 &amp; 255.240.0.0 = 10.16.0.0</code>。所以该网段起始地址为：<code>10.16.0.0</code>。</li><li><strong>广播地址</strong>：主机号全1，即：<code>10.31.255.255</code>（注：31是这么来的：0001 1111. 高四位是网络号，低四位主机号全1）。</li><li><strong>可用主机地址范围</strong>：<code>10.16.0.1 ~ 10.31.255.254</code>（去掉网络地址与广播地址）。</li><li><strong>可用主机数目</strong>：<code>2^(32 - 12) - 2 = 2^20 - 2 = 1,048,574</code> 。</li></ul><hr><h6 id="路由表爆炸与超网合并"><a href="#路由表爆炸与超网合并" class="headerlink" title="路由表爆炸与超网合并"></a>路由表爆炸与超网合并</h6><p>当然, CIDR除了让地址划分更灵活之外，还解决了有类时代另一个致命问题——<strong>路由表爆炸</strong>，这是导致有类划分被彻底废弃的根因。路由器在转发数据包时，内部会维护一个路由表——这个表类似于“指路标”一样，指明该包数据下一跳该路由到哪个位置。</p><p>在有类地址时代中，每一类网段都要单独写一条路由。而当时C类网络是全球被使用最多的网络类型，1990s拢共有接近几十万个C类网段。这就意味着核心路由器面临路由表膨胀的问题——路由表的体积极具增大，内存不够、查表变慢、CPU 负载爆炸。如果不解决，互联网会在几年内瘫痪。</p><p>CIDR正是用于解决这个问题的。其解法是<strong>超网合并</strong>：<strong>若多个连续网段下一跳相同，就把它们合并为一个大网段一并路由</strong>。来看个例子：</p><p>某公司有16个网段，这16个网段都接在同一台边界路由器后面。对于外部核心路由器而言，去往这16个网段的下一跳完全相同。其网络拓扑如下：</p><figure class="highlight c"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br></pre></td><td class="code"><pre><code class="hljs c"><span class="hljs-number">192.168</span>.<span class="hljs-number">0.0</span>/<span class="hljs-number">24</span><br><span class="hljs-number">192.168</span>.<span class="hljs-number">1.0</span>/<span class="hljs-number">24</span><br>...<br><span class="hljs-number">192.168</span>.<span class="hljs-number">15.0</span>/<span class="hljs-number">24</span><br></code></pre></td></tr></table></figure><p>在旧式有类地址分类下来看，每个网段都要维护一条路由表，那么核心路由器为该公司就需要维护16个路由表条目。</p><p>但是在<strong>CIDR</strong>的视角下，我们会发现这些网络地址的前20位都是相同的，变化主要集中在20~23位。</p><figure class="highlight c"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br></pre></td><td class="code"><pre><code class="hljs c"><span class="hljs-number">1100</span> <span class="hljs-number">0000</span>(<span class="hljs-number">192</span>)<span class="hljs-number">1010</span> <span class="hljs-number">1000</span>(<span class="hljs-number">168</span>)<span class="hljs-number">0000</span> <span class="hljs-number">0000</span>(<span class="hljs-number">0</span>) <span class="hljs-number">0000</span> <span class="hljs-number">0000</span>(<span class="hljs-number">0</span>) --&gt; <span class="hljs-number">192.168</span>.<span class="hljs-number">0.0</span><br><span class="hljs-number">1100</span> <span class="hljs-number">0000</span>(<span class="hljs-number">192</span>)<span class="hljs-number">1010</span> <span class="hljs-number">1000</span>(<span class="hljs-number">168</span>)<span class="hljs-number">0000</span> <span class="hljs-number">0001</span>(<span class="hljs-number">1</span>) <span class="hljs-number">0000</span> <span class="hljs-number">0000</span>(<span class="hljs-number">0</span>) --&gt; <span class="hljs-number">192.168</span>.<span class="hljs-number">1.0</span><br><span class="hljs-number">1100</span> <span class="hljs-number">0000</span>(<span class="hljs-number">192</span>)<span class="hljs-number">1010</span> <span class="hljs-number">1000</span>(<span class="hljs-number">168</span>)<span class="hljs-number">0000</span> <span class="hljs-number">0010</span>(<span class="hljs-number">2</span>) <span class="hljs-number">0000</span> <span class="hljs-number">0000</span>(<span class="hljs-number">0</span>) --&gt; <span class="hljs-number">192.168</span>.<span class="hljs-number">2.0</span><br>....<br><span class="hljs-number">1100</span> <span class="hljs-number">0000</span>(<span class="hljs-number">192</span>)<span class="hljs-number">1010</span> <span class="hljs-number">1000</span>(<span class="hljs-number">168</span>)<span class="hljs-number">0000</span> <span class="hljs-number">1111</span>(<span class="hljs-number">15</span>) <span class="hljs-number">0000</span> <span class="hljs-number">0000</span>(<span class="hljs-number">0</span>) --&gt; <span class="hljs-number">192.168</span>.<span class="hljs-number">15.0</span><br></code></pre></td></tr></table></figure><p>这时我们可以用<code>/20</code>来将这16条路由合并为1条。即：<code>192.168.0.0/20</code>。现在我们来验算下看看对不对：</p><figure class="highlight c"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br></pre></td><td class="code"><pre><code class="hljs c">子网掩码：<span class="hljs-number">255.255</span>.<span class="hljs-number">240.0</span><br>网络地址：<span class="hljs-number">192.168</span>.<span class="hljs-number">0.0</span><br>广播地址：<span class="hljs-number">192.168</span>.<span class="hljs-number">15.255</span><br>可用地址范围：<span class="hljs-number">192.168</span>.<span class="hljs-number">0.1</span> ~ <span class="hljs-number">192.168</span>.<span class="hljs-number">15.254</span><br></code></pre></td></tr></table></figure><p>看到没有？合并前后地址范围逻辑完全是正确的。但是以前我们需要维护16个表项，现在只需1个表项就OK。整整缩小了16倍！这个效率是很高的。同时还有个隐藏福利：</p><p>合并之前，16个网段，每个网段<code>2^8 - 2 = 254</code>个可用地址。总的下来有<code>254 * 16 = 4064</code>个IP地址可用。</p><p>而CIDR合并之后，<code>2^12 - 2 = 4094</code>个可用地址。为什么会这样？因为合并之前每个网段都有个网络地址与广播地址被占用，拢共有<code>16 * 2 = 32</code>个地址被占用。而合并之后只被占用了2个，那么自然多了30个空余位置出来。</p><p>超网合并的优势是很明显的：</p><ul><li><strong>使得路由表地址缩小</strong>：多条路由压缩成一条，减轻核心路由器负担。</li><li><strong>地址利用率提高</strong>：原来每个 &#x2F;24 浪费 2 个地址，合并后只浪费整个大网段的2个。</li><li><strong>互联网可扩展</strong>：全球路由表从几十万条降到几万条，互联网得以持续扩张。</li></ul><p>Ps：<strong>CIDR超网合并的一个前提是地址连续，这是必要条件</strong>！还是上述公司的例子：如果地址不连续有空洞，即<code>192.168.4.0</code>该网段不属于该公司，那么在合并时不能直接合并为<code>192.168.0.0/20</code>，这么强行合并会把不属于自己的地址也圈进来，导致路由错误。这里尤其要注意。</p><hr><h5 id="IPv4私有地址"><a href="#IPv4私有地址" class="headerlink" title="IPv4私有地址"></a>IPv4私有地址</h5><p>全球有三段公认的私有地址（也可以理解为局域网地址），这些地址在任何局域网段内部都是可以复用的。</p><table><thead><tr><th align="left">类别</th><th align="left">地址范围</th><th align="left">CIDR</th></tr></thead><tbody><tr><td align="left"><strong>A</strong></td><td align="left"><code>10.0.0.0</code> ~ <code>10.255.255.255</code></td><td align="left"><code>10.0.0.0/8</code></td></tr><tr><td align="left"><strong>B</strong></td><td align="left"><code>172.16.0.0</code> ~ <code>172.31.255.255</code></td><td align="left"><code>172.16.0.0/12</code></td></tr><tr><td align="left"><strong>C</strong></td><td align="left"><code>192.168.0.0</code> ~ <code>192.168.255.255</code></td><td align="left"><code>192.168.0.0/16</code></td></tr></tbody></table><ul><li><code>10.0.0.0/8</code>一般用于大型网络（例如校园网等等）需要组建很多子网的场景。</li><li><code>172.16.0.0/12</code>设备数量介于家庭和企业之间，比如一些公司的分支机构。</li><li><code>192.168.0.0/16</code>基本是家庭路由器的默认配置，地址空间小，够用，且不容易和外部网络冲突。</li></ul><p>关于使用规定，并没有强制。只要满足：<strong>使用三段地址之一</strong>；<strong>内网地址不冲突</strong>；<strong>流量出站时经过NAT网关</strong> 就行。</p><p>在家用网络里面你也完全可以给本地设备划分一个<code>10.0.0.0/8</code>，只是完全没有这个必要。</p><hr><h5 id="IPv4特殊地址"><a href="#IPv4特殊地址" class="headerlink" title="IPv4特殊地址"></a>IPv4特殊地址</h5><p>除了私有地址，IPv4还有一批<strong>有特殊用途、不能随便分配</strong>的地址。</p><ul><li><strong>0.0.0.0</strong></li></ul><p>这是本机任意地址的通配(<strong>IP_ADDR_ANY</strong>)，根据不同的场景有不同的用法。</p><p>你比如DHCP请求时，此时本机还没有IP地址，因此使用<code>0.0.0.0</code>进行填充，等待IP分配；同时，当本机作为服务器进行客户端监听时，使用<code>0.0.0.0:80</code>表示监听本机80端口的所有连接。</p><ul><li><strong>127.0.0.0&#x2F;8</strong></li></ul><p>本机本地环回地址。整个 <code>127.0.0.0/8</code> 都是回环地址，最常用的是 <code>127.0.0.1</code>（localhost）。</p><p>在这个地址下，数据包是发不出网卡的，会在内核內部兜一圈后重新发回给自己。只要协议栈正常，Ping<code>127.0.0.1</code>是一定能够通的。</p><p>环回地址只是在测试场景下使用，当移植协议栈之后可以尝试环回给自己发包，如果能正常接收说明协议栈出口和入口都是正常的。正常工况下不应该有设备被分配为环回地址。</p><ul><li><strong>255.255.255.255</strong> &#x2F; <strong>x.x.x.255(定向广播)</strong></li></ul><p>两个都是广播地址，用于向网段广播数据包的。</p><p>对于<code>255.255.255.255</code>：在DHCP发现服务与ARP广播中都有使用，其作用效果仅限本网段，不会被网关转发。也就是说向本网段内所有设备广播，但不能够跨越路由器。</p><p><code>x.x.x.255</code>是定向广播，也是广播的一种，与<code>255.255.255.255</code>的核心区别在于：理论上网关可以转发该数据包，进而广播到别的网段。例如 我们处于网段:<code>192.168.2.0/24</code>，我们可以向另一个网段的广播地址<code>192.168.1.255</code>发包，该包数据经过网关后会进入<code>192.168.1.0/24</code>网段中并且广播给该网段中所有设备。</p><p>不过理论是理论，实际是实际。为了安全起见，现代路由器普遍禁止转发定向广播，因此在常规使用过程中，这两个广播地址的效果其实是等价的。</p><ul><li><strong>169.254.x.x&#x2F;16 (链路本地地址)</strong></li></ul><p>这个地址用于在DHCP分配失败后的临时组网。当我们设备没能通过DHCP获取到地址时，就会从<code>169.254.x.x/16</code>中选出一个可用地址来分配给自己。此时设备只能和同网段其他 <code>169.254.x.x</code> 设备通信，上不了网。</p><p>举个例子：我们家庭网络地址为<code>192.168.43.0/24</code>。而某台设备在向路由器请求DHCP服务时失败，自己给自己分到了<code>169.254.28.6</code>，此时该设备和网段中的其它设备(<code>192.168.43.x</code>)是无法通信的，因为不处于同一个逻辑网段。此时若另一台设备也请求DHCP服务失败，同样给自己分配了一个<code>169.254.28.3</code>。此时，这两台设备处于同一网段，可以相互通信。</p><p>链路本地地址没有网关也上不了网，设备应定期重试DHCP服务，如果你发现你的设备IP地址一直为<code>169.254.x.x</code>，那么多半就是DHCP出问题了。</p><ul><li><strong>224.0.0.0&#x2F;4 (组播地址)</strong></li></ul><p>用于一对多通信。例如视频直播：一个源向一组接收者发送，用组播地址。这里关于组播不展开。</p><hr>]]>
    </content>
    <id>https://r6blog.online/2026/09/14/%E5%B5%8C%E5%85%A5%E5%BC%8F2026091402/</id>
    <link href="https://r6blog.online/2026/09/14/%E5%B5%8C%E5%85%A5%E5%BC%8F2026091402/"/>
    <published>2026-09-14T11:34:46.000Z</published>
    <summary>
      <![CDATA[<h4 id="前言"><a href="#前言" class="headerlink" title="前言"></a>前言</h4><p>入门网络通信的第一步，自然是IP地址体系。IP这个概念在网络通信中十分重要，是通信能否建立的必须前提。在现实世界里，我们要寄一封信，必须在信]]>
    </summary>
    <title>IP 地址体系(IPv4)</title>
    <updated>2026-10-08T07:15:10.247Z</updated>
  </entry>
  <entry>
    <author>
      <name>R6bandito</name>
    </author>
    <category term="网络通信" scheme="https://r6blog.online/categories/%E7%BD%91%E7%BB%9C%E9%80%9A%E4%BF%A1/"/>
    <category term="Note" scheme="https://r6blog.online/tags/Note/"/>
    <category term="LwIP" scheme="https://r6blog.online/tags/LwIP/"/>
    <category term="TCP/IP" scheme="https://r6blog.online/tags/TCP-IP/"/>
    <content>
      <![CDATA[<h4 id="引言"><a href="#引言" class="headerlink" title="引言"></a>引言</h4><p>在网络通信中，IP地址是不可或缺的一环，无论是什么通信方式，均离不开IP地址。目前主流的IP地址协议为<code>IPv4</code>，一个IPv4地址由32位二进制组成，在表示上采用点分十进制的拆分成四段进行表示。让我们来计算下拢共有多少个IPv4地址可供分配：<code>2^32 - 1 ≈ 42.9亿</code>，考虑到网络地址、广播地址、保留地址等开销，实际可供分配给主机的地址还要更少。</p><p>在当今互联网飞速发展的情况下，IPv4地址已经枯竭，<code>IPv6</code>虽然可以从根本上解决IP地址不足的问题，但是目前仍有多数网络设备是基于IPv4的，因此在这个过渡期间就必须得有一个对应的技术来暂时解决这个问题。</p><p>NAT(Network Address Translation) 网络地址转换技术正是于此背景之下诞生的。该技术使每个网段更加独立：也就是网段内部私有域中的设备不再能够直接与互联网通信，而是必须走网关通过NAT转换之后才能与外部互联网建立通信。</p><p><strong>NAT 技术就是在私网地址与公网地址之间相互转换的</strong>，说准确点就是：NAT 技术通过在网关处修改 IP 包的源地址或目标地址，实现私网与公网之间的地址映射。</p><p><strong>多个私网地址可以共用一个公网地址</strong>，这样即保证了网络通信，又节省了公网地址，这就是NAT的优点。</p><hr><h4 id="NAT-做到了什么"><a href="#NAT-做到了什么" class="headerlink" title="NAT 做到了什么?"></a>NAT 做到了什么?</h4><p>这里需要先声明一点：<code>NAT != 网关</code>。NAT与网关是<strong>包含关系</strong>——NAT是网关的一个功能子集。网关除了NAT之外，还能集成 DHCP、DNS、防火墙等网络与安全服务，不能简单认为NAT就是网关。</p><p><img src="/2026/09/14/嵌入式2026091401/2026091401_1.webp"></p><ul><li><strong>NAT 让内网与公网之间无法直接互访</strong>。<strong>内部私有 IP 地址对外不可见，天然隐藏内网拓扑。外网在没有端口映射的情况下无法主动连接到内网设备。</strong></li><li><strong>NAT允许灵活组网。私网段用户可以随意使用，本地局域网段无需申请公网IP，就算发生冲突也只限于该网段内部。</strong></li><li><strong>极大节省公网IP。通过NAPT技术，一个公网IP可以让数十台，甚至上百台设备同时上网。</strong></li></ul><p>目前只要是接入了互联网的网关设备，大部分都集成了NAT技术。</p><p>当然，NAT的引入也带来了一定的副作用：</p><p>破坏了端到端的通信，增大了网关的负载，也使得P2P通信更加困难。以部分联机游戏举个例子，有的游戏提供 <code>P2P</code> 联机模式，理想情况下，联机双方设备只需要知道对方的IP和端口就能够发起直连，这是双向对称的。</p><p>但是，当处于NAT环境下时，由于双方的NAT类型和严格程度不同，所以很可能会出现A发往给B的包，在NAT处被丢掉或反之同理。这就是NAT引入之后带来的不便。</p><p>这里附一个常用私有地址域范围表：</p><table><thead><tr><th align="center">类</th><th align="center">地址范围</th><th align="center">CIDR</th></tr></thead><tbody><tr><td align="center">A</td><td align="center">10.0.0.0 - 10.255.255.255</td><td align="center">10.0.0.0&#x2F;8</td></tr><tr><td align="center">B</td><td align="center">172.16.0.0 - 172.31.255.255</td><td align="center">172.16.0.0&#x2F;12</td></tr><tr><td align="center">C</td><td align="center">192.168.0.0 - 192.168.255.255</td><td align="center">192.168.0.0&#x2F;16</td></tr></tbody></table><p>这三类地址是全球公认的私有地址，本地网段中想怎么使用都行。即使两个不同的公司内部都用了 <code>192.168.1.0/24</code>，只要他们不直接合并网络，就绝不会冲突。</p><p>并且这三类地址也是不可直接路由的，任何公网核心路由器只要看到目标是这三类地址其中之一，就会直接丢弃数据包。所以这些地址只能在局域网内“自娱自乐”，上网必须经过NAT转换。</p><hr><h4 id="NAT-的类型与工作原理"><a href="#NAT-的类型与工作原理" class="headerlink" title="NAT 的类型与工作原理"></a>NAT 的类型与工作原理</h4><h5 id="静态NAT"><a href="#静态NAT" class="headerlink" title="静态NAT"></a>静态NAT</h5><p>静态NAT的规则很简单：<strong>永久将一个内网私有地址映射到一个公网地址</strong>，每个映射在配置时都是写死在NAT表中的。</p><p>如下图所示：</p><p><img src="/2026/09/14/嵌入式2026091401/2026091401_2.webp"></p><p>我们有两个本地设备分别为 <code>192.168.1.1/24</code> 与 <code>192.168.1.2/24</code> 需要上网，在静态NAT的规则下，节点1发送出的数据包(S:192.168.1.1&#x2F;D:112.1.1.1) 经过网关NAT映射后，永久绑定了一个公网IP：<code>200.10.10.1</code>。Server侧收到的是<code>200.10.10.1</code>发来的数据包，当Server要向节点1回复时，是向<code>200.10.10.1</code>这个地址发送数据而不是向<code>192.168.1.1</code>直接发（如果这么发就发到服务端侧自己的本地网段中其它设备去了，很明显错误）！</p><p>Server回复的数据经过NAT重映射之后，目标IP从<code>200.10.10.1</code>被网关修改为了<code>192.168.1.1</code>，随后数据被路由给节点1，正确接收。节点2的收发流程也是同理。</p><p>在本例中：<code>200.10.10.1</code> 与 <code>200.10.10.2</code>这两个公网IP将被节点1和节点2永久占用。</p><p>也就是说一个设备吃掉一个公网IP，这是极其浪费的一种行为。<strong>因此静态NAT模式通常用于服务器这些需要对外提供服务的设备（作为服务器必须保证地址稳定可连接）</strong>。</p><hr><h5 id="动态NAT"><a href="#动态NAT" class="headerlink" title="动态NAT"></a>动态NAT</h5><p>动态NAT维护有一个IP地址池，该池中是目前空闲可使用的公网IP。其本质就是：<strong>从地址池中进行动态分配，谁先上网就先优先分给谁使用，用完后释放</strong>。</p><img src="/2026/09/14/嵌入式2026091401/2026091401_3.webp" style="zoom:80%;" /><p>动态NAT和静态NAT流程上有相似之处。上例中，我们IP池中原本有 <code>200.10.10.1~x</code> 个空闲公网IP，节点1与节点2都需要上网，因此<code>200.10.10.1</code>被分配给了节点1，<code>200.10.10.2</code>被分配给了节点2。</p><p><strong>与静态NAT一样，动态NAT一个公网IP一次只能服务一台设备</strong>，因此池中前两个IP被占用，假如此时节点3上线需要进行通信，那么节点池会将空闲的<code>200.10.10.3</code>分配给节点3使用。当地址池被用尽后，只能等待被占用的公用IP被释放后，其他主机才能使用它访问公网。</p><p>对于动态NAT而言，其实并没有解决公网IP浪费问题，因为本质上依然是一台设备对应一个公网IP。动态NAT定位十分尴尬：它比静态NAT省一点，但没省到点子上；比NAPT差很多，却没有任何额外优势。在NAPT普及后，纯动态NAT已很少单独使用。</p><hr><h5 id="NAPT-端口地址转换"><a href="#NAPT-端口地址转换" class="headerlink" title="NAPT(端口地址转换)"></a>NAPT(端口地址转换)</h5><p>NAPT技术也叫做端口多路复用，是目前应用最广泛的NAT技术，也是最需要仔细了解的技术。NAPT与静态NAT&#x2F;动态NAT不同，<strong>能够真正做到一个公网IP同时使数十台设备同时上网</strong>。</p><p>其原理是：<strong>使用传输层端口号区分不同的内网主机和会话，所有内网设备共享一个（或少量）公网 IP，通过不同的源端口映射出站连接</strong>。</p><p>你比如两台本地设备分别被映射到了公网IP <code>200.10.10.1:50341</code> 和 <code>200.10.10.1:46893</code>，两台设备使用的都是 <code>200.10.10.1</code>这个公网IP，但是流量被接入到了不同端口。若公网Server需要向其中一台设备通信，则只需要向  <code>200.10.10.1:50341/46893</code> 这两个端口发送数据即可。目的IP都是一样的，但是端口号为50341的流量会经NAT转换后被网关路由给设备1，端口号46893则路由给设备2。</p><p>具体见下图：</p><img src="/2026/09/14/嵌入式2026091401/2026091401_4.webp" style="zoom:80%;" /><p>示例中，节点1与节点2分别被分到了公网IP<code>200.10.10.1</code>的50341与46893端口，这两个设备通过一个公网IP上网。当Server回复50341端口时，其数据包来到网关处，NAT查表得到50341映射为本地 <code>192.168.1.1:x</code> 的设备，随后NAT将包中的公网地址修改为本地的地址，交给网关路由到对应设备。整个流程下来Server向<code>200.10.10.1:50341</code>这个地址的回复数据包就被我们本地<code>192.168.1.1:x</code>正确接收到了。</p><p>节点2以及其它更多节点的通信都是同样的道理。</p><hr><h4 id="三种类型之间的简单对比"><a href="#三种类型之间的简单对比" class="headerlink" title="三种类型之间的简单对比"></a>三种类型之间的简单对比</h4><table><thead><tr><th align="left">类型</th><th align="left">映射关系</th><th align="left">是否改端口</th><th align="left">公网 IP 消耗</th><th align="left">典型场景</th></tr></thead><tbody><tr><td align="left"><strong>静态 NAT</strong></td><td align="left">一对一，永久</td><td align="left">否</td><td align="left">1:1，最浪费</td><td align="left">对外服务器</td></tr><tr><td align="left"><strong>动态 NAT</strong></td><td align="left">多对多，动态</td><td align="left">否</td><td align="left">N:M，较浪费</td><td align="left">企业内网</td></tr><tr><td align="left"><strong>NAPT</strong></td><td align="left">多对一，动态</td><td align="left"><strong>是</strong></td><td align="left">N:1，最省</td><td align="left">家用路由器、手机热点</td></tr></tbody></table>]]>
    </content>
    <id>https://r6blog.online/2026/09/14/%E5%B5%8C%E5%85%A5%E5%BC%8F2026091401/</id>
    <link href="https://r6blog.online/2026/09/14/%E5%B5%8C%E5%85%A5%E5%BC%8F2026091401/"/>
    <published>2026-09-14T06:26:40.000Z</published>
    <summary>
      <![CDATA[<h4 id="引言"><a href="#引言" class="headerlink" title="引言"></a>引言</h4><p>在网络通信中，IP地址是不可或缺的一环，无论是什么通信方式，均离不开IP地址。目前主流的IP地址协议为<code>IPv4</code>，一]]>
    </summary>
    <title>NAT 地址转换</title>
    <updated>2026-10-08T07:15:10.247Z</updated>
  </entry>
  <entry>
    <author>
      <name>R6bandito</name>
    </author>
    <category term="网络通信" scheme="https://r6blog.online/categories/%E7%BD%91%E7%BB%9C%E9%80%9A%E4%BF%A1/"/>
    <category term="Note" scheme="https://r6blog.online/tags/Note/"/>
    <category term="LwIP" scheme="https://r6blog.online/tags/LwIP/"/>
    <content>
      <![CDATA[<h4 id="OSI-七层模型"><a href="#OSI-七层模型" class="headerlink" title="OSI 七层模型"></a>OSI 七层模型</h4><p>OSI七层模型，全称是开放系统互连参考模型。是国际标准化组织提出的一个用于管理网络通信的网络分层模型。</p><p>如下表所示，OSI模型十分详尽，理论背书充足。但是也正是因为过于理论这个原因，其实现十分复杂，缺乏实际落地应用的基础，且有的层次划分不尽合理。</p><p>所以在<strong>应用方面实际被广泛使用的是TCP的经典四层模型</strong>。</p><p>实际学习中，对于七层理论模型了解一下即可。</p><table><thead><tr><th align="left">层级</th><th align="left">名称</th><th align="left">核心功能</th><th align="left">常见协议&#x2F;设备</th></tr></thead><tbody><tr><td align="left">第7层</td><td align="left">应用层</td><td align="left">为用户提供网络服务接口</td><td align="left">HTTP、FTP、SMTP</td></tr><tr><td align="left">第6层</td><td align="left">表示层</td><td align="left">数据格式转换、加密、压缩</td><td align="left">SSL&#x2F;TLS、JPEG、ASCII</td></tr><tr><td align="left">第5层</td><td align="left">会话层</td><td align="left">建立、管理、终止会话</td><td align="left">NetBIOS、RPC</td></tr><tr><td align="left">第4层</td><td align="left">传输层</td><td align="left">端到端可靠传输</td><td align="left">TCP、UDP</td></tr><tr><td align="left">第3层</td><td align="left">网络层</td><td align="left">路由选择、逻辑寻址</td><td align="left">IP、ICMP、路由器</td></tr><tr><td align="left">第2层</td><td align="left">数据链路层</td><td align="left">帧封装、MAC寻址、差错检测</td><td align="left">以太网、交换机、PPP</td></tr><tr><td align="left">第1层</td><td align="left">物理层</td><td align="left">比特流传输、电气特性</td><td align="left">网线、光纤、集线器</td></tr></tbody></table><hr><h4 id="TCP-IP-四层经典模型"><a href="#TCP-IP-四层经典模型" class="headerlink" title="TCP&#x2F;IP 四层经典模型"></a>TCP&#x2F;IP 四层经典模型</h4><p>TCP&#x2F;IP 四层模型才是真正的重头戏。与OSI理论模型不同，TCP经典模型是在不断的实践运用中逐渐积累起来的。主要分为以下几个层次：</p><table><thead><tr><th align="left">层级</th><th align="left">对应 OSI 层</th><th align="left">核心功能</th><th align="left">常见协议</th></tr></thead><tbody><tr><td align="left"><strong>应用层</strong></td><td align="left">5+6+7</td><td align="left">用户服务</td><td align="left">HTTP、FTP、DNS、SMTP</td></tr><tr><td align="left"><strong>传输层</strong></td><td align="left">4</td><td align="left">端到端传输</td><td align="left">TCP、UDP</td></tr><tr><td align="left"><strong>网络层</strong></td><td align="left">3</td><td align="left">路由寻址</td><td align="left">IP、ICMP、ARP</td></tr><tr><td align="left"><strong>网络接口层</strong></td><td align="left">1+2</td><td align="left">物理传输</td><td align="left">以太网、Wi-Fi、PPP</td></tr></tbody></table><ul><li><strong>应用层</strong>：囊括了理论模型的会话、表示层，统一收拢到应用层中。常见的上层应用协议（例如HTTP、MQTT、DNS等等）均在此层</li><li><strong>传输层</strong>：这和理论模型第四层是相同的，TCP&#x2F;UDP的“老巢”，负责端到端（你也可以理解为 进程–&gt;进程）之间的数据包寻址。 </li><li><strong>网络层</strong>：同理论模型第三层，主要是IP协议，规定了数据包怎么走，走哪条路。该层还包含了ARP与ICMP等等次生协议用于辅助通信。</li><li><strong>网络接口层</strong>：对应理论模型的1、2层。负责将数据变为光电信号发出，网卡驱动以及物理线缆都属于这一层的范围。</li></ul><p>总的来说，TCP&#x2F;IP 四层把 OSI 的上三层（会话、表示、应用）合并成应用层，下两层（物理、数据链路）合并成网络接口层。这不是简单的“压缩”，而是<strong>按实际工程需要重新划分</strong>——OSI 的会话层和表示层在实际协议栈中几乎没有独立实现，它们的功能被直接塞进了应用层协议里（比如 TLS 做加密、HTTP 管会话）。</p><h4 id="数据封装与解封装流程"><a href="#数据封装与解封装流程" class="headerlink" title="数据封装与解封装流程"></a>数据封装与解封装流程</h4><p>四层模型每一层都对应这一个封装与解封装的过程：</p><ul><li><strong>对于发送方而言，由应用层开始从上至下，每经过一层就加上该层的头部（或尾部），这个过程就叫封装</strong>。</li><li><strong>对于接收方而言，由物理层（接口层）开始从下至上往上递交，每经过一层都要剥去该层的头部（或尾部），这个过程叫解封装</strong>。</li></ul><p>所以总的来说，分层的本质是：<strong>各层只关心自己的头部，只根据自身的头部进行对应操作，而不关心其它层的内容</strong>。其它层的内容相对于它们就视作普通数据负载。</p><p>以下是以HTTP为例的以太网数据包封装与解封装示意图：</p><p><img src="/2026/09/13/嵌入式2026091301/2026091301_1.webp"></p><p>发现了吗，封装流程与解封装流程基本上是一样的，只是方向不同罢了。</p><p>在传输过程中，传输层的PDU单位叫作“段”，也就是我们说的TCP报文段；网络层单位叫作“包”，IP数据包；在接口层叫作帧，以太网帧。了解一下就好。</p><p>关于数据发出与接收的详细流程，本文不做阐述，这些细节将在其余文章进行单独叙述。</p><p><strong>为什么工程上用 TCP&#x2F;IP 而不是 OSI？</strong></p><p>因为OSI 是“<strong>先定标准，再写实现</strong>”，TCP&#x2F;IP 是“<strong>先有实现，再总结标准</strong>”。这就导致：</p><ul><li>OSI 的协议栈复杂、层次过多，实际部署极少；</li><li>TCP&#x2F;IP 经过 ARPANET 和互联网几十年实战检验，实现轻量、兼容性好；</li><li>但 OSI 的分层思想被 TCP&#x2F;IP 完整继承——所以我们理论研究时可以用 OSI 进行阐述和理解，但是落实到实际工程中要用 TCP&#x2F;IP 。</li></ul>]]>
    </content>
    <id>https://r6blog.online/2026/09/13/%E5%B5%8C%E5%85%A5%E5%BC%8F2026091301/</id>
    <link href="https://r6blog.online/2026/09/13/%E5%B5%8C%E5%85%A5%E5%BC%8F2026091301/"/>
    <published>2026-09-13T03:24:51.000Z</published>
    <summary>
      <![CDATA[<h4 id="OSI-七层模型"><a href="#OSI-七层模型" class="headerlink" title="OSI 七层模型"></a>OSI 七层模型</h4><p>OSI七层模型，全称是开放系统互连参考模型。是国际标准化组织提出的一个用于管理网络通信的网络]]>
    </summary>
    <title>OSI 七层模型与 TCP/IP 四层经典模型</title>
    <updated>2026-10-08T07:15:10.247Z</updated>
  </entry>
  <entry>
    <author>
      <name>R6bandito</name>
    </author>
    <category term="嵌入式" scheme="https://r6blog.online/categories/%E5%B5%8C%E5%85%A5%E5%BC%8F/"/>
    <content>
      <![CDATA[<h4 id="引言"><a href="#引言" class="headerlink" title="引言"></a>引言</h4><p>日常开发中，内存的管理自然是不可或缺的一环。例如 Ethernet 中要发送数据包要开辟发送缓冲区，接收数据包时要开辟接收缓冲区，并且使用完毕后需要及时归还，以免出现内存泄漏。这些操作均离不开一个可靠的内存管理机制。</p><p>标准C中已经给我们提供了一套由用户自行管理的内存分配机制，也就是我们常说的堆内存heap（动态分配机制）。但是由标准C提供的这一套机制在嵌入式开发中风险是比较高的，其中主要来自以下几个方面：</p><ul><li><strong>不可重入特性</strong>：如果被竞争访问有很大风险会造成堆结构损坏，堆链断裂。在一些中间件的改造中(例如 FreeRTOS heap_3) 可能解决了这个问题，但是这仅仅只是取决于一些三方的实现。</li><li><strong>容易造成碎片化</strong>：标准C实现是没有前后相邻块合并吞食的，这也就意味着在大量分配与释放的操作下，产生微小难以利用的内存碎片的概率很大，导致程序不稳定。</li><li><strong>内存位置由链接器强行绑定</strong>：标准 C 的堆只有一个——就是由链接器分配的那块。如果想要管理例如 CCM_SRAM这类内存，那么标准C这套管理方法完全无法使用。</li></ul><p>因此在很多情况下，嵌入式中的动态内存分配是被完全禁止的。这就需要我们手动打造一套自身的嵌入式专用的内存管理机制。</p><hr><h4 id="什么是内存堆？"><a href="#什么是内存堆？" class="headerlink" title="什么是内存堆？"></a>什么是内存堆？</h4><p>常规的内存管理机制有 <strong>内存池</strong>、<strong>内存堆</strong> 等实现，内存堆其本质就是：<strong>在局部开辟一块巨大的静态内存数组，然后在这块数组之上，自行实现一套分配、释放、合并的规则</strong>。</p><figure class="highlight c"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br></pre></td><td class="code"><pre><code class="hljs c"><span class="hljs-comment">/* 后续的所有内存堆逻辑都是基于该块内存空间上展开. */</span><br><span class="hljs-type">static</span> <span class="hljs-type">uint8_t</span> __attribute__((aligned(ALIGNED))) ucHeap[HEAP_SIZE];<br></code></pre></td></tr></table></figure><p>和内存池区别在于内存堆能够精细把握块粒度，而内存池只能够固定大小分配。</p><hr><h4 id="内存堆思想"><a href="#内存堆思想" class="headerlink" title="内存堆思想"></a>内存堆思想</h4><p>内存堆的实现有多种变体，这里只阐述我常用的 <code>First Fit(首次适配) + 前后合并</code> 的设计模式。</p><p>这里需要先了解一下内存堆是怎么向用户划分空间的基本流程：</p><ul><li><strong>用户调用 <code>alloc()</code> 向管理器请求一块内存。</strong></li><li><strong>内存堆内部开始遍历所有内存块，直到找到第一块内存空间 &gt; 请求空间的空闲内存</strong>。</li><li><strong>将该块空间取出，将用户所需部分取出标记使用后返回给用户；多余部分返回给内存堆中。</strong></li><li><strong>用户使用完毕后，将空间返回内存堆中，合并前后可能的空闲块，并标记空间空闲。</strong></li></ul><h5 id="块头结构"><a href="#块头结构" class="headerlink" title="块头结构"></a>块头结构</h5><p>要进行管理，自然离不开对应的数据结构。块头结构就类似于”身份证“，每一块空闲或是正在被使用的内存块都需要维护一个该结构，以便管理逻辑能够正确找到它。其内部包含的元素通常需要含有如下几个：</p><ul><li><code>块大小(BlockSize)</code>：这一块空间有多大？用于计算下一块的地址以及与用户申请空间做判断。</li><li><code>next、prev 双向指针</code>：双向指针是必须的，用于前后合并以及内存堆遍历时的正向索引。</li><li><code>使用标志(used)</code>：这块内存目前是正在被使用还是空闲？要弄清楚这个状态我们就必须维护一个使用标记。这个标记也是我们后续分配以及前后合并时的一个重要参考。</li></ul><p>综上所述我们可以拿出如下一个数据结构：</p><figure class="highlight c"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br></pre></td><td class="code"><pre><code class="hljs c"><span class="hljs-keyword">typedef</span> <span class="hljs-class"><span class="hljs-keyword">struct</span> <span class="hljs-title">heapCtrl</span> &#123;</span><br><span class="hljs-type">uint32_t</span> blockSize;<br><span class="hljs-type">uint32_t</span> used;<br><span class="hljs-class"><span class="hljs-keyword">struct</span> <span class="hljs-title">heapCtrl</span> *<span class="hljs-title">next</span>;</span><br><span class="hljs-class"><span class="hljs-keyword">struct</span> <span class="hljs-title">heapCtrl</span> *<span class="hljs-title">prev</span>;</span><br>&#125; heapCtrl_t;<br></code></pre></td></tr></table></figure><p>这里先记住这个结构，后续我会画图来进行阐述，这个结构尤其重要！</p><p>（Ps：这里有个细节要说明一下：尽管used的含义只是布尔型变量，但是此处要使用u32，目的在于结构体内存对齐，便于后续的地址计算。 在MCU中非对齐地址访问风险是很大的!轻则降低效率,重则直接硬件错误）</p><hr><h5 id="快速索引"><a href="#快速索引" class="headerlink" title="快速索引"></a>快速索引</h5><p>接下来我们还需要一个快速索引（不知道这么叫是否合适，但是作用确实是提高效率），这个索引我来打个比方：在TCP&#x2F;IP 的大部分实现中，网络层在查ARP表时往往会全局维护一个最近一次命中的IP地址。这样当我下一次向相同IP发包时，就不需要再去遍历ARP缓存表，而是直接一次命中！这就是我们所谓的<strong>缓存命中</strong>。</p><p>同理，我们在此处的索引也是这个道理：<strong>假如我们每次请求内存都从数组头开始逐块遍历，那其实效率是比较低的。我们维护一个变量专门指向当前最低地址的空闲块，那么后续遍历直接从该块开始向后遍历，就能提高不少效率</strong>。</p><p>这个全局索引我们这么来设计：</p><figure class="highlight c"><table><tr><td class="gutter"><pre><span class="line">1</span><br></pre></td><td class="code"><pre><code class="hljs c"><span class="hljs-type">static</span> <span class="hljs-type">void</span> *minFree_List = <span class="hljs-literal">NULL</span>;<br></code></pre></td></tr></table></figure><ul><li>分配时，从该地址开始后向遍历（该地址前面全是已经使用了的，没必要跑一遍）。</li><li>释放时，若新空闲块地址 &lt; 索引，则更新索引。</li></ul><hr><h5 id="分配策略"><a href="#分配策略" class="headerlink" title="分配策略"></a>分配策略</h5><p>这里来谈谈分配策略。我在之前已经说过，内存堆的实现不是唯一的。在这里，内存堆关于分配算法的实现主要有以下几类：<strong>首次适配（First Fit）</strong>、<strong>最佳适配（Best Fit）</strong>。其中</p><ul><li><strong>首次适配</strong>：<strong>从头开始，找到第一块够大的就行</strong>。这是嵌入式里面的经典实现，FreeRTOS的heap_4以及lwIP的内存堆实现采用的都是首次适配的方法。这个方法速度快，而且实现简单，缺点就是在低地址空间中容易形成碎片。</li><li><strong>最佳适配</strong>：<strong>遍历整个链表，找“刚好够用且最小”的</strong>。这个方法优势很明显，碎片少；但是缺点也显而易见，时间复杂度更大，而且会产生更小的碎片。在FreeRTOS的heap_2中使用的就是该方式（目前heap_2已被heap_4全面替代）。</li></ul><p>我们本文讲解与使用的正是 <strong>首次适配</strong>(First Fit)的方式。</p><hr><h5 id="分裂与合并"><a href="#分裂与合并" class="headerlink" title="分裂与合并"></a>分裂与合并</h5><p><strong>分裂</strong></p><p>这是整个内存堆分配与回收的流程。上述我已经简述了分配的一个基本流程，此处不再赘述。直接上图能更加形象的呈现整个流程：</p><ol><li>刚初始化时，整个内存堆都是空闲的。此时内存结构如下图所示：</li></ol><img src="/2026/09/12/嵌入式2026091201/2026091201_1.webp" style="zoom: 67%;" /><p>其中，heapCTRL为内存块控制头，由于刚初始化没有产生过分配行为，因此只有一个控制头控制着 </p><p><code>(HEAP_SIZE - sizeof(heapCTRL))</code>大小的空闲内存块。</p><ol start="2"><li>我们向初始化后的内存堆请求一块Size大小的空间。内存堆状态如下</li></ol><img src="/2026/09/12/嵌入式2026091201/2026091201_2.webp" style="zoom:67%;" /><p>看到了吗？我们请求一块Size大小的空间，首次分配从整个Free Space中划出来了一块Size大小返回给用户，<strong>同时检查剩余空间是否足以容纳下一个控制头</strong>（<code>heapCTRL</code>）<strong>以及最小数据块</strong>(<code>Minimum_Heap_Size</code>)。如果能够容纳，那么剩下部分被打上控制头后返回给内存堆中，供下一次分配使用。</p><p>这里提一嘴为什么需要设置<code>Minimum_Heap_Size</code>门槛：这是为了防止内存被割得太碎进而无法有效利用。如果当前遍历到的这块空闲空间，划分后剩下部分已经不足以维持一个控制头和最小数据块，那就索引整个分配给用户，不再切割了。</p><p>由于已经发生分配行为，因此我们的<code>minFree_List</code>也得更新到最低地址的空闲块，下次分配行为直接从<code>minFree_List</code>处开始，不再从头开始遍历。</p><p>(Ps：这里要提一下，我们展示的合并与分配链表操作其物理地址在空间上必须是连续的！使用链表结构只是为了更加清晰。你别把所有空闲块都串在一条链表上，而后对逻辑地址进行操作，那么整个就全错了！)</p><figure class="highlight c"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br><span class="line">19</span><br><span class="line">20</span><br><span class="line">21</span><br><span class="line">22</span><br><span class="line">23</span><br><span class="line">24</span><br><span class="line">25</span><br><span class="line">26</span><br><span class="line">27</span><br><span class="line">28</span><br><span class="line">29</span><br><span class="line">30</span><br></pre></td><td class="code"><pre><code class="hljs c"><span class="hljs-comment">/* 判断分配后该块剩余部分是否仍能组成最小单位内存块. */</span><br><span class="hljs-comment">/* 若可以则表示需要切分，split标志置1. */</span><br><span class="hljs-keyword">if</span> ( (ALIGNx((mark-&gt;blockSize - need)) &gt;= MIN_HEAP + <span class="hljs-keyword">sizeof</span>(heapCtrl_t)) )<br>split = <span class="hljs-number">1</span>;<br><br><span class="hljs-keyword">if</span> ( split )<br>&#123;<br>       <span class="hljs-comment">/* 新块切分流程. */</span><br>heapCtrl_t *new = (heapCtrl_t *)(((<span class="hljs-type">uint8_t</span> *)mark + <span class="hljs-keyword">sizeof</span>(heapCtrl_t)) + need);<br>       <span class="hljs-comment">/* 新块块大小(不含控制头). */</span><br>new-&gt;blockSize = (mark-&gt;blockSize - need - <span class="hljs-keyword">sizeof</span>(heapCtrl_t));<br>       <span class="hljs-comment">/* 将新块链入. */</span><br>new-&gt;next = mark-&gt;next;<br>new-&gt;prev = mark;<br>mark-&gt;next = new;<br><span class="hljs-keyword">if</span> ( new-&gt;next != <span class="hljs-literal">NULL</span> )<br>new-&gt;next-&gt;prev = new;<br>       <span class="hljs-comment">/* 更新新块状态与旧块 块大小(blockSize). */</span><br>new-&gt;used = <span class="hljs-number">0</span>;<br>mark-&gt;blockSize = need;<br>&#125;<br>mark-&gt;used = <span class="hljs-number">1</span>;<span class="hljs-comment">/* 标记旧块已被使用. */</span><br><span class="hljs-comment">/* 更新minFree_List. */</span><br><span class="hljs-keyword">if</span> ( minFree_List == (<span class="hljs-type">void</span> *)mark )<br>&#123;<br>heapCtrl_t *q = mark-&gt;next;<br><span class="hljs-keyword">while</span> ( q != <span class="hljs-literal">NULL</span> &amp;&amp; q-&gt;used )<br>q = q-&gt;next;<br>minFree_List = (<span class="hljs-type">void</span> *)q;<br>&#125;<br></code></pre></td></tr></table></figure><p>上面是该段过程的一个参考实现。关键的部分已经给出注释，此处不再赘述。</p><hr><p><strong>合并</strong></p><p>涉及分配，自然也要涉及到归还。归还不是直接将已使用的块的used标志置0，这么做固然可以，但是久而久之会在低地址空间产生大量的细小内存碎片难以利用，更加暴露我们的First Fit的短板。所以需要想一个办法尽量减少微小内存碎片的产生。</p><p>我们的做法是在<strong>内存归还时检查其前后“邻居”，如果“邻居”都是空闲状态，那么为什么我们不将其合并成一整块呢</strong>？</p><p>来看下面：</p><img src="/2026/09/12/嵌入式2026091201/2026091201_3.webp" style="zoom: 67%;" /><p>我们请求分配一块<code>SizeP</code>大小的空间，管理逻辑从<code>minFree_List</code>开始后向遍历，发现n1部分的空间并不满足需求，因此向后继续找到了n2部分，n2满足需求，于是便从n2中取出<code>SizeP + sizeof(heapCTRL)</code>大小的部分用于返回给用户以及新块的控制头建立。对应图中的 ①—&gt;② 这个过程。</p><p>假如我们SizeP部分暂时不需要了，需要归还呢？流程是怎么样的呢？</p><img src="/2026/09/12/嵌入式2026091201/2026091201_4.webp" style="zoom:67%;" /><p>释放时，我们可以先将<code>SizeP</code>（即要归还部分）置空闲状态。也就是由 ① –&gt; ② 状态。</p><p>此时，逻辑后向检查发现：n2部分依然是空闲的，因此将n2向SizeP合并，保留SizeP控制头，调整前后指针逻辑。</p><p>而前向检查，前面一块相邻内存已经被占用，因此不能进行前向合并。</p><p>具体见下面参考示例：</p><figure class="highlight c"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br><span class="line">19</span><br><span class="line">20</span><br><span class="line">21</span><br><span class="line">22</span><br><span class="line">23</span><br><span class="line">24</span><br></pre></td><td class="code"><pre><code class="hljs c"><span class="hljs-comment">/* 后向检查与合并. */</span><br><span class="hljs-keyword">while</span> ( p-&gt;next &amp;&amp; !p-&gt;next-&gt;used )<br>&#123;<br>p-&gt;blockSize += (p-&gt;next-&gt;blockSize + <span class="hljs-keyword">sizeof</span>(heapCtrl_t));<br><span class="hljs-keyword">if</span> ( p-&gt;next-&gt;next )<br>p-&gt;next-&gt;next-&gt;prev = p;<br>p-&gt;next = p-&gt;next-&gt;next;<br>&#125;<br><br><span class="hljs-comment">/* 前向检查与合并. */</span><br><span class="hljs-keyword">while</span> ( p-&gt;prev &amp;&amp; !p-&gt;prev-&gt;used )<br>&#123;<br>p-&gt;prev-&gt;blockSize += (p-&gt;blockSize + <span class="hljs-keyword">sizeof</span>(heapCtrl_t));<br>p-&gt;prev-&gt;next = p-&gt;next;<br><span class="hljs-keyword">if</span> ( p-&gt;next )<br>p-&gt;next-&gt;prev = p-&gt;prev;<br><br>p = p-&gt;prev;<br>&#125;<br><span class="hljs-comment">/* 状态置空闲. */</span><br>p-&gt;used = <span class="hljs-number">0</span>;<br><span class="hljs-comment">/* 检查并更新 minFree_List. */</span><br><span class="hljs-keyword">if</span> ( (minFree_List == <span class="hljs-literal">NULL</span>) || p &lt; (heapCtrl_t *)minFree_List )<br>minFree_List = (<span class="hljs-type">void</span> *)p;<br></code></pre></td></tr></table></figure><p>本文我们展示的是释放时立即合并，其实还有一种合并方法就是 <strong>惰性合并</strong>。</p><p>所谓惰性合并就是指：在内存分配时直接进行合并。例如分配时，切下的空闲块后续仍是空闲，那就立即执行合并而不是等到释放时在进行合并。本质都是一样的，区别在于合并的时机不同，实现不同。</p><hr><h4 id="总结"><a href="#总结" class="headerlink" title="总结"></a>总结</h4><p>这里详细给一下内存堆与内存池的对比：</p><table><thead><tr><th align="left">维度</th><th align="left">内存池（Pool）</th><th align="left">内存堆（Heap）</th></tr></thead><tbody><tr><td align="left"><strong>块大小</strong></td><td align="left">固定</td><td align="left">可变</td></tr><tr><td align="left"><strong>分配</strong></td><td align="left">O(1) 取链表头</td><td align="left">O(n) 搜索 + 分裂</td></tr><tr><td align="left"><strong>释放</strong></td><td align="left">O(1) 插回链表</td><td align="left">O(1) 插回 + 合并</td></tr><tr><td align="left"><strong>碎片</strong></td><td align="left">无</td><td align="left"><strong>有，必须管理</strong></td></tr><tr><td align="left"><strong>块头开销</strong></td><td align="left">1 个指针</td><td align="left">大小 + 标志 + 链表指针（8~16 字节）</td></tr><tr><td align="left"><strong>适用</strong></td><td align="left">RTOS 栈、消息队列、固定结构</td><td align="left">不定长字符串、动态数组、协议解析</td></tr></tbody></table><p>内存堆与内存池在LwIP中的运用是十分广泛的，想要更加深入了解的话可以具体去看一看其内存管理模块的源码实现。</p><p>文章上述的参考示例均是在裸机环境下定义的，如果要引入OS，需要考虑线程保护。</p>]]>
    </content>
    <id>https://r6blog.online/2026/09/12/%E5%B5%8C%E5%85%A5%E5%BC%8F2026091201/</id>
    <link href="https://r6blog.online/2026/09/12/%E5%B5%8C%E5%85%A5%E5%BC%8F2026091201/"/>
    <published>2026-09-12T07:02:48.000Z</published>
    <summary>
      <![CDATA[<h4 id="引言"><a href="#引言" class="headerlink" title="引言"></a>引言</h4><p>日常开发中，内存的管理自然是不可或缺的一环。例如 Ethernet 中要发送数据包要开辟发送缓冲区，接收数据包时要开辟接收缓冲区，并且使用完]]>
    </summary>
    <title>嵌入式内存管理： 内存堆</title>
    <updated>2026-10-08T07:15:10.243Z</updated>
  </entry>
  <entry>
    <author>
      <name>R6bandito</name>
    </author>
    <category term="语言" scheme="https://r6blog.online/categories/%E8%AF%AD%E8%A8%80/"/>
    <category term="C/C++" scheme="https://r6blog.online/tags/C-C/"/>
    <content>
      <![CDATA[<p>最近在写一个简易的内存管理逻辑用于 CCM_RAM 以及其余通用 RAM 管理。过程中涉及到了内存池的配置：如果需要添加一个新类型的内存池，常规做法是在相关 .c&#x2F;.h 中再定义一个数组以及维护一套描述头结构。但是这涉及到多个文件的修改，如果漏改一个地方那么将导致程序编译不过。而且如果后续逻辑写大之后，维护将及其不便。此时便想起了可以使用 <code>X-Macro</code> 来解决这个问题。</p><h4 id="什么是-X-Macro-？"><a href="#什么是-X-Macro-？" class="headerlink" title="什么是 X-Macro ？"></a>什么是 X-Macro ？</h4><p>X-Macro 是一种用<strong>宏来定义数据列表，然后反复重定义 <code>X</code> 来生成不同代码</strong>的预处理器技巧。是一种可靠维护代码或数据的并行列表的技术，你只需要维护一份数据列表，编译器自动帮你生成枚举、数组、函数声明、结构体、初始化代码等所有重复性内容。</p><p>X-Macro 并不是C语言的新特性，它本质其实就是普通的宏定义与展开，在这个基础之上才衍生出了 X-Macro，因此 X-Macro 准确来说应该是一个宏的使用技巧。</p><h4 id="使用方法"><a href="#使用方法" class="headerlink" title="使用方法"></a>使用方法</h4><p>单看概念会觉得十分抽象，这里我们给出一个简单的示例：</p><figure class="highlight c"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br></pre></td><td class="code"><pre><code class="hljs c"><span class="hljs-meta">#<span class="hljs-keyword">define</span> MY_DATA_LIST \</span><br><span class="hljs-meta">    X(ITEM_A, 100, <span class="hljs-string">&quot;hello&quot;</span>) \</span><br><span class="hljs-meta">    X(ITEM_B, 200, <span class="hljs-string">&quot;world&quot;</span>) \</span><br><span class="hljs-meta">    X(ITEM_C, 300, <span class="hljs-string">&quot;foo&quot;</span>)</span><br></code></pre></td></tr></table></figure><p>上面我们定义了一个数据表，现在我们想要利用这个数据表，一次性定义3个变量，并使用表中的数值参数对其进行初始化，该怎么做？ 这里可以使用 X-Macro 来完成：</p><figure class="highlight c"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br></pre></td><td class="code"><pre><code class="hljs c"><span class="hljs-meta">#<span class="hljs-keyword">define</span> X(name, val, str) int name##_value = val;</span><br>MY_DATA_LIST<br><span class="hljs-meta">#<span class="hljs-keyword">undef</span> X</span><br></code></pre></td></tr></table></figure><p>上面逻辑中，我们定义了 <code>X(参数)</code> 为我们想做的操作（变量定义）：<code>int 参数1##_value = 参数2;</code></p><p>在预处理阶段，<code>MY_DATA_LIST</code> 展开后得到下列程序：</p><figure class="highlight c"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br></pre></td><td class="code"><pre><code class="hljs c"><span class="hljs-type">int</span> ITEM_A_value = <span class="hljs-number">100</span>;<br><span class="hljs-type">int</span> ITEM_B_value = <span class="hljs-number">200</span>;<br><span class="hljs-type">int</span> ITEM_C_value = <span class="hljs-number">300</span>;<br></code></pre></td></tr></table></figure><p>发现没有？我们仅仅通过一次展开 <code>MY_DATA_LIST</code> 宏就得到了所有的变量定义，如果此刻我们想要加入第四个变量该怎么做？很简单，只需要在 <code>MY_DATA_LIST</code> 中多引入一个表项就行。</p><figure class="highlight c"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br></pre></td><td class="code"><pre><code class="hljs c"><span class="hljs-meta">#<span class="hljs-keyword">define</span> MY_DATA_LIST \</span><br><span class="hljs-meta">    X(ITEM_A, 100, <span class="hljs-string">&quot;hello&quot;</span>) \</span><br><span class="hljs-meta">    X(ITEM_B, 200, <span class="hljs-string">&quot;world&quot;</span>) \</span><br><span class="hljs-meta">    X(ITEM_C, 300, <span class="hljs-string">&quot;foo&quot;</span>) \</span><br><span class="hljs-meta">    X(ITEM_D, 400, <span class="hljs-string">&quot;happy&quot;</span>)</span><br>    <br><span class="hljs-comment">// 展开后：</span><br><span class="hljs-type">int</span> ITEM_A_value = <span class="hljs-number">100</span>;<br><span class="hljs-type">int</span> ITEM_B_value = <span class="hljs-number">200</span>;<br><span class="hljs-type">int</span> ITEM_C_value = <span class="hljs-number">300</span>;<br><span class="hljs-type">int</span> ITEM_D_value = <span class="hljs-number">400</span>;<br></code></pre></td></tr></table></figure><p>我们通过一个简单的变量定义场景就阐述出了 X-Macro 宏的用法。相信你此刻已经见识到了这玩意儿的强大之处：没错，我们只需在 <code>conf.h</code> 中维护一个全局表项，后续的 数组声明&#x2F;枚举定义 等等均采用 X-Macro 进行展开。如果后期需要对表项做出修改，只需要改 <code>conf.h</code> 文件就行，其余模块内部自适应变化！极大降低了维护工作量，且不易出错。</p><hr><p>这里我就不以更多的示例来进行阐述，直接来看一个实际的应用场景：</p><p>目前需要设计一个内存池，且该内存池类型不固定（也就是说需要支持不同类型的内存池），且用户侧对于内存池的类型删减必须足够简便。很明显，这就是一个典型的 X-Macro 的用武之地了，一起来看。</p><p>我们先以一个默认的类型来入手，默认池采用每块512字节，供划分12块的配置。</p><figure class="highlight c"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br></pre></td><td class="code"><pre><code class="hljs c"><span class="hljs-comment">/* This is default setting. */</span><br><span class="hljs-meta">#<span class="hljs-keyword">define</span> DEFAULT_BLOCK_SIZE  (512ul)</span><br><span class="hljs-meta">#<span class="hljs-keyword">define</span> DEFAULT_BLOCK_NUM   (12u)</span><br><br><span class="hljs-meta">#<span class="hljs-keyword">define</span> MEM_POOL_LIST   \</span><br><span class="hljs-meta">X(DEFAULT, DEFAULT_BLOCK_SIZE, DEFAULT_BLOCK_NUM)</span><br></code></pre></td></tr></table></figure><p><code>X(DEFAULT, DEFAULT_BLOCK_SIZE, DEFAULT_BLOCK_NUM)</code></p><p>这就是我们的数据列表了，后续用户所有对于内存池配置的操作都在此进行。</p><p>列表定义好之后首先我们需要的就是再定义一个枚举，该枚举是后续我们访问不同类型内存池的关键（也可以理解为池索引），接下来我们使用 X-Macro 进行第一次展开！</p><figure class="highlight c"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br></pre></td><td class="code"><pre><code class="hljs c"><span class="hljs-comment">// 第一次 X-Macro 展开.</span><br><span class="hljs-meta">#<span class="hljs-keyword">define</span> X(name, size, depth)  POOL_##name,</span><br><span class="hljs-keyword">typedef</span> <span class="hljs-class"><span class="hljs-keyword">enum</span> &#123;</span><br>MEM_POOL_LIST<br>POOL_MAX<br>&#125; <span class="hljs-type">pool_id_t</span>;<br><span class="hljs-meta">#<span class="hljs-keyword">undef</span> X</span><br></code></pre></td></tr></table></figure><p>展开后如下：</p><figure class="highlight c"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br></pre></td><td class="code"><pre><code class="hljs c"><span class="hljs-keyword">typedef</span> <span class="hljs-class"><span class="hljs-keyword">enum</span> &#123;</span><br>POOL_DEFAULT,<br>POOL_MAX<br>&#125; <span class="hljs-type">pool_id_t</span>;<br></code></pre></td></tr></table></figure><p>Ps:这里有个小细节要注意一下：<strong>POOL_MAX 是根据枚举型的递增特性，用来统计池类型数目的，后续用于循环计数</strong>。</p><p>现在索引有了，我们需要再定义物理数组，也就是这片内存池真正的空间来源。这是我们第二次 X-Macro 展开，注意看。</p><figure class="highlight c"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br></pre></td><td class="code"><pre><code class="hljs c"><span class="hljs-comment">// 第二次 X-Macro 展开.</span><br><span class="hljs-meta">#<span class="hljs-keyword">define</span> X(name, size, depth) \</span><br><span class="hljs-meta">static uint8_t __attribute__((section(POOL_SECTION))) __attribute__((aligned(4))) \</span><br><span class="hljs-meta">pool_##name##_heap[(size + sizeof(void *)) * (depth)];</span><br>MEM_POOL_LIST<br><span class="hljs-meta">#<span class="hljs-keyword">undef</span> X</span><br></code></pre></td></tr></table></figure><p>展开后，得到：</p><figure class="highlight c"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br></pre></td><td class="code"><pre><code class="hljs c"><span class="hljs-comment">/* 这里 sizeof(void *)在32位下是4字节.一个小细节 */</span><br><span class="hljs-type">static</span> <span class="hljs-type">uint8_t</span> pool_DEFAULT_heap[((<span class="hljs-number">512ul</span>) + <span class="hljs-number">4</span>) * (<span class="hljs-number">12u</span>)];<br></code></pre></td></tr></table></figure><p>继续，要管理不同类型的池子，需要对应的描述头结构。这里我们描述头定义为：<code>pool_desc_t</code>，具体结构就不详细给出了。每个池子类型都要对应自己的描述头，因此描述头结构应该是一个对应结构数组中的表项。</p><p>这里我们第三次使用 X-Macro 展开：</p><figure class="highlight c"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br></pre></td><td class="code"><pre><code class="hljs c"><span class="hljs-comment">// 第三次 X-Macro 展开.</span><br><span class="hljs-type">static</span> <span class="hljs-type">pool_desc_t</span> pool_table[POOL_MAX] = <br>&#123;<br><span class="hljs-meta">#<span class="hljs-keyword">define</span> X(name, size, depth)&#123; (size) + sizeof(void*), depth, NULL &#125;,</span><br>MEM_POOL_LIST<br><span class="hljs-meta">#<span class="hljs-keyword">undef</span> X</span><br>&#125;;<br></code></pre></td></tr></table></figure><p>展开后得到：</p><figure class="highlight c"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br></pre></td><td class="code"><pre><code class="hljs c"><span class="hljs-type">static</span> <span class="hljs-type">pool_desc_t</span> pool_table[POOL_MAX] = <br>&#123;<br>&#123; (<span class="hljs-number">512ul</span>) + <span class="hljs-number">4</span>, (<span class="hljs-number">12u</span>), <span class="hljs-literal">NULL</span> &#125;,<br>&#125;;<br></code></pre></td></tr></table></figure><p>至此，三次展开已经全部结束。 我们来总览一下 X-Macro 给我们带来了什么。</p><figure class="highlight c"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br></pre></td><td class="code"><pre><code class="hljs c"><span class="hljs-keyword">typedef</span> <span class="hljs-class"><span class="hljs-keyword">enum</span> &#123;</span><br>    POOL_DEFAULT,<br>    POOL_MAX<br>&#125; <span class="hljs-type">pool_id_t</span>;<br><br><span class="hljs-type">static</span> <span class="hljs-type">uint8_t</span> pool_DEFAULT_heap[((<span class="hljs-number">512ul</span>) + <span class="hljs-number">4</span>) * (<span class="hljs-number">12u</span>)];<br><span class="hljs-type">static</span> <span class="hljs-type">pool_desc_t</span> pool_table[POOL_MAX] = <br>&#123;<br>&#123; (<span class="hljs-number">512ul</span>) + <span class="hljs-number">4</span>, (<span class="hljs-number">12u</span>), <span class="hljs-literal">NULL</span> &#125;,<br>&#125;;<br></code></pre></td></tr></table></figure><p>看到了吧，一行数据列表给我们从结构声明到数据结构定义全部搞定。这就是 X-Macro 最大的意义：</p><p><strong>零运行时开销，所有枚举、数组大小、地址排布在编译期就定了。且用户只需改一行列表，所有相关代码自动同步，不需要挨个模块去加实现。</strong></p><p>假如我们目前需要加入 TEST 类型池子， 大小1024，深度15，怎么做呢？很简单，多加一个列表的事。</p><figure class="highlight c"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br></pre></td><td class="code"><pre><code class="hljs c"><span class="hljs-meta">#<span class="hljs-keyword">define</span> MEM_POOL_LIST   \</span><br><span class="hljs-meta">X(DEFAULT, DEFAULT_BLOCK_SIZE, DEFAULT_BLOCK_NUM) \</span><br><span class="hljs-meta">X(TEST, (1024ul), (15u))</span><br></code></pre></td></tr></table></figure><p>X-Macro 将自动生成：</p><figure class="highlight c"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br></pre></td><td class="code"><pre><code class="hljs c"><span class="hljs-keyword">typedef</span> <span class="hljs-class"><span class="hljs-keyword">enum</span> &#123;</span><br>    POOL_DEFAULT,<br>    POOL_TEST,<br>    POOL_MAX<br>&#125; <span class="hljs-type">pool_id_t</span>;<br><br><span class="hljs-type">static</span> <span class="hljs-type">uint8_t</span> pool_DEFAULT_heap[((<span class="hljs-number">512ul</span>) + <span class="hljs-number">4</span>) * (<span class="hljs-number">12u</span>)];<br><span class="hljs-type">static</span> <span class="hljs-type">uint8_t</span> pool_TEST_heap[((<span class="hljs-number">1024ul</span>) + <span class="hljs-number">4</span>) * (<span class="hljs-number">15u</span>)];<br><br><span class="hljs-type">static</span> <span class="hljs-type">pool_desc_t</span> pool_table[POOL_MAX] = <br>&#123;<br>&#123; (<span class="hljs-number">512ul</span>) + <span class="hljs-number">4</span>, (<span class="hljs-number">12u</span>), <span class="hljs-literal">NULL</span> &#125;,<br>&#123; (<span class="hljs-number">1024ul</span>) + <span class="hljs-number">4</span>, (<span class="hljs-number">15u</span>), <span class="hljs-literal">NULL</span> &#125;,<br>&#125;;<br></code></pre></td></tr></table></figure><p>无需多言了，这就是 X-Macro 的魅力所在。</p><hr><h4 id="一些使用场景"><a href="#一些使用场景" class="headerlink" title="一些使用场景"></a>一些使用场景</h4><p>我最早接触到 X-Macro 是在 LwIP 的内存管理算法源码中了解到的。LwIP 在内存池逻辑中就使用了 X-Macro 进行不同池类型的管理，其原理与我上述所说的本质是一样的：通过不断展开 X-Macro 来声明与定义数据结构，后续内存池类型的增删（比如 UDP&#x2F;TCP 等等类型控制块其内存来源都是内存池）直接通过数据列表进行配置，无需改动内部逻辑。</p><p>这里我给一些 LwIP 源码中的具体实现，作为参考学习：</p><figure class="highlight c"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br><span class="line">19</span><br><span class="line">20</span><br><span class="line">21</span><br><span class="line">22</span><br><span class="line">23</span><br><span class="line">24</span><br><span class="line">25</span><br><span class="line">26</span><br><span class="line">27</span><br><span class="line">28</span><br><span class="line">29</span><br></pre></td><td class="code"><pre><code class="hljs c">LWIP_MEMPOOL(RAW_PCB,        <span class="hljs-number">1</span>,   <span class="hljs-number">100</span>, <span class="hljs-string">&quot;RAW_PCB&quot;</span>)<br>LWIP_MEMPOOL(TCP_PCB,        <span class="hljs-number">5</span>,   <span class="hljs-number">200</span>, <span class="hljs-string">&quot;TCP_PCB&quot;</span>)<br>LWIP_MEMPOOL(TCP_SEG,       <span class="hljs-number">10</span>,   <span class="hljs-number">50</span>,  <span class="hljs-string">&quot;TCP_SEG&quot;</span>)<br><span class="hljs-comment">// ... 后面还有很多</span><br>    <br><span class="hljs-meta">#<span class="hljs-keyword">define</span> LWIP_MEMPOOL(name,num,size,desc)  MEMP_##name,</span><br>    <br><span class="hljs-comment">// 展开后.</span><br><span class="hljs-keyword">typedef</span> <span class="hljs-class"><span class="hljs-keyword">enum</span> &#123;</span><br>    MEMP_RAW_PCB,<br>    MEMP_TCP_PCB,<br>    MEMP_TCP_SEG,<br>    <span class="hljs-comment">// ... 继续展开所有池</span><br>    MEMP_MAX<br>&#125; <span class="hljs-type">memp_t</span>;<br><br><span class="hljs-comment">/* **************************************************** */</span> <br><span class="hljs-type">const</span> <span class="hljs-class"><span class="hljs-keyword">struct</span> <span class="hljs-title">memp_desc</span> *<span class="hljs-title">const</span> <span class="hljs-title">memp_pools</span>[<span class="hljs-title">MEMP_MAX</span>] =</span> &#123;<br><span class="hljs-meta">#<span class="hljs-keyword">define</span> LWIP_MEMPOOL(name,num,size,desc) &amp;memp_ ## name,</span><br><span class="hljs-meta">#<span class="hljs-keyword">include</span> <span class="hljs-string">&quot;lwip/priv/memp_std.h&quot;</span></span><br>&#125;;<br><br><span class="hljs-comment">// 展开后.</span><br><span class="hljs-type">const</span> <span class="hljs-class"><span class="hljs-keyword">struct</span> <span class="hljs-title">memp_desc</span> *<span class="hljs-title">const</span> <span class="hljs-title">memp_pools</span>[] =</span> &#123;<br>    &amp;memp_RAW_PCB,<br>    &amp;memp_TCP_PCB,<br>    &amp;memp_TCP_SEG,<br>    <span class="hljs-comment">// ... </span><br>&#125;;<br></code></pre></td></tr></table></figure><hr><p>X-Macro 的适用场景其实很明确：<strong>同一份数据，需要在多个地方以不同形式出现</strong>——枚举、数组、字符串表、初始化代码。一旦用上，原来需要手工同步的重复代码全部可以删掉。</p><p>其技巧本身并不难，难在能不能够在具体业务场景中识别并运用。</p>]]>
    </content>
    <id>https://r6blog.online/2026/09/11/%E5%B5%8C%E5%85%A5%E5%BC%8F2026091101/</id>
    <link href="https://r6blog.online/2026/09/11/%E5%B5%8C%E5%85%A5%E5%BC%8F2026091101/"/>
    <published>2026-09-11T08:10:14.000Z</published>
    <summary>
      <![CDATA[<p>最近在写一个简易的内存管理逻辑用于 CCM_RAM 以及其余通用 RAM 管理。过程中涉及到了内存池的配置：如果需要添加一个新类型的内存池，常规做法是在相关 .c&#x2F;.h 中再定义一个数组以及维护一套描述头结构。但是这涉及到多个文件的修改，如果漏改一个地方那么将导致]]>
    </summary>
    <title>C黑魔法 X-Macro 宏</title>
    <updated>2026-10-08T07:15:10.243Z</updated>
  </entry>
  <entry>
    <author>
      <name>R6bandito</name>
    </author>
    <category term="嵌入式" scheme="https://r6blog.online/categories/%E5%B5%8C%E5%85%A5%E5%BC%8F/"/>
    <category term="CAN" scheme="https://r6blog.online/categories/%E5%B5%8C%E5%85%A5%E5%BC%8F/CAN/"/>
    <category term="CAN" scheme="https://r6blog.online/tags/CAN/"/>
    <content>
      <![CDATA[<p>在上篇中（<a href="/2026/08/30/%E5%B5%8C%E5%85%A5%E5%BC%8F202608302/" title="ISO-TP 通信流程(上)">ISO-TP 通信流程(上)</a>）我们详细介绍了 iso-tp 中的基础通信数据元（PDU）以及寻址模式，这些内容指导了我们 CAN 报文的组装方式。在下篇中，我们将在前述的基础上，详细讲讲 iso-tp 的状态机流转过程，帧是怎么发送的，时序上有哪些要求。</p><p>这里先给两个总状态机流转图：</p><p>(一) <strong>iso-tp 接收流程状态机(源自 ISO 15765-2:2016)</strong></p><img src="/2026/09/09/嵌入式2026090901/2026090901_1.webp" style="zoom:80%;" /><p><strong>(二) iso-tp 发送流程状态机</strong></p><p><img src="/2026/09/09/嵌入式2026090901/2026090901_8.webp"></p><p>后续我们将以该两图为基础，详细拆解其各个状态。</p><hr><h3 id="发送状态机"><a href="#发送状态机" class="headerlink" title="发送状态机"></a>发送状态机</h3><h4 id="单帧传输"><a href="#单帧传输" class="headerlink" title="单帧传输"></a>单帧传输</h4><p>iso-tp 是具备单帧路由机制的。当待发数据量 &lt;&#x3D; 7字节(普通寻址模式&#x2F;Classic CAN为例) &#x2F; &lt;&#x3D; 6字节(拓展寻址&#x2F;Classic CAN 为例)时，我们一个报文就可以将所有的数据全部打包带走，没有必要启动多帧传输。协议栈内部在满足上述条件后，会直接走单帧发送路径。以下是 SF 单帧传输的状态流程：</p><img src="/2026/09/09/嵌入式2026090901/2026090901_2.webp" style="zoom:80%;" /><p>协议栈内部判定该包数据长度能够在该寻址模式下，通过一个 CAN 报文全部打包带走时，便会将待发送数据路由给单帧发送机制。单帧发送机制会构建 SF 类型的报文，向总线发出，并且在提交发送请求后会立即开启硬件定时计时器 N_As。此时连接控制块状态为 <code>TX_SF</code> 。</p><p>当 CAN 控制器成功发送出该帧报文时，将关闭定时器，并且复位状态为 <code>IDLE</code> 空闲状态。以此就完成了一次 SF 单帧的通信。当硬件因为某些原因没有发送出报文进而导致定时器超时后，协议栈应该通知上层，向上层上报错误，由上层来决定是否重启通信。</p><hr><h4 id="多帧传输"><a href="#多帧传输" class="headerlink" title="多帧传输"></a>多帧传输</h4><p>iso-tp 中，可靠的多帧重组传输机制才是协议的一大亮点。多帧传输是由 FF + CF + FC 共同构成的一个稳定的传输状态机，以下是多帧传输下的状态机流转图：</p><img src="/2026/09/09/嵌入式2026090901/2026090901_3.webp" style="zoom:80%;" /><p><strong>当协议栈发现要传输的数据量大于单帧所能承载的容量时，此时便会触发多帧传输</strong>。</p><p>其具体流程为：</p><ul><li><strong>构建 FF 帧，用于启动一次多帧传输</strong>。</li></ul><p>将 PCI + FF_DL + 首段数据(此处示例为 &lt;&#x3D; 4095 的情况，若 &gt; 4095 且为 Classic CAN，因长度字段占据大量空间，FF 通常不携带有效数据，所有数据均从后续 CF 开始发送。) 打包进CAN报文中，并正确填充 TA&#x2F;SA&#x2F;TAType 等信息，提交硬件发送，并启动 N_Bs（流控超时计时器）与 N_As（硬件计时器）。此时状态由 <code>IDLE</code> 转为 <code>TX_FF</code>，当硬件发送确认后，N_As被关闭，状态转为 <code>TX_WAIT_FC</code>，等待接收方发回流控FC。<br>此时 N_Bs 计时器依然运行，用于监控接收方发回流控这一操作是否超时。</p><ul><li><strong>收到接收方发回的 FC ，更新本次传输流控参数，停止 N_Bs 定时器。</strong></li></ul><p>收到 FC 之后，若收到的是 WAIT 流控，发送方不应停止 N_Bs，而是重启该定时器继续等待下一个 FC。其它情况下协议栈应该停掉并重置 N_Bs 计时器，同时将收到的 FC 中的流控参数(STmin&#x2F;BS)以及流控状态提取出来。若对端返回 OVFLW 状态，表示缓冲区不足，应当终止本次传输。<br>在后续通信中，发送方将严格遵循 FC 中的 STmin（两个CF之间最小帧间隔）与 BS（块大小）的约束进行 CF 的发送。</p><p>这里有些细节要强调一下：</p><ol><li>STmin&#x2F;BS 是允许均为0的，代表全速发送，要注意接收方处理速度能否跟上。</li><li>关于 FC 流控机制，标准里面给出了两种解释，详见下图：<img src="/2026/09/09/嵌入式2026090901/2026090901_4.webp" style="zoom:80%;" /></li></ol><p>iso-tp 允许接收方在同一个多帧传输过程中动态调整流控参数。也就是说，流控机制分为了静态流控与动态流控，不同的工程背景可以选用不同的流控机制。</p><p><strong>动态流控</strong>：接收方在<strong>同一个多帧传输</strong>的不同流控帧（FC）中，可以改变 <code>BS</code> 和 <code>STmin</code> 的值（比如第一次 FC 告诉你 BS&#x3D;5，下一次告诉你 BS&#x3D;3）。也就是说，iso-tp 允许服务器根据负载动态掌控流控，如果服务器是分段消息的接收方，那么可以自由选择保持 BS&#x2F;STmin 不变，或者在同一个多帧传输中改变这些值。</p><p>例如服务器 CPU 负载变高时，可以将流控缩小甚至关闭（发送Wait流控），以免缓冲区溢出。当空闲时再打开流控接收分段数据。</p><p><strong>静态流控</strong>：在<strong>同一次多帧传输</strong>的所有 FC 帧中，BS 和 STmin 要保持不变。也就是说该次通信的流控取决于第一次发送给对方的流控，后续均基于这个流控参数的基础上进行通信。</p><p>这个流程中，<strong>流控主导权在接收方</strong>，发送方被迫适应。</p><p>在我的轻量化实现中，对于这个部分我是统一采用静态流控的。因为常规 MCU 之间的通信大部分情境下都不会使用到该功能，为此在发送方引入一个解析功能没必要。</p><ul><li><strong>根据流控参数发送连续帧 CF。</strong></li></ul><p>从发送缓冲区中取出下一段待发数据，打包成 CF 帧向总线发出，并启动N_As等待控制器成功发到总线上后响应。在整个 CF 发送期间状态机都应该保持 <code>TX_CF</code> 状态。</p><p>同时，SN 序列码要递增，这是协议栈判断是否帧错位的重要依据。上一篇文章我们已经阐述了 SN 序列码的作用，此处仅简单提一下要点即可：<strong>一定要注意 SN 码是模16循环</strong>！因为 SN 的占位只有4位大小，如果忘记循环那么通讯将在第一次 SN 码触发临界时断裂，尤其要注意！</p><p>由于流控的作用，每帧 CF 之间需要间隔 STmin。且如果当前BS块发完（仅在 BS &gt; 0 条件下）的话，需要回到 <code>TX_WAIT_FC</code> 状态，等待接收方通过流控 CTS 下发下一次的发送许可。</p><p>CF 发送的整体流程如下图所示：</p><img src="/2026/09/09/嵌入式2026090901/2026090901_5.webp" style="zoom:80%;" /><p>图片内容展示了多帧传输 + 流控场景下的数据收发示意图。重点理解 BS与STmin的概念。</p><ul><li><strong>数据发送完毕，传输结束</strong></li></ul><p>当最后一包 CF 发出后，协议栈内部判断读指针已经来到待发数据末尾，说明当前整个缓冲区数据已被发出。此时发送方将状态从 <code>TX_CF</code> 切换为 <code>IDLE</code> 空闲状态，通知上层传输完成（可通过回调等形式）并清扫连接内部的相关字段，为下一次通信做准备。</p><p>值得注意的是，iso-tp 与 IP 协议类似，只尽最大努力路由数据，至于对端是否接收到是不会管的。没有应用层的 ACK 确认机制（对端是否完全正确接收与组装不会发一帧报文来通知你）。</p><hr><h3 id="接收状态机"><a href="#接收状态机" class="headerlink" title="接收状态机"></a>接收状态机</h3><h4 id="单帧接收"><a href="#单帧接收" class="headerlink" title="单帧接收"></a>单帧接收</h4><p>当协议栈接收到一帧 iso-tp 报文后，会取出 PCI 信息字节的高四位：<strong>帧类型识别码</strong>。若识别码为 0（即下图中 N_PCItype &#x3D; 0），则表示该帧为 SF 单帧，走单帧处理流程。</p><img src="/2026/09/09/嵌入式2026090901/2026090901_6.webp" style="zoom:80%;" /><ul><li><strong>检查接收的CAN报文数据段是否 &lt;&#x3D; 8字节.(Classic CAN)</strong></li></ul><p>若数据长度 ≤ 8：可能是 Classic CAN，也可能是短 CAN FD，但两者 SF 格式一致，直接按 SF_DL 解析即可。此时若 SF_DL &#x3D; 0，属于非法格式，按错误帧处理。</p><ul><li><strong>若数据段 &gt; 8字节，检查是否为 CANFD 的有效 SF 报文.</strong></li></ul><p>数据长度 &gt; 8 时，必然是 CAN FD，且数据长度已超过短格式范围，因此必须使用扩展 SF_DL 格式：第一字节低 4 位（原 <code>SF_DL</code>）为 0，真正的长度在第二字节。</p><p>对于原4位 <code>SF_DL</code> 不为0的情况，当作错误帧进行处理（忽略）。</p><hr><h4 id="多帧接收"><a href="#多帧接收" class="headerlink" title="多帧接收"></a>多帧接收</h4><p>当协议栈收到帧类型识别码为 1 的报文时，表示接收到了一帧 FF 首帧。收到 FF 即表示一次多帧通信即将开始，接下来就是完整的多帧通信状态机。</p><img src="/2026/09/09/嵌入式2026090901/2026090901_7.webp" style="zoom:80%;" /><ul><li><strong>收到 FF 后，提取 FF_DL，回复流控。</strong></li></ul><p>收到一帧 FF 后，状态变为 <code>RX_FF</code> 。协议栈应提取出该报文中的 <code>FF_DL</code>，检查自身缓冲区是否足以容纳本次通信数据量（流式传输除外），以明确本次通信所要传输的数据量大小；提取出可能存在的由 FF 帧带来的部分数据；同时也要提取出发送方 SA 地址，便于后续回复流控。</p><p>所有数据提取后，根据自身设置，构建 FC 流控帧发往对端，同时启动 N_Cr(监控发送方是否按时发来下一个 CF) 与 N_Ar 计时器(监控 FC 是否被硬件成功发出)。FC流控成功被硬件确认后，此时状态变为 <code>RX_CF</code> ，准备接收接下来的 CF 数据包。</p><ul><li><strong>CF 数据包接收。</strong></li></ul><p>这里接收部分需要涉及到 <strong>SN 连续性检查</strong>，首帧隐含 <code>SN = 0</code>，因此收到的第一个 CF 期望 <code>SN = 1</code>。</p><p>若 <code>SN</code> 与期望值匹配 ，数据存入缓冲区，期望 SN 递增（模16循环）。</p><p>若 <code>SN</code> 不匹配（期望2却收到3） <strong>丢弃该帧，保持当前状态，等待 N_Cr 超时后回到 Idle 状态并等待下一次 FF</strong>。标准规定此时接收方不主动发送错误码，沉默等待即可。</p><p>每收到一个 SN 匹配的 CF 都要重置 N_Cr 定时器。</p><ul><li><strong>流控参数：BS</strong>。</li></ul><p>若 BS !&#x3D; 0，则作为接收方，当BS阈值到达时，状态转换为 <code>TX_FC</code> 需要向对端发送一个 FC 报文。这里如同上文所述：分为<strong>静态流控</strong>与<strong>动态流控</strong>。具体怎么使用取决于你的工程实现。</p><ul><li><strong>接收完成。</strong></li></ul><p>当累积的接收数据 &#x3D;&#x3D; <code>FF_DL</code> 时，此时可认为已经收到完整的数据。协议栈应停掉 N_Cr 定时器，</p><p>状态回到 <code>IDLE</code> 空闲，并将完整的数据交付给上层（通过回调或消息队列）。最后打扫控制块中的对应字段，为下一次通信做准备。</p><p>整个流程中，对于 N_Cr 超时，接收方应丢弃已重组数据，状态回到 <code>IDLE</code>，并通知接收方上层。接收方不主动请求重传；是否重新发起多帧传输由发送方决定。</p><p>发送状态机与接收状态机其实是对称的：发送方在 <code>TX_WAIT_FC</code> 等流控，接收方在 <code>RX_CF</code> 等连续帧；发送方关心 <code>N_Bs</code>（等 FC），接收方关心 <code>N_Cr</code>（等 CF）。两者通过 FC 帧中的 <code>BS</code> 和 <code>STmin</code> 完成节奏协商，共同保证多帧数据在 CAN 总线上的可靠重组。</p><hr><h3 id="ISO-TP-定时器汇总"><a href="#ISO-TP-定时器汇总" class="headerlink" title="ISO-TP 定时器汇总"></a>ISO-TP 定时器汇总</h3><p>前面多次提到了定时器，这里给出 iso-tp 中的一些相关定时器以及分工表：</p><table><thead><tr><th align="left">定时器</th><th align="left">生效方</th><th align="left">全称</th><th align="left">启动时机</th><th align="left">停止时机</th><th align="left">超时后果</th></tr></thead><tbody><tr><td align="left"><strong><code>N_As</code></strong></td><td align="left"><strong>发送方</strong></td><td align="left">发送方硬件确认超时</td><td align="left">每提交一帧（SF&#x2F;FF&#x2F;CF）给 CAN 控制器后</td><td align="left">收到 CAN 硬件发送完成中断（ACK）</td><td align="left">发送方传输中止，向上层报错</td></tr><tr><td align="left"><strong><code>N_Ar</code></strong></td><td align="left"><strong>接收方</strong></td><td align="left">接收方硬件确认超时</td><td align="left">每提交一帧（FC）给 CAN 控制器后</td><td align="left">收到 CAN 硬件发送完成中断（ACK）</td><td align="left">接收方终止接收，向上层报错</td></tr><tr><td align="left"><strong><code>N_Bs</code></strong></td><td align="left"><strong>发送方</strong></td><td align="left">流控等待超时</td><td align="left">发出 FF 后；每发完一个 BS 块后</td><td align="left">收到 CTS&#x2F;OVFLW 时停止；收到 WAIT 时重启继续等待。</td><td align="left">终止多帧传输，向上层报错，状态回 <code>IDLE</code></td></tr><tr><td align="left"><strong><code>N_Cr</code></strong></td><td align="left"><strong>接收方</strong></td><td align="left">连续帧等待超时</td><td align="left">发出 FC 后（等待第一个 CF）；每收到一个有效 CF 后重置</td><td align="left">收到满足 <code>FF_DL</code> 的最后一个 CF</td><td align="left">丢弃已重组数据，状态回 <code>IDLE</code>，等待下一次 FF</td></tr></tbody></table><ul><li><strong>N_Ar &#x2F; N_As</strong></li></ul><p>两个都是<strong>记录底层硬件发送行为</strong>的计时器。区别在于 N_Ar 是接收方等硬件，N_As 是发送方等硬件。</p><p>比如对于 N_As ：“我发了，但是这帧有没有从总线上真正发出去？”不得而知，只有等硬件确认。</p><p>对于 N_Ar：“我回了 FC，但是有没有真正发出去？” 等硬件确认。</p><p>在我的实现中，这两个定时器我统一合并为了一个 N_As，并在 CAN 发送完成中断中进行状态推动。</p><ul><li><strong>N_Cr &#x2F; N_Bs</strong></li></ul><p>这两个是<strong>记录软件层行为</strong>的计时器。</p><p>对于 N_Cr ：这是接收方等待 CF 的定时器——“对方软件到底什么时候给我发下一个 CF？”</p><p>对于 N_Bs：这是发送方等待接收方发来的 FC 的定时器——“对方软件到底什么时候回我 FC？”</p><p>这些定时器交织起来共同组成了一个超时网络，确保协议栈在通信的每一步都不会卡死，能够超时回退。</p><hr><p>至此，iso-tp 的核心流程已经完结，从4个PDU到寻址模式，再到协议栈定时器与运行状态机。后续若有关于 iso-tp 的其它内容，将作为拓展单独篇幅叙述。</p>]]>
    </content>
    <id>https://r6blog.online/2026/09/09/%E5%B5%8C%E5%85%A5%E5%BC%8F2026090901/</id>
    <link href="https://r6blog.online/2026/09/09/%E5%B5%8C%E5%85%A5%E5%BC%8F2026090901/"/>
    <published>2026-09-09T00:41:37.000Z</published>
    <summary>
      <![CDATA[<p>在上篇中（<a href="/2026/08/30/%E5%B5%8C%E5%85%A5%E5%BC%8F202608302/" title="ISO-TP 通信流程(上)">ISO-TP 通信流程(上)</a>）我们详细介绍了 iso-tp 中的基础通信数据元（PDU）以]]>
    </summary>
    <title>ISO-TP 通信流程(下)</title>
    <updated>2026-10-08T07:15:10.243Z</updated>
  </entry>
  <entry>
    <author>
      <name>R6bandito</name>
    </author>
    <category term="嵌入式" scheme="https://r6blog.online/categories/%E5%B5%8C%E5%85%A5%E5%BC%8F/"/>
    <category term="Cortex-M" scheme="https://r6blog.online/tags/Cortex-M/"/>
    <content>
      <![CDATA[<h4 id="什么是-CCMRAM？"><a href="#什么是-CCMRAM？" class="headerlink" title="什么是 CCMRAM？"></a>什么是 CCMRAM？</h4><p>以 STM32F407 为例，平时我们在使用的时候总会听到 128Kb SRAM 以及 192Kb SRAM 的相关型号，</p><p>这里，不管是192还是128，其实代表的都是同一个型号。从192Kb的视角来看，其表征的是<strong>芯片内部物理上真实存在的全部 SRAM 总容量</strong>，其中可拆分为 (128Kb + 64Kb)。</p><ul><li><strong>主SRAM(128Kb)</strong></li></ul><p>这128Kb的主SRAM是常规内存，可以被DMA以及我们CPU进行访问。其中，128可进一步拆分为(112Kb SRAM1 + 16Kb SRAM2)。此处对于 SRAM1&#x2F;SRAM2 不详细展开。</p><ul><li><strong>CCM SRAM(内核耦合内存)</strong></li></ul><p>内核耦合内存是一块特殊的SRAM，其地址空间被映射在 Code 区的 0x1000 0000（关于 ARM Cortex-M的地址空间布局，详见：<a href="/2026/09/06/%E5%B5%8C%E5%85%A5%E5%BC%8F2026090602/" title="ARM Cortex-M4 地址空间划分">ARM Cortex-M4 地址空间布局</a>）。这块内存最大的特点就是并<strong>没有被挂在AHB总线矩阵上</strong>，而是<strong>直接连接 Cortex 内核的 D-Code 总线</strong>。</p><img src="/2026/09/07/嵌入式2026090701/2026090701_1.webp" style="zoom:80%;" /><p>上图是总线矩阵架构图，从图中可以看出：SRAM1&#x2F;SRAM2 作为通用内存，DMA与CPU均能够访问，而CCM RAM直连 D-Code ，这也就意味着 <strong>只有CPU能够访问这块内存，DMA够不到这个地方</strong>！这是CCM RAM与 普通 RAM 的最大区别所在。</p><p>CCM 挂在 CPU 私有总线上，<strong>AHB 总线矩阵里根本没有它的地址</strong>。DMA 控制器作为 AHB 主设备，<strong>物理上完全看不到 0x1000 0000 这片区域</strong>。如果你把 DMA 的目标缓冲区（比如 ADC 采样数组）定义在 CCM 里，DMA 搬运时总线会直接返回一个错误响应，触发 HardFault。</p><p>总的来说：这一块内存最适合放那种 <strong>CPU频繁读写，但是却不需要 DMA 参与的数据</strong>。</p><hr><h4 id="CCMRAM-的使用"><a href="#CCMRAM-的使用" class="headerlink" title="CCMRAM 的使用"></a>CCMRAM 的使用</h4><p>在默认内存布局的情况下，CCMRAM是不启用的。也就是说你定义的所有的数据结构均存放到了主 SRAM 中。在这里我们以 Keil 为例，讲讲CCMRAM的使用。</p><ul><li><p>要使用 CCMRAM，首先需要在 Keil 的分散加载文件夹中加入 CCMRAM 区域。打开 Keil 的.sct 分散加载文件，向其中加入以下字段：</p><figure class="highlight c"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br></pre></td><td class="code"><pre><code class="hljs c">RW_CCMRAM <span class="hljs-number">0x10000000</span> <span class="hljs-number">0x00010000</span> &#123;<br> *(.ccmram)<br>&#125;<br></code></pre></td></tr></table></figure><p>加入后，整个 .sct 如下</p><figure class="highlight c"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br></pre></td><td class="code"><pre><code class="hljs c">; *************************************************************<br>; *** Scatter-Loading Description File generated by uVision ***<br>; *************************************************************<br><br>LR_IROM1 <span class="hljs-number">0x08000000</span> <span class="hljs-number">0x00100000</span>  &#123;    ; load region size_region<br>  ER_IROM1 <span class="hljs-number">0x08000000</span> <span class="hljs-number">0x00100000</span>  &#123;  ; load address = execution address<br>   *.o (RESET, +First)<br>   *(InRoot$$Sections)<br>   .ANY (+RO)<br>   .ANY (+XO)<br>  &#125;<br>  RW_IRAM1 <span class="hljs-number">0x20000000</span> <span class="hljs-number">0x00020000</span>  &#123;  ; RW data<br>   .ANY (+RW +ZI)<br>  &#125;<br>  RW_CCMRAM <span class="hljs-number">0x10000000</span> <span class="hljs-number">0x00010000</span> &#123;<br>   *(.ccmram)<br>  &#125;<br>&#125;<br></code></pre></td></tr></table></figure><p>这里的含义就是：我们手动新定义了一块内存区域，其起始地址为0x10000000，大小为0x00010000（64Kb）。所有定义在 .ccmram 段的数据结构都将会被放到此内存区域中。</p><p>这里要注意，RW_IRAM1 是 .ANY 属性的，如果定义了全局数据结构但是未显示指定段属性，都将被该区域捕获，即放入主 SRAM 中而不是 CCMRAM。</p></li><li><p>设置好分散加载文件后，定义变量时，为其声明变量属性即可。</p><figure class="highlight c"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br></pre></td><td class="code"><pre><code class="hljs c"><span class="hljs-comment">// 放普通变量.</span><br>__attribute__((section(<span class="hljs-string">&quot;.ccmram&quot;</span>))) <span class="hljs-type">uint32_t</span> my_buffer[<span class="hljs-number">1024</span>];<br><br><span class="hljs-comment">// 放结构体.</span><br>__attribute__((section(<span class="hljs-string">&quot;.ccmram&quot;</span>))) MyStruct_t my_config;<br></code></pre></td></tr></table></figure><p>这里要声明一点：<code>__attribute__((section(&quot;.ccmram&quot;)))</code> 不能够用于修饰函数。你比如以下的行为是绝对错误的。</p><figure class="highlight c"><table><tr><td class="gutter"><pre><span class="line">1</span><br></pre></td><td class="code"><pre><code class="hljs c">__attribute__((section(<span class="hljs-string">&quot;.ccmram&quot;</span>))) <span class="hljs-type">void</span> <span class="hljs-title function_">fast_isr</span><span class="hljs-params">(<span class="hljs-type">void</span>)</span> &#123; ... &#125;<br></code></pre></td></tr></table></figure><p>我们前面已经说过，CCMRAM 只连接到了 D-Code 总线，并未连接 I-Code 总线，而 CPU 取指执行是通过 I-Code 进行的。</p><p>当 CPU 执行 <code>BL</code> 跳转指令试图跳转到 0x1000 0000时：</p><ol><li>CPU 内核会向 I-Code 总线发出取指请求。</li><li>总线矩阵发现根本找不到 0x1000 0000 这个地址。</li><li>CPU 取回的指令错误，执行后触发 Hardfault。</li></ol></li></ul><p>你比如:</p><figure class="highlight c"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br><span class="line">19</span><br></pre></td><td class="code"><pre><code class="hljs c">__attribute__((section(<span class="hljs-string">&quot;.ccmram&quot;</span>))) <span class="hljs-type">void</span> <span class="hljs-title function_">functionB</span><span class="hljs-params">( <span class="hljs-type">void</span> )</span>;<br><br><span class="hljs-type">int</span> <br><span class="hljs-title function_">main</span><span class="hljs-params">( <span class="hljs-type">void</span> )</span><br>&#123;<br>    <span class="hljs-comment">// ...</span><br>    <br>    functionB();<br>    <span class="hljs-keyword">while</span>(<span class="hljs-number">1</span>)<br>    &#123;<br>        <span class="hljs-comment">// ...</span><br>    &#125;<br>&#125;<br><br><span class="hljs-type">void</span> <br><span class="hljs-title function_">functionB</span><span class="hljs-params">( <span class="hljs-type">void</span> )</span><br>&#123;<br>    <span class="hljs-built_in">printf</span>( <span class="hljs-string">&quot;CCMRAM Run the Code!\n&quot;</span> );<br>&#125;<br></code></pre></td></tr></table></figure><p>上述程序执行到 functionB 后，触发 I-Code 取指将立即触发 BusFault ，若 BusFault 未使能则直接上升至 HardFault。</p><p>注:</p><p>CCM 里面可以放入常量，虽然没接入 I-Code，但是可以通过 D-Code总线进行读取访问。语法上没问题，但会占用宝贵的 CCM 空间，且没有性能提升（Flash取指已经很快）。</p><hr>]]>
    </content>
    <id>https://r6blog.online/2026/09/07/%E5%B5%8C%E5%85%A5%E5%BC%8F2026090701/</id>
    <link href="https://r6blog.online/2026/09/07/%E5%B5%8C%E5%85%A5%E5%BC%8F2026090701/"/>
    <published>2026-09-07T07:57:14.000Z</published>
    <summary>
      <![CDATA[<h4 id="什么是-CCMRAM？"><a href="#什么是-CCMRAM？" class="headerlink" title="什么是 CCMRAM？"></a>什么是 CCMRAM？</h4><p>以 STM32F407 为例，平时我们在使用的时候总会听到 128K]]>
    </summary>
    <title>STM32F4 CCM_RAM(内核耦合内存)</title>
    <updated>2026-10-08T07:15:10.243Z</updated>
  </entry>
  <entry>
    <author>
      <name>R6bandito</name>
    </author>
    <category term="嵌入式" scheme="https://r6blog.online/categories/%E5%B5%8C%E5%85%A5%E5%BC%8F/"/>
    <category term="Cortex-M" scheme="https://r6blog.online/tags/Cortex-M/"/>
    <content>
      <![CDATA[<h4 id="Cortex-M4-地址空间布局"><a href="#Cortex-M4-地址空间布局" class="headerlink" title="Cortex-M4 地址空间布局"></a>Cortex-M4 地址空间布局</h4><p>ARM-Cortex M系列的MCU是32位的，因此理论寻址空间也是32位的，达到了4GB（0x0000 0000 ~ 0xFFFF FFFF）。ARM 把这 4GB 按照功能划分成了 5 个固定的分区，不管是哪一家的设备，只要是 Cortex-M 架构，就必须遵从这个设计。然后各自芯片厂商再在此架构下，填充自身的具体设备。</p><p>这里以 Cortex-M4 为例，以下是 Cortex-M4 的 DataSheet 地址空间布局概览图：</p> <img src="/2026/09/06/嵌入式2026090602/2026090602_1.webp" style="zoom:80%;" /><h4 id="代码区-Code"><a href="#代码区-Code" class="headerlink" title="代码区(Code)"></a>代码区(Code)</h4><p>先来看 0x0000 0000 ~ 0x1FFFF FFFF 部分</p><p>这里主要是代码区(Code)，也是 Flash 与 ROM的映射区，CPU 通过 I-Code&#x2F;D-Code 总线取指与读常量。</p><p>这里首先要注意一下，CPU复位后，强制从0x0000 0000这个位置取向量，但是 0x0000 0000 这个地址只是一个映射地址，并不是一个有效的物理地址。至于 0x0000 0000映射到哪里，取决于你的BOOT0与BOOT1引脚的配置。</p><ul><li><strong>BOOT0 &#x3D; 0</strong>：映射到 <strong>Flash（<code>0x0800 0000</code>）</strong>（正常启动流程）。</li><li><strong>BOOT0 &#x3D; 1, BOOT1 &#x3D; 0</strong>：映射到 <strong>System Memory（<code>0x1FFF_0000</code>）</strong>（出厂固化的一个 Bootloader，也就是我们有时候会用到的串口烧录）。</li><li><strong>BOOT0 &#x3D; 1, BOOT1 &#x3D; 1</strong>：映射到<strong>SRAM（<code>0x2000_0000</code>）</strong>（从 SRAM 启动）。</li></ul><p>正是有了这种映射行为，我们才可以通过调整 BOOT 引脚来进入不同的程序模式。</p><p>由于我们使用的是 Cortex-M4 系列，因此有一个 CCM SRAM也被放到了 Code 区的内部。不过该段 RAM 只连接到了 D-Code 总线，因此可以供CPU快速取数据，但是不能将你的代码放入进去让CPU去取指执行，因为没有连接到 I-Code 总线。</p><p>选项字节(Option Bytes)也被放置到了该区域的 (0x1FFF C000)区域，这里了解就好。</p><p>其余部分 Reserved 保留。</p><hr><h4 id="SRAM区"><a href="#SRAM区" class="headerlink" title="SRAM区"></a>SRAM区</h4><p>SRAM区映射在 0x2000 0000 ~ 0x2002 0000（ 128Kb ）。这里是我们的片上 SRAM ，如果你用调试器监控过全局数据的话，会注意到其地址都是 0x200x xxxx 开头的，正是因为我们SRAM被映射到了这一块地址。我们的 .data、.bss、Heap、Stack 都被划分到了这一块空间中。</p><p><img src="/2026/09/06/嵌入式2026090602/2026090602_2.webp"></p><p>这里可以看到，我们的128 Kb SRAM 的来源并不是一整块大的空间，而是物理上焊了两块独立的 SRAM，并且把他们挂到了 AHB 总线的不同端口上。虽然逻辑上看起来是连续的，但是实际上是两块独立的物理设备。</p><p>这么做是为了提高访问效率，如果合并为一块用一个端口，那么当 DMA 和 CPU 均需要访问这块空间时，必须得有一个停下来等另一个操作完毕。而如果划分为独立的两块挂在不同的端口上，则二者可以走不同的通道，实现真正的并行访问。</p><p>在优化时，<strong>可以将需要 DMA 搬运的大容量数据放在SRAM 112Kb中，将需要CPU访问读取的数据放在 SRAM 16 Kb中，可以避免 CPU 访问和 DMA 搬数据时互相堵塞，有效提升运行效率</strong>。</p><p>其余部分 Reserved 保留。</p><hr><h4 id="外设区-Peripherals"><a href="#外设区-Peripherals" class="headerlink" title="外设区(Peripherals)"></a>外设区(Peripherals)</h4><p>外设区就是用来映射外设寄存器地址的。我们常用的 GPIO、UART、CAN、SPI、DMA 等外设及其寄存器地址都映射在这块区域内。</p><p>从上面总概览图已经可以看出，APB1 APB2 AHB 这些总线依次映射在该块区域。</p><p>同一条总线上的外设，地址是按顺序连续分配的。比如 APB1 的 TIM2 基址是 0x4000_0000（起始），TIM3 是 0x4000_0400，TIM4 是 0x4000_0800……每个外设占 0x400（1KB）空间，里面存放该外设的所有寄存器。</p><img src="/2026/09/06/嵌入式2026090602/2026090602_3.webp" style="zoom:80%;" /><p>这里只是展示地址布局，不展开讨论。</p><hr><h4 id="外部存储区-FSMC"><a href="#外部存储区-FSMC" class="headerlink" title="外部存储区(FSMC)"></a>外部存储区(FSMC)</h4><p>外部存储区是 Cortex-M 地址空间中的一块特定区域（0x6000_0000 ~ 0x9FFF_FFFF），由 FSMC 管理。它负责将外部的 SRAM、NOR Flash、NAND Flash 或 LCD 等并行设备，映射到 CPU 的地址空间，使 CPU 可以像访问内部 SRAM 一样，通过简单的指针读写来访问外部设备。</p><p>我们以 FSMC 驱动 8080 并口的LCD作为例子：<br>当你向 0x6000_0000 + 偏移量 写入一个 16 位数据时，FSMC 硬件会自动完成一些时序动作，比如：片选信号或数据电平，或者锁存寄存器等操作。这里我们不展开讨论，只需要知道这块区域的用途即可。</p><hr><h4 id="内核外设区-Internal-Peripherals"><a href="#内核外设区-Internal-Peripherals" class="headerlink" title="内核外设区(Internal Peripherals)"></a>内核外设区(Internal Peripherals)</h4><p>虽然此处字面翻译为这个，但是还是建议理解为<strong>系统私有寄存器映射区</strong>。这里是系统的控制空间，你比如我们常用的 NVIC，Systick，VTOR 以及一些调试组件等等，这些的配置全部映射在了这个区域中。</p><p>这里需要注意的是：这段空间是由 ARM 划定的固定地盘，也就是不管是哪一家的芯片(GD32&#x2F;NXP等等)，只要是 ARM Cortex-M 的架构，这块区域都是一样的。在进行一些跨平台的芯片移植时，只要双方都是 Cortex-M，那么与这个地址部分相关的一些底层外设的程序是无需修改的。</p><hr>]]>
    </content>
    <id>https://r6blog.online/2026/09/06/%E5%B5%8C%E5%85%A5%E5%BC%8F2026090602/</id>
    <link href="https://r6blog.online/2026/09/06/%E5%B5%8C%E5%85%A5%E5%BC%8F2026090602/"/>
    <published>2026-09-06T06:38:48.000Z</published>
    <summary>
      <![CDATA[<h4 id="Cortex-M4-地址空间布局"><a href="#Cortex-M4-地址空间布局" class="headerlink" title="Cortex-M4 地址空间布局"></a>Cortex-M4 地址空间布局</h4><p>ARM-Cortex M系列]]>
    </summary>
    <title>ARM Cortex-M4 地址空间划分</title>
    <updated>2026-10-08T07:15:10.243Z</updated>
  </entry>
  <entry>
    <author>
      <name>R6bandito</name>
    </author>
    <category term="嵌入式" scheme="https://r6blog.online/categories/%E5%B5%8C%E5%85%A5%E5%BC%8F/"/>
    <category term="Cortex-M" scheme="https://r6blog.online/tags/Cortex-M/"/>
    <content>
      <![CDATA[<h4 id="Flash布局"><a href="#Flash布局" class="headerlink" title="Flash布局"></a>Flash布局</h4><img src="/2026/09/06/嵌入式2026090601/2026090601_1.webp" style="zoom:80%;" /><p>Cortex-M 架构中，Flash 主要可以细分为图上几类。文本段(.text)中包含可执行代码 (Executable Code)和常量 ，在文本段之后就是只读数据区域 (.rodata)，只读数据后紧跟着的就是全局数据(.data)。</p><p>被显式初始化的全局数据结构的初始化值就存放于 .data 处，每次上电 __main 都会从该区域将初始化值拷贝到 RAM 中对应的位置，进而全局数据结构可以在一进入用户程序流程就已经被显式赋值。</p><p>这里要强调一点就是：<strong>并不是所有MCU都是这么布局的，这里只针对 Cortex-M 架构</strong>。</p><ul><li>为什么中断向量表始终放在最低地址？</li></ul><p>这是因为MCU复位后，固定会去 0x0000 0000 寻址 MSP 和 Reset Handler 进行启动流程，因此它第一眼必须看到向量表。在这里，0x0000 0000并不是真实的物理地址，而是经过 CPU 映射后的地址。</p><p><strong>硬件复位时，CPU 自动将 Flash的首地址映射到 0x0000_0000。而后强制从 0x0000_0000 取四字节作为 MSP，再取四字节作为 Reset Handler</strong>。</p><ul><li>.data 段的双重身份</li></ul><p>在 Flash 中，.data 叫作 LMA (加载地址)。</p><p>在 RAM 中，.data 叫作 VMA（运行地址）。</p><p>很直白，每次都从 Flash 中加载到 RAM中，记住这一点就好。</p><hr><h4 id="RAM-布局"><a href="#RAM-布局" class="headerlink" title="RAM 布局"></a>RAM 布局</h4><img src="/2026/09/06/嵌入式2026090601/2026090601_2.webp" style="zoom:80%;" /><p>RAM中 .data 段是<strong>存放有初始化值的全局数据结构的具体内存位置</strong>，在 Flash 中 .data 段<strong>存放具体的初始化数值</strong>。上电后由启动脚本进行搬运，上述 Flash 处已经叙述得足够详细，此处不再赘述。</p><p>.bss 紧随 .data 之后，也是一段连续的内存空间，其主要存放未显式初始化初始化为0的全局数据或静态数据结构。上电流程中，__main 会将该区域清0。</p><p>Heap 是堆区，可由启动文件修改其大小。本质就是一块静态巨型数组，采用C标准的动态内存管理算法(malloc&#x2F;calloc&#x2F;free等)进行管理。由于<strong>会产生内存碎片，且分配时间不确定，不可重入</strong>等特性，因此该区域实际上会被修改得很小，基本用不上。</p><p>这里要重点关注的是栈(Stack)：</p><p>Cortex-M 的栈是<strong>满递减栈</strong>（<strong>Full Descending</strong>），也就是栈指针初始时在最高地址，每压入一个数据，SP  就减小，向低地址走。把栈放在最高地址，能让它向下生长时拥有最大的可用空间，避免一开始就撞到 .bss。</p><p>这种“两头往中间挤”的设计，最大限度地利用了 RAM 空间，但也带来了溢出碰撞的风险。</p><p><strong>关于栈溢出</strong>：</p><p>由于栈的生长方向向下，因此我们假设栈一直往下生长（例如开辟了一个局部超级大数据结构），在实际布局中，空闲区剩不了多少，Heap也很小。此时 SP 会跨过空闲区直接击穿 Heap ，现象自然就是堆区数据结构被破坏，malloc&#x2F;free 失败。而后侵入 .bss 所在位置，将全局数据进行篡改。 </p><p>这也是为什么不允许在栈局部开辟大型结构的根本原因。</p><hr>]]>
    </content>
    <id>https://r6blog.online/2026/09/06/%E5%B5%8C%E5%85%A5%E5%BC%8F2026090601/</id>
    <link href="https://r6blog.online/2026/09/06/%E5%B5%8C%E5%85%A5%E5%BC%8F2026090601/"/>
    <published>2026-09-06T01:11:27.000Z</published>
    <summary>
      <![CDATA[<h4 id="Flash布局"><a href="#Flash布局" class="headerlink" title="Flash布局"></a>Flash布局</h4><img src="/2026/09/06/嵌入式2026090601/2026090601_1.webp]]>
    </summary>
    <title>Cortex-M 内存布局</title>
    <updated>2026-10-08T07:15:10.243Z</updated>
  </entry>
  <entry>
    <author>
      <name>R6bandito</name>
    </author>
    <category term="嵌入式" scheme="https://r6blog.online/categories/%E5%B5%8C%E5%85%A5%E5%BC%8F/"/>
    <category term="Note" scheme="https://r6blog.online/tags/Note/"/>
    <content>
      <![CDATA[<h4 id="全局数据结构-静态局部数据结构-普通局部数据结构分别存储在程序的哪些段中？"><a href="#全局数据结构-静态局部数据结构-普通局部数据结构分别存储在程序的哪些段中？" class="headerlink" title="全局数据结构&#x2F;静态局部数据结构&#x2F;普通局部数据结构分别存储在程序的哪些段中？"></a>全局数据结构&#x2F;静态局部数据结构&#x2F;普通局部数据结构分别存储在程序的哪些段中？</h4><p>在进行区分之前，我们先来看看在嵌入式C语言程序中都有哪些核心的内存段划分：</p><table><thead><tr><th align="left">段名</th><th align="left">存放内容</th><th align="left">物理属性</th><th align="left">典型例子</th></tr></thead><tbody><tr><td align="left"><strong>.text</strong></td><td align="left"><strong>代码段</strong>：所有可执行指令、函数体。</td><td align="left"><strong>Flash（只读）</strong></td><td align="left">if、while、函数调用等等。</td></tr><tr><td align="left"><strong>.rodata</strong></td><td align="left"><strong>只读数据段</strong>：常量、字符串字面量。</td><td align="left"><strong>Flash（只读）</strong></td><td align="left"><code>const char *p = &quot;Hello&quot;;</code> 中的字符串 <code>&quot;Hello&quot;</code>。</td></tr><tr><td align="left"><strong>.data</strong></td><td align="left"><strong>已初始化读写数据</strong>：全局&#x2F;静态变量，且有非零初值。</td><td align="left"><strong>Flash存初值，启动时拷贝到RAM</strong></td><td align="left"><code>int a = 5;</code> 中的 <code>5</code> 存在Flash，变量 <code>a</code> 在RAM。</td></tr><tr><td align="left"><strong>.bss</strong></td><td align="left"><strong>零初始化数据</strong>：全局&#x2F;静态变量，无初值或初值为0。</td><td align="left"><strong>RAM（无Flash占用）</strong></td><td align="left"><code>int b;</code> 或 <code>static int c = 0;</code>。启动时由 <code>__main</code> 循环清零。</td></tr><tr><td align="left"><strong>Stack</strong></td><td align="left"><strong>栈（由编译器管理）</strong>：局部变量、函数调用现场（返回地址、寄存器）。</td><td align="left"><strong>RAM</strong></td><td align="left"><code>uint8_t temp;</code>（定义在函数内部的）。</td></tr><tr><td align="left"><strong>Heap</strong></td><td align="left"><strong>堆（由用户管理）</strong>：动态分配的内存。</td><td align="left"><strong>RAM</strong></td><td align="left"><code>malloc(size)</code> 申请的空间。<strong>注意</strong>：如果工程没用到标准 <code>malloc</code>，这个段通常很小甚至为0。</td></tr></tbody></table><ul><li>对于<strong>全局数据结构</strong>：这里要考虑是否初始化为0。看下面的例子：</li></ul><figure class="highlight c"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br></pre></td><td class="code"><pre><code class="hljs c"><span class="hljs-type">uint8_t</span> g_verA;<br><span class="hljs-type">uint8_t</span> g_verB = <span class="hljs-number">50</span>;<br><span class="hljs-type">static</span> <span class="hljs-type">uint16_t</span> g_init = <span class="hljs-number">100</span>;<br></code></pre></td></tr></table></figure><p>三个变量均开辟在全局数据区，<code>g_verA</code> 默认初始化为0，<code>g_verB</code> 和 <code>g_init</code> 都进行了对应的初始化。对于 <code>g_verA</code>，由于没有进行显示初始化，因此被放在了 .bss 段，上电后由 __main 进行清零操作，并且在 Flash 中零占用；</p><p><code>g_verB</code> 和 <code>g_init</code> 进行了显式初始化，因此被放入 .data 段中（这里要注意：被放入.data中的只是变量本身，初始化数据是被放入了 flash 中的）。系统上电后，__main 会将 flash 中的对应初始化数据拷贝到 .data 中对应的位置。这也是为什么我们的全局变量能够一进入程序就已经被赋予一个初始化值的原因。</p><ul><li>对于<strong>普通局部数据结构</strong>：是统一放在函数调用栈中的。</li></ul><figure class="highlight c"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br></pre></td><td class="code"><pre><code class="hljs c"><span class="hljs-type">void</span> <br><span class="hljs-title function_">funcA</span><span class="hljs-params">( <span class="hljs-type">void</span> )</span><br>&#123;<br><span class="hljs-class"><span class="hljs-keyword">struct</span> <span class="hljs-title">test</span> <span class="hljs-title">myTestStructure</span>;</span><br>    <span class="hljs-comment">// ....</span><br>&#125;<br></code></pre></td></tr></table></figure><p><code>myTestStructure</code> 这个结构我们是在函数局部空间进行定义的，因此其被压栈存入到函数栈中。只在当前的作用域有效，一旦函数运行周期结束出栈返回，这个变量的内存空间也随即跟着被销毁了。</p><p>由于栈大小是固定且通常比较小，因此不要在局部定义大型数据结构（例如大数组或大型结构体），注意堤防栈溢出。</p><ul><li><strong>静态局部数据结构</strong>：前面我们说过，static 修饰局部数据结构时不改变其作用域，只规定其生命周期。</li></ul><figure class="highlight c"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br></pre></td><td class="code"><pre><code class="hljs c"><span class="hljs-type">void</span> <br><span class="hljs-title function_">funcA</span><span class="hljs-params">( <span class="hljs-type">void</span> )</span><br>&#123;<br><span class="hljs-type">static</span> <span class="hljs-class"><span class="hljs-keyword">struct</span> <span class="hljs-title">test</span> <span class="hljs-title">myTestStructure</span>;</span><br>    <span class="hljs-comment">// ....</span><br>&#125;<br></code></pre></td></tr></table></figure><p>此处，<code>myTestStructure</code> 虽然定义语句在局部，但是由于 static 的修饰，其真正的内存空间位置是被放在了 .bss 段(未显式进行初始化，因此默认初始化为0)。当程序流程进入 funcA 时，不会压栈 <code>myTestStructure</code>，而是从 RAM 中直接读出该变量，操作完毕后 funcA 返回，<code>myTestStructure</code> 依然有效。</p><p>这里要强调一点：.bss 和 .data 段一大区别就是是否在 flash 中有占用。.data段的数据在上电时需要来自 flash 中的初始化值，而 .bss 不需要，因此 .data 在 Flash 中和 RAM 中是双份空间占用！</p><hr><h4 id="堆和栈的主要区别"><a href="#堆和栈的主要区别" class="headerlink" title="堆和栈的主要区别"></a>堆和栈的主要区别</h4><table><thead><tr><th align="left">对比维度</th><th align="left"><strong>栈（Stack）</strong></th><th align="left"><strong>堆（Heap）</strong></th></tr></thead><tbody><tr><td align="left"><strong>管理方式</strong></td><td align="left"><strong>自动管理</strong>。编译器自动插入入栈&#x2F;出栈指令，用户不需要也不应该插手。</td><td align="left"><strong>手动管理</strong>。用户必须显式调用 <code>malloc</code>&#x2F;<code>calloc</code> 申请，用完必须 <code>free</code>。</td></tr><tr><td align="left"><strong>分配速度</strong></td><td align="left"><strong>极快</strong>。仅涉及栈指针的移动。</td><td align="left"><strong>较慢</strong>。内部涉及搜索算法，需要遍历空闲链表寻找合适大小的内存块。</td></tr><tr><td align="left"><strong>生命周期</strong></td><td align="left"><strong>临时</strong>。函数执行完，里面的局部数据结构立即被销毁。</td><td align="left"><strong>长期</strong>。只要你不主动 <code>free</code>，内存一直有效（哪怕函数已经退出）。漏 <code>free</code> 就会造成内存泄漏。</td></tr><tr><td align="left"><strong>内存碎片</strong></td><td align="left"><strong>无碎片</strong>。后进先出（LIFO）机制。</td><td align="left"><strong>有碎片</strong>。多次申请释放会留下许多细小的空洞，无法被进一步使用（外部碎片）。</td></tr><tr><td align="left"><strong>大小限制</strong></td><td align="left">通常很小，由编译器或链接脚本固定。</td><td align="left">较大。</td></tr></tbody></table><p>这里讲讲标准C和嵌入式C中的关于堆栈相关的一些差异：</p><ul><li><strong>堆内存的来源不一样</strong></li></ul><p>标准C语言中堆由操作系统通过 <code>brk</code>&#x2F;<code>sbrk</code> 系统调用动态扩充，堆区（<code>.heap</code>）位于链接器预留的虚拟地址空间，且在程序运行过程中可以向 OS 申请扩大。</p><p>但在嵌入式环境下，标准C没有所谓的操作系统层调用。其操作的本质是一块预先在编译期就定义好的巨型静态数组，形如 <code>static uint8_t ucHeap[20 * 1024];</code> 这个数组被放在 <code>.bss</code> 或 <code>.data</code> 段，所以堆的大小在编译时就彻底固定了，无法动态扩充。</p><p>现在很多中间件你比如 FreeRTOS &#x2F; lwIP 等等，内部都会实现自身的动态内存管理算法而不是直接使用标准C的实现。<strong>这些管理算法实现的本质其实也是在一块巨型静态数组上进行切割分配和回收</strong>。</p><ul><li><strong>栈溢出后果不同</strong></li></ul><p>标准C栈通常很大（几 MB），且如果栈溢出，操作系统可能会分配新的内存页或触发段错误，程序会崩溃但是容易排查。</p><p>但是在嵌入式中，栈空间很小(通常1~4Kb)，<strong>栈溢出后会静默踩到相邻的全局数据结构或另一个任务栈</strong>，导致程序运行出现 HardFault 。比较难以排查。</p><ul><li><strong>使用标准与安全性</strong></li></ul><p>嵌入式中， 标准 <code>malloc</code> 实现是不可重入的，不应该在多线程环境中使用。裸机环境下若不得不使用，应保证不在 ISR 中使用。因为 <code>malloc</code> 内部涉及搜索算法，其分配时间是不确定的，而 ISR 要求尽快返回。</p><p>同时，不管在任何环境，若必须使用<code>malloc</code> 请一定使用临界区&#x2F;或互斥量等手段进行保护。因为不可重入性，若在分配过程中被打断并在别处再次调用 <code>malloc</code> 就很可能会造成整个堆管理结构直接损坏。</p><p>标准C的堆实现在实际运用中，基本不会被使用到。需要动态内存分配时，应优先考虑适用于嵌入式环境的三方内存分配算法。</p><hr>]]>
    </content>
    <id>https://r6blog.online/2026/09/05/%E5%B5%8C%E5%85%A5%E5%BC%8F2026090501/</id>
    <link href="https://r6blog.online/2026/09/05/%E5%B5%8C%E5%85%A5%E5%BC%8F2026090501/"/>
    <published>2026-09-05T01:26:44.000Z</published>
    <summary>
      <![CDATA[<h4 id="全局数据结构-静态局部数据结构-普通局部数据结构分别存储在程序的哪些段中？"><a href="#全局数据结构-静态局部数据结构-普通局部数据结构分别存储在程序的哪些段中？" class="headerlink" title="全局数据结构&#x2F;静态局部数据]]>
    </summary>
    <title>一些杂记(三)</title>
    <updated>2026-10-08T07:15:10.243Z</updated>
  </entry>
</feed>