STM32F4 CCM_RAM(内核耦合内存)

什么是 CCMRAM?

以 STM32F407 为例,平时我们在使用的时候总会听到 128Kb SRAM 以及 192Kb SRAM 的相关型号,

这里,不管是192还是128,其实代表的都是同一个型号。从192Kb的视角来看,其表征的是芯片内部物理上真实存在的全部 SRAM 总容量,其中可拆分为 (128Kb + 64Kb)。

  • 主SRAM(128Kb)

这128Kb的主SRAM是常规内存,可以被DMA以及我们CPU进行访问。其中,128可进一步拆分为(112Kb SRAM1 + 16Kb SRAM2)。此处对于 SRAM1/SRAM2 不详细展开。

  • CCM SRAM(内核耦合内存)

内核耦合内存是一块特殊的SRAM,其地址空间被映射在 Code 区的 0x1000 0000(关于 ARM Cortex-M的地址空间布局,详见:ARM Cortex-M4 地址空间布局)。这块内存最大的特点就是并没有被挂在AHB总线矩阵上,而是直接连接 Cortex 内核的 D-Code 总线。
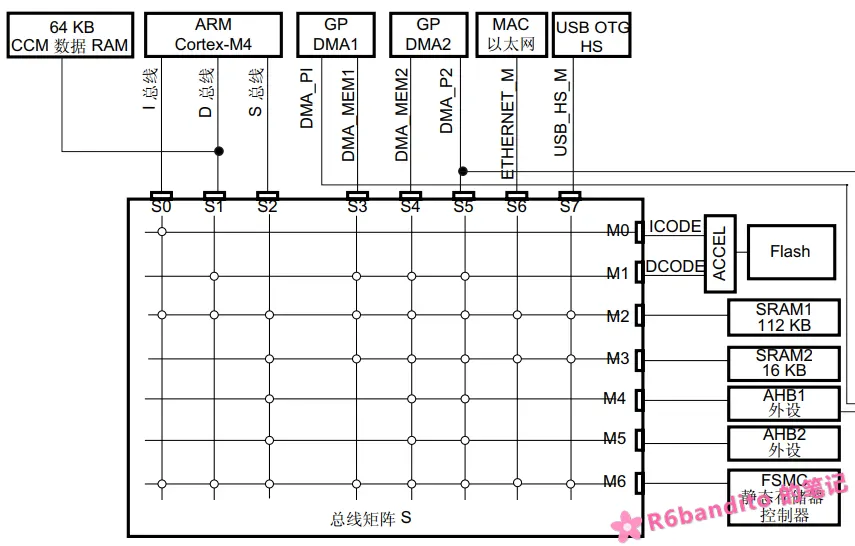
上图是总线矩阵架构图,从图中可以看出:SRAM1/SRAM2 作为通用内存,DMA与CPU均能够访问,而CCM RAM直连 D-Code ,这也就意味着 只有CPU能够访问这块内存,DMA够不到这个地方!这是CCM RAM与 普通 RAM 的最大区别所在。

CCM 挂在 CPU 私有总线上,AHB 总线矩阵里根本没有它的地址。DMA 控制器作为 AHB 主设备,物理上完全看不到 0x1000 0000 这片区域。如果你把 DMA 的目标缓冲区(比如 ADC 采样数组)定义在 CCM 里,DMA 搬运时总线会直接返回一个错误响应,触发 HardFault。

总的来说:这一块内存最适合放那种 CPU频繁读写,但是却不需要 DMA 参与的数据。


CCMRAM 的使用

在默认内存布局的情况下,CCMRAM是不启用的。也就是说你定义的所有的数据结构均存放到了主 SRAM 中。在这里我们以 Keil 为例,讲讲CCMRAM的使用。

  • 要使用 CCMRAM,首先需要在 Keil 的分散加载文件夹中加入 CCMRAM 区域。打开 Keil 的.sct 分散加载文件,向其中加入以下字段:

    1
    2
    3
    RW_CCMRAM 0x10000000 0x00010000 {
    *(.ccmram)
    }

    加入后,整个 .sct 如下

    1
    2
    3
    4
    5
    6
    7
    8
    9
    10
    11
    12
    13
    14
    15
    16
    17
    18
    ; *************************************************************
    ; *** Scatter-Loading Description File generated by uVision ***
    ; *************************************************************

    LR_IROM1 0x08000000 0x00100000 { ; load region size_region
    ER_IROM1 0x08000000 0x00100000 { ; load address = execution address
    *.o (RESET, +First)
    *(InRoot$$Sections)
    .ANY (+RO)
    .ANY (+XO)
    }
    RW_IRAM1 0x20000000 0x00020000 { ; RW data
    .ANY (+RW +ZI)
    }
    RW_CCMRAM 0x10000000 0x00010000 {
    *(.ccmram)
    }
    }

    这里的含义就是:我们手动新定义了一块内存区域,其起始地址为0x10000000,大小为0x00010000(64Kb)。所有定义在 .ccmram 段的数据结构都将会被放到此内存区域中。

    这里要注意,RW_IRAM1 是 .ANY 属性的,如果定义了全局数据结构但是未显示指定段属性,都将被该区域捕获,即放入主 SRAM 中而不是 CCMRAM。

  • 设置好分散加载文件后,定义变量时,为其声明变量属性即可。

    1
    2
    3
    4
    5
    // 放普通变量.
    __attribute__((section(".ccmram"))) uint32_t my_buffer[1024];

    // 放结构体.
    __attribute__((section(".ccmram"))) MyStruct_t my_config;

    这里要声明一点:__attribute__((section(".ccmram"))) 不能够用于修饰函数。你比如以下的行为是绝对错误的。

    1
    __attribute__((section(".ccmram"))) void fast_isr(void) { ... }

    我们前面已经说过,CCMRAM 只连接到了 D-Code 总线,并未连接 I-Code 总线,而 CPU 取指执行是通过 I-Code 进行的。

    当 CPU 执行 BL 跳转指令试图跳转到 0x1000 0000时:

    1. CPU 内核会向 I-Code 总线发出取指请求。
    2. 总线矩阵发现根本找不到 0x1000 0000 这个地址。
    3. CPU 取回的指令错误,执行后触发 Hardfault。

你比如:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
__attribute__((section(".ccmram"))) void functionB( void );

int
main( void )
{
// ...

functionB();
while(1)
{
// ...
}
}

void
functionB( void )
{
printf( "CCMRAM Run the Code!\n" );
}

上述程序执行到 functionB 后,触发 I-Code 取指将立即触发 BusFault ,若 BusFault 未使能则直接上升至 HardFault。

注:

CCM 里面可以放入常量,虽然没接入 I-Code,但是可以通过 D-Code总线进行读取访问。语法上没问题,但会占用宝贵的 CCM 空间,且没有性能提升(Flash取指已经很快)。
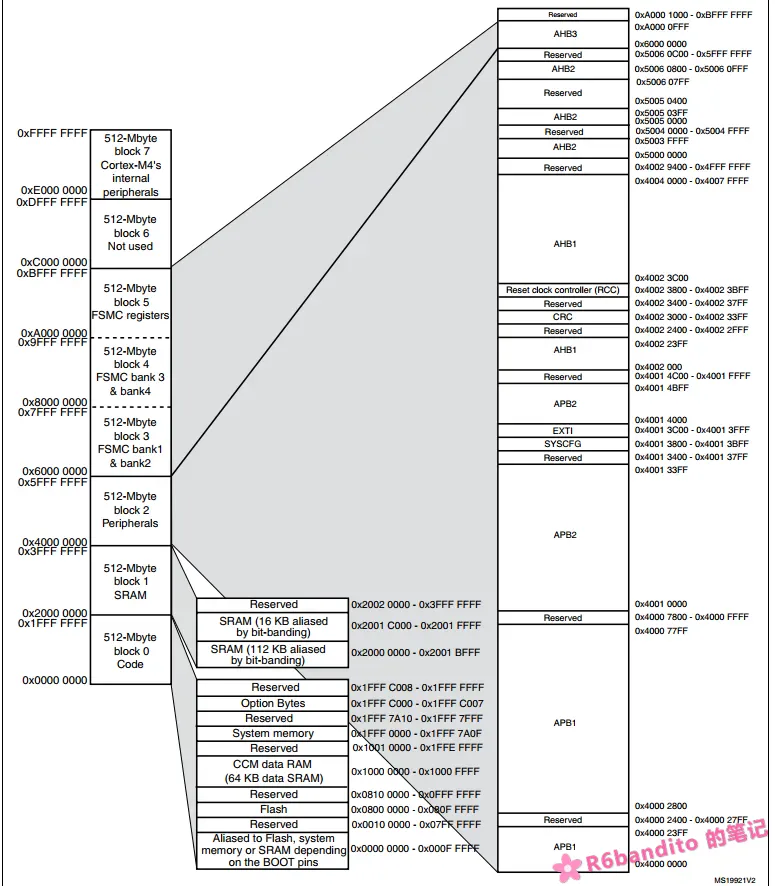

ARM Cortex-M4 地址空间划分

Cortex-M4 地址空间布局

ARM-Cortex M系列的MCU是32位的,因此理论寻址空间也是32位的,达到了4GB(0x0000 0000 ~ 0xFFFF FFFF)。ARM 把这 4GB 按照功能划分成了 5 个固定的分区,不管是哪一家的设备,只要是 Cortex-M 架构,就必须遵从这个设计。然后各自芯片厂商再在此架构下,填充自身的具体设备。

这里以 Cortex-M4 为例,以下是 Cortex-M4 的 DataSheet 地址空间布局概览图:

代码区(Code)

先来看 0x0000 0000 ~ 0x1FFFF FFFF 部分

这里主要是代码区(Code),也是 Flash 与 ROM的映射区,CPU 通过 I-Code/D-Code 总线取指与读常量。

这里首先要注意一下,CPU复位后,强制从0x0000 0000这个位置取向量,但是 0x0000 0000 这个地址只是一个映射地址,并不是一个有效的物理地址。至于 0x0000 0000映射到哪里,取决于你的BOOT0与BOOT1引脚的配置。

  • BOOT0 = 0:映射到 Flash(0x0800 0000)(正常启动流程)。
  • BOOT0 = 1, BOOT1 = 0:映射到 System Memory(0x1FFF_0000)(出厂固化的一个 Bootloader,也就是我们有时候会用到的串口烧录)。
  • BOOT0 = 1, BOOT1 = 1:映射到SRAM(0x2000_0000)(从 SRAM 启动)。

正是有了这种映射行为,我们才可以通过调整 BOOT 引脚来进入不同的程序模式。

由于我们使用的是 Cortex-M4 系列,因此有一个 CCM SRAM也被放到了 Code 区的内部。不过该段 RAM 只连接到了 D-Code 总线,因此可以供CPU快速取数据,但是不能将你的代码放入进去让CPU去取指执行,因为没有连接到 I-Code 总线。

选项字节(Option Bytes)也被放置到了该区域的 (0x1FFF C000)区域,这里了解就好。

其余部分 Reserved 保留。


SRAM区

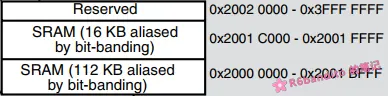
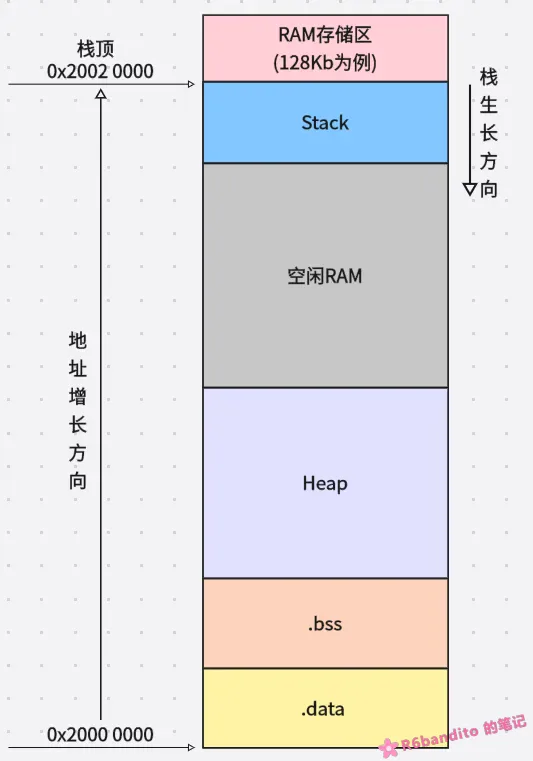
SRAM区映射在 0x2000 0000 ~ 0x2002 0000( 128Kb )。这里是我们的片上 SRAM ,如果你用调试器监控过全局数据的话,会注意到其地址都是 0x200x xxxx 开头的,正是因为我们SRAM被映射到了这一块地址。我们的 .data、.bss、Heap、Stack 都被划分到了这一块空间中。

这里可以看到,我们的128 Kb SRAM 的来源并不是一整块大的空间,而是物理上焊了两块独立的 SRAM,并且把他们挂到了 AHB 总线的不同端口上。虽然逻辑上看起来是连续的,但是实际上是两块独立的物理设备。

这么做是为了提高访问效率,如果合并为一块用一个端口,那么当 DMA 和 CPU 均需要访问这块空间时,必须得有一个停下来等另一个操作完毕。而如果划分为独立的两块挂在不同的端口上,则二者可以走不同的通道,实现真正的并行访问。

在优化时,可以将需要 DMA 搬运的大容量数据放在SRAM 112Kb中,将需要CPU访问读取的数据放在 SRAM 16 Kb中,可以避免 CPU 访问和 DMA 搬数据时互相堵塞,有效提升运行效率。

其余部分 Reserved 保留。


外设区(Peripherals)

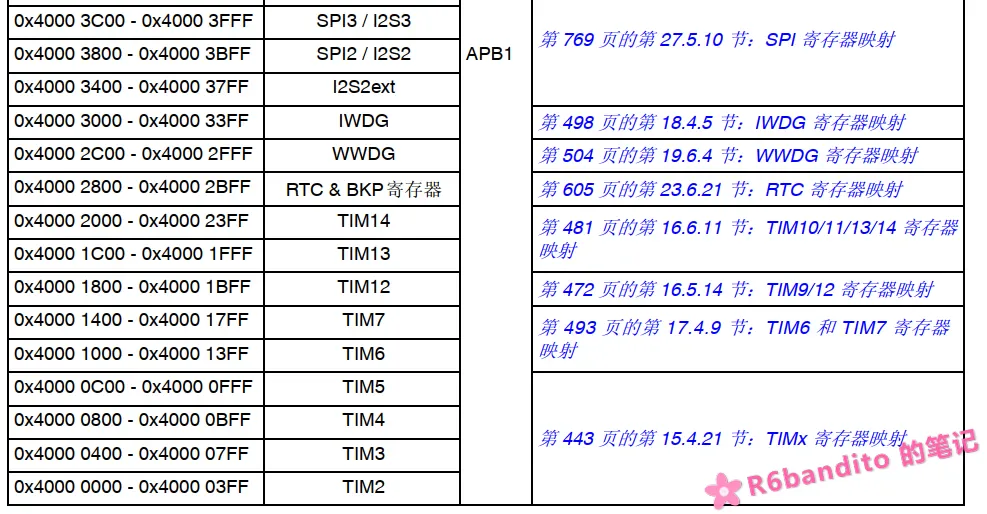
外设区就是用来映射外设寄存器地址的。我们常用的 GPIO、UART、CAN、SPI、DMA 等外设及其寄存器地址都映射在这块区域内。

从上面总概览图已经可以看出,APB1 APB2 AHB 这些总线依次映射在该块区域。

同一条总线上的外设,地址是按顺序连续分配的。比如 APB1 的 TIM2 基址是 0x4000_0000(起始),TIM3 是 0x4000_0400,TIM4 是 0x4000_0800……每个外设占 0x400(1KB)空间,里面存放该外设的所有寄存器。

这里只是展示地址布局,不展开讨论。


外部存储区(FSMC)

外部存储区是 Cortex-M 地址空间中的一块特定区域(0x6000_0000 ~ 0x9FFF_FFFF),由 FSMC 管理。它负责将外部的 SRAM、NOR Flash、NAND Flash 或 LCD 等并行设备,映射到 CPU 的地址空间,使 CPU 可以像访问内部 SRAM 一样,通过简单的指针读写来访问外部设备。

我们以 FSMC 驱动 8080 并口的LCD作为例子:
当你向 0x6000_0000 + 偏移量 写入一个 16 位数据时,FSMC 硬件会自动完成一些时序动作,比如:片选信号或数据电平,或者锁存寄存器等操作。这里我们不展开讨论,只需要知道这块区域的用途即可。


内核外设区(Internal Peripherals)

虽然此处字面翻译为这个,但是还是建议理解为系统私有寄存器映射区。这里是系统的控制空间,你比如我们常用的 NVIC,Systick,VTOR 以及一些调试组件等等,这些的配置全部映射在了这个区域中。

这里需要注意的是:这段空间是由 ARM 划定的固定地盘,也就是不管是哪一家的芯片(GD32/NXP等等),只要是 ARM Cortex-M 的架构,这块区域都是一样的。在进行一些跨平台的芯片移植时,只要双方都是 Cortex-M,那么与这个地址部分相关的一些底层外设的程序是无需修改的。


Cortex-M 内存布局

Flash布局

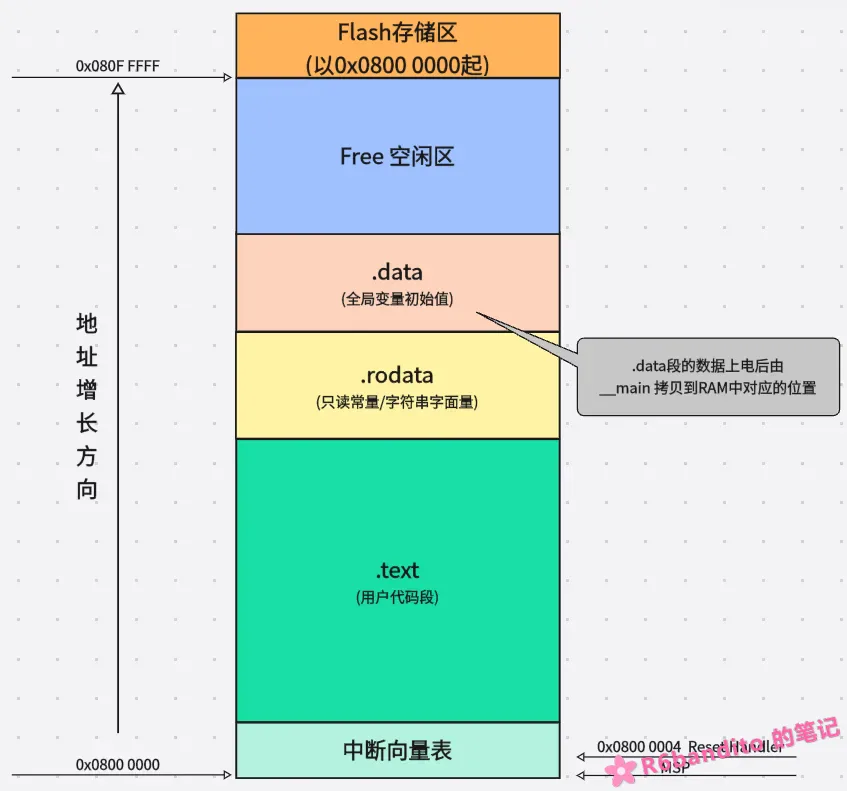
Cortex-M 架构中,Flash 主要可以细分为图上几类。文本段(.text)中包含可执行代码 (Executable Code)和常量 ,在文本段之后就是只读数据区域 (.rodata),只读数据后紧跟着的就是全局数据(.data)。

被显式初始化的全局数据结构的初始化值就存放于 .data 处,每次上电 __main 都会从该区域将初始化值拷贝到 RAM 中对应的位置,进而全局数据结构可以在一进入用户程序流程就已经被显式赋值。

这里要强调一点就是:并不是所有MCU都是这么布局的,这里只针对 Cortex-M 架构。

  • 为什么中断向量表始终放在最低地址?

这是因为MCU复位后,固定会去 0x0000 0000 寻址 MSP 和 Reset Handler 进行启动流程,因此它第一眼必须看到向量表。在这里,0x0000 0000并不是真实的物理地址,而是经过 CPU 映射后的地址。

硬件复位时,CPU 自动将 Flash的首地址映射到 0x0000_0000。而后强制从 0x0000_0000 取四字节作为 MSP,再取四字节作为 Reset Handler。

  • .data 段的双重身份

在 Flash 中,.data 叫作 LMA (加载地址)。

在 RAM 中,.data 叫作 VMA(运行地址)。

很直白,每次都从 Flash 中加载到 RAM中,记住这一点就好。


RAM 布局

RAM中 .data 段是存放有初始化值的全局数据结构的具体内存位置,在 Flash 中 .data 段存放具体的初始化数值。上电后由启动脚本进行搬运,上述 Flash 处已经叙述得足够详细,此处不再赘述。

.bss 紧随 .data 之后,也是一段连续的内存空间,其主要存放未显式初始化初始化为0的全局数据或静态数据结构。上电流程中,__main 会将该区域清0。

Heap 是堆区,可由启动文件修改其大小。本质就是一块静态巨型数组,采用C标准的动态内存管理算法(malloc/calloc/free等)进行管理。由于会产生内存碎片,且分配时间不确定,不可重入等特性,因此该区域实际上会被修改得很小,基本用不上。

这里要重点关注的是栈(Stack):

Cortex-M 的栈是满递减栈(Full Descending),也就是栈指针初始时在最高地址,每压入一个数据,SP 就减小,向低地址走。把栈放在最高地址,能让它向下生长时拥有最大的可用空间,避免一开始就撞到 .bss。

这种“两头往中间挤”的设计,最大限度地利用了 RAM 空间,但也带来了溢出碰撞的风险。

关于栈溢出:

由于栈的生长方向向下,因此我们假设栈一直往下生长(例如开辟了一个局部超级大数据结构),在实际布局中,空闲区剩不了多少,Heap也很小。此时 SP 会跨过空闲区直接击穿 Heap ,现象自然就是堆区数据结构被破坏,malloc/free 失败。而后侵入 .bss 所在位置,将全局数据进行篡改。

这也是为什么不允许在栈局部开辟大型结构的根本原因。


音乐
0:000:00