IP 协议

前言

前面已经梳理了同处于网络层的ARP地址解析协议和ICMP控制报文协议。这些协议都是为了辅助网络层最核心的IP协议而诞生的。网络层的IP协议可以说是整个TCP/IP协议栈的“半壁江山”,是构建起互联网环境的重要一环。

什么是IP协议

IP协议又叫作网际协议,核心定位是负责将网络数据包从源主机端尽可能的运送到目标主机端。IP协议有一个很特殊的地方:位于网络层上接TCP/UDP等高层协议,下接Ethernet等底层通信链路,这就体现了IP协议一个很重要的作用——屏蔽底层不同链路的实现差异,为协议上层及应用层提供统一的标准接口。

需要知道,网络底层链路不只有Ethernet以太网一种,老式的PPP拨号上网、Wi-Fi、移动网络(4G/5G)等等这些都是不同的底层链路协议,而不同协议之间根据适用场景不同往往差距是比较大的。如果没有IP协议,那么上层需要为每一个网络链路定制一套自身的逻辑,类似于这种:

HTTP on Wi-Fi.

HTTP on Ethernet.

HTTP on 4G/5G.

….

这显然不规范,而且没有统一标准各自实现起来十分复杂。

而IP协议正好解决了这个问题:IP协议通过IP地址统一了整个自网络层之上的行为,上层在发送数据包时并不需要关心自己底层处于什么网络链路,只需要将包交给协议栈就行;协议栈规定了统一的数据帧格式,不管底层处于什么链路,怎么去路由,反正帧格式是定死了的,拆掉外壳,里面永远是同一个IP数据报。


IP协议特点

IP协议是无连接不可靠的,发送端随时可以发送数据,接收端也随时可能接收到数据。不管是数据的发送还是接收,每一个数据包都必须带有独立的IP头以及IP地址信息。IP协议不保证数据能够正确送达对端,出错之后尽可能返回ICMP控制报文由上层来决定下一步;就算送达了也不保证顺序。

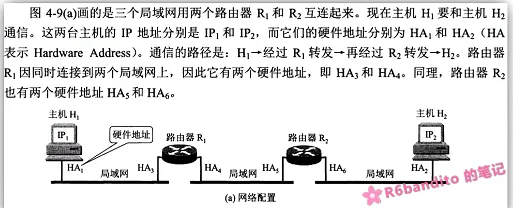
这里要强调一点:一定要正确区分IP地址和MAC地址的行为。IP地址用于在网络环境中逻辑定位通信双方,是跨网段寻址的依据,而MAC地址是底层网络链路中路由数据包的依据。下面以一个例子来讲讲IP与MAC的工作流程:

两个路由器都连接到多个网段,因此网卡接口也有多个(一个接口一个MAC地址)。

  • 主机H1在发送网络数据包之前发现对方H2并不处于同一网段,因此将数据包发往路由器R1。此时整个数据包源IP为IP1,目的IP为IP2。其源MAC为HA1,目标MAC为HA3。
  • 数据包到达路由器R1,被R1通过接口HA4发送给路由器R2。此时源、目的IP不变,源MAC变为HA4,目的MAC变为HA5。
  • 数据包到达路由器R2,R2发现目标设备在HA6接口管理的网段内,通过HA6接口将该包发到目标设备。此时源、目的IP依然不变,源MAC为HA6,目标MAC为HA2。

发现了吗?在本次跨网段的通信示例中,源IP和目标IP地址是不会发生变化的,原因在于IP地址作为“路标”,要指引数据路由方向;而MAC地址则是根据路由方向在两个直连设备之间实现通信,而每个设备接口都是有差异的,因此MAC地址在本次通信中是时刻变化的,用于在物理上真真实实将数据路由到指定下一跳位置。

另外,这里还得附注一下:

IP地址并不是全球唯一的,这里要注意,IP协议划分出了3类私有网段地址,这些地址在全球这么多网段中是肯定有重复的。

但是私有地址是局域网段内部使用的,无法直接连接公网。如果需要连接公网那么得走公网IP+NAT映射。更多详见IP地址体系、NAT地址转换


IP协议帧格式

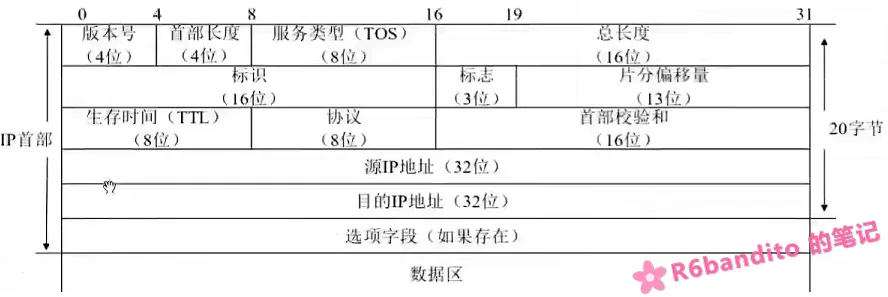
认识一个协议,首先肯定得从协议报文格式入手。IP协议标准头部最少有20字节大小(大部分情况下都是20字节),这20字节携带了必要的通信讯息,如果还有剩余的字节,则为选项字段带一些额外通信参数。

字段 长度 含义
版本号 4 位 IPv4 = 4,IPv6 = 6
首部长度 4 位 以 4 字节为单位,最小 5(20 字节),最大 15(60 字节)
服务类型(TOS) 8 位 优先级 + 延迟/吞吐/可靠性标志(现多用于 DSCP)(看看就行,一般用不上)
总长度 16 位 首部 + 数据,最大 65535
标识 16 位 分片时用于重组,同一数据报的分片共享此 ID
标志 3 位 DF(不分片)、MF(还有分片)、保留位
分片偏移 13 位 本分片在原始数据报中的位置,以 8 字节为单位,同样用于重组
生存时间(TTL) 8 位 每经一跳减 1,为 0 时丢弃并回 ICMP 超时
协议 8 位 上层协议:1=ICMP,6=TCP,17=UDP
首部校验和 16 位 只校验首部,不校验数据
源 IP 32 位 发送方 IP
目标 IP 32 位 接收方 IP
选项 最多40字节 记录路由、时间戳、源路由等(很少用)

至于后面的数据部分,负责承载ICMP/UDP/TCP报文头部及其数据、以及应用层的数据。


IP分片与重组

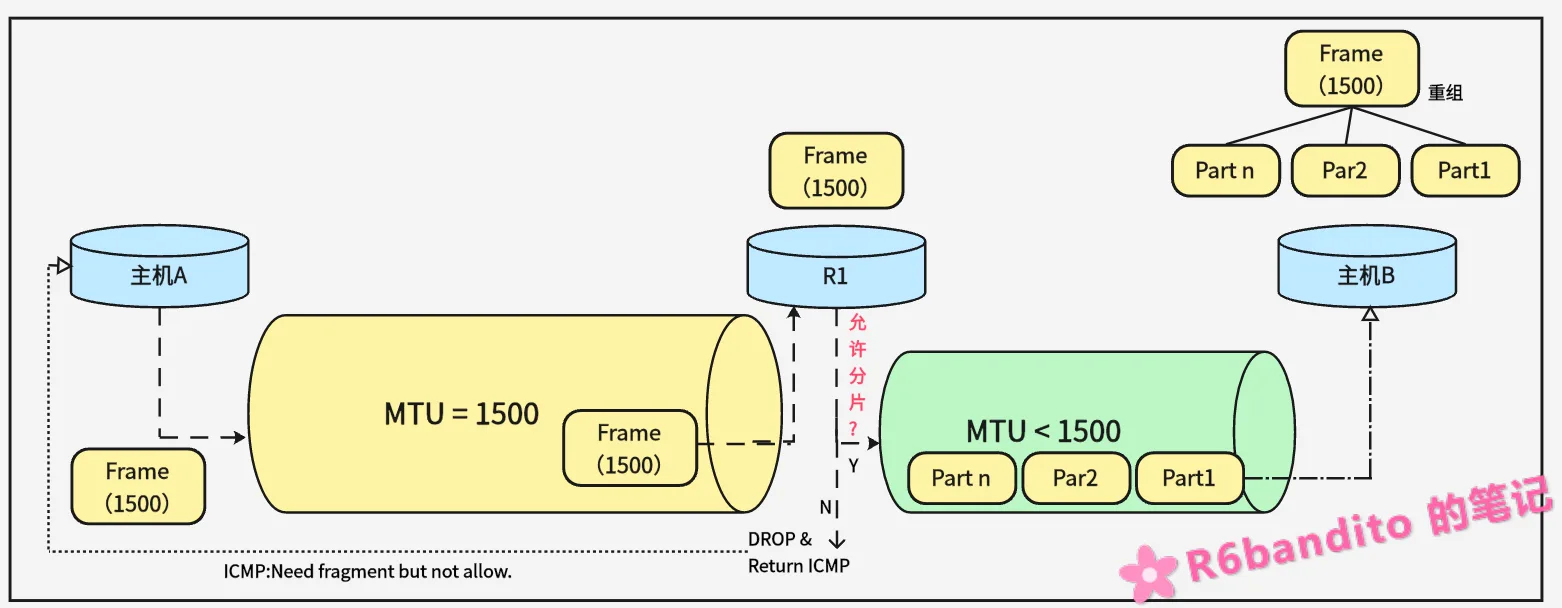
上文我们提到了,IP统一了自网络层之上的内容。但是底层的数据链路层,其实现是各异的。一次跨网段的网络通信底层可能会经过多个不同的物理链路,而每个物理链路都维护有自己的MTU(最大传输单元)表示在该链路层中最大的传输帧长度。例如以太网MTU的典型值就是1500。

这就会导致出现一个问题:假如我们本地网段为以太网,MTU为1500。为了最大化提升效率,我们按照这个数字发包,结果网络包在中间某一跳时,进入了另一类型链路层,通道MTU < 1500了,这时候怎么办?

IP的分片与重组功能就是专门设计出来解决这个问题的——可以将数据包拆开分段传输过去,再由对端正确重组得到完整数据;上述情况中,这个时候中间路由器在传输时就可能会触发IP分片。

为什么说是可能?因为IP分片与重组是可选功能。必须满足以下条件才会触发分片和重组机制:

  • 接收方/发送方均开启IP分片重组功能,否则要不就一个发不出,要不就是收到不会重组。
  • 数据包IP头标志位必须设置可分片。若不允许分片则直接被丢弃。
  • 传输时IP数据报总长(IP头+数据) > 当前传输链路MTU。

上述示意图便是在中间路由器R1分片触发的场景,若允许分片,则进行切片与对端重组;若不允许则回复ICMP报文(类型3Code4)。

当然,要注意的是并不只有中间路由器会触发分片的情况,在源主机有时也会触发分片:比如Ethernet MTU=1500,我们从应用层向IP协议栈递交了一个大于1500字节的数据报,这个时候若我们开启了分片功能,那么在IP层就会主动将其分片发出。

这里讲讲分片重组的一些细节操作:

分片和重组都涉及到IP头部的几个关键字段:标识、标志、分片偏移、以及总长度。

我们以在Ethernet环境下一次性发送4000字节数据(此处演示源主机处分片),并且对端重组并正确接收4000字节数据为例:

  • 在发送数据包前,协议栈会检查总长度是否大于出口网络接口的MTU,如果总长度<MTU则直接发送;若总长度>MTU,则进行下一步。

  • 检查协议栈是否允许分片,若不允许分片则直接拒绝该次请求,并返回对应的错误给上层;若允许分片,则计算需要分为多少片。

  • 本示例要发送4000字节数据,每个分片最大承载的数据量为:1500 - 20(标准IP头部,无选项字节) = 1480字节。简单运算下可以得到总共需要分为三片:
    分片1:IP头20字节 + 1480字节数据;分片偏移0、MF = 1(后面还有分片)

    分片2:IP头20字节 + 1480字节数据;分片偏移185(注意,8字节为单位)、MF = 1(还有分片)
    分片3:IP头20字节 + 1040字节数据;分片偏移370、MF = 0(后面没有分片了)

  • 分片完毕,几个分片包的标识被打上相同ID表示都属于同一个大包,然后逐个以计算出的值填充每个分片的IP头后,依次发出。

这就是发送方IP分片的流程。这里有一个地方要注意:因为分片偏移以8字节为单位,所以除开最后一包数据以外,其它中间的包数据必须能够整除8字节。这通常由协议栈内部进行管理,我们无需干涉。例如将MTU设置为1499,1499 - 20 = 1479 是无法整除8的。这个时候协议栈内部会退到1472,然后剩下的数据丢给下一包。

接收方收到分片数据后:

  • 根据标识 + 源 IP + 目标 IP + 协议号将同一个大包的分片归为一类,并从中找出首片。
  • 而后根据分片偏移将所有分片进行排序。
  • 当所有分片收齐后(收到MF = 0的包),脱掉每个分片的IP头,然后按排序进行拼接。
  • 拼好后将完整数据报递交给上层。

我们在Linux中使用ICMP报文来实际看看该示例的情况:

1
2
3
4
5
6
#终端1
sudo ip link set eth0 mtu 1499 #设置MTU为1499.
ping -M dont -c 1 -s 4000 172.18.224.1 #Ping一次网关,数据大小为4000字节,允许分片

#终端2
sudo tshark -i eth0 icmp

运行后各终端情况如下:

1
2
3
4
5
6
7
8
9
10
11
#终端1
PING 172.18.224.1 (172.18.224.1) 4000(4028) bytes of data.
4008 bytes from 172.18.224.1: icmp_seq=1 ttl=128 time=0.359 ms

#终端2
172.18.228.235 → 172.18.224.1 IPv4 1506 Fragmented IP protocol (proto=ICMP 1, off=0, ID=4237)
172.18.228.235 → 172.18.224.1 IPv4 1506 Fragmented IP protocol (proto=ICMP 1, off=1472, ID=4237)
172.18.228.235 → 172.18.224.1 ICMP 1098 Echo (ping) request id=0x6940, seq=1/256, ttl=64
172.18.224.1 → 172.18.228.235 IPv4 1514 Fragmented IP protocol (proto=ICMP 1, off=0, ID=126b)
172.18.224.1 → 172.18.228.235 IPv4 1514 Fragmented IP protocol (proto=ICMP 1, off=1480, ID=126b)
172.18.224.1 → 172.18.228.235 ICMP 1082 Echo (ping) reply id=0x6940, seq=1/256, ttl=128 (request in 3)

可以看到,MTU=1499的情况下,我们4008字节(ICMP头部还要占8字节)数据被分为了三片,前两片数据负载均为1472(1479不可用,协议栈自动退回1472)。第三片总大小为1098,减去MAC14字节再减去20字节IP头部,最后IP数据负载为1064字节。1064 + 1472 * 2 = 4008字节,验算通过。

但是在实际网络环境中,其实都会尽量去避免使用分片功能。因为一段分片数据中,只要丢一个分片,那么所有分片都必须重传。而且将一段数据拆成多段发送,本身就加大了路由出错的风险,同时也增加设备负担。所以这也是为什么会有PMTUD技术,就是为了保证在正确路由到对端的整个环境中,我该发多大的包以至于不会在中间路径触发分片。


其它

关于选项字段

IP头部最多60字节,扣除掉20字节的固定标准头部,剩下40字节作为选项插入。选项字节部分是可变的,最大40字节,且必须满足4字节对齐(不满足将使用填充字节进行补齐)。

这40字节内部维护了一个类似于K-V(键值对应)的机制:也就是说IP选项的格式如下面所示

1
2
3
4
┌────────┬────────┬──────────────────┐
│Type │Length │ Value |
│1 字节 │1 字节 │ Length-2 字节 |
└────────┴────────┴──────────────────┘
  • Type:选项类型,比如源路由、记录路由路径等。
  • Length:选项总长度。
  • Value:选项的数据部分。

其中,Type的8位又被划分如下:

1
2
3
4
5
6
  0   1   2   3   4   5   6   7
┌───┬───┬───────────────────────┐
│ C │ C │ Number │
└───┴───┴───────────────────────┘
↑ ↑
复制标志 选项类别
  • 复制标志(Copied)占一位,表征是否将该选项字段复制到所有IP分片(若有分片的情况下)。0表示不复制,只有首片具有该选项;1表示复制,每个分片都有。
  • 类别占两位,0=控制;1=保留;2=调试和测量;3=保留。
  • 后面的Number编号就是具体的选项类别了(没用,了解一下)。

你比如:
严格源路由:Type = 137,类别是0(控制)

路径记录:Type = 7,类别是0(控制)

这里有两个特殊的单字节类型选项要注意:NOP、EOL。这两个作为选项但是没有常规控制头的Length和Value部分。NOP用于填补占位(前面说过选项要对齐到4字节,若未对齐就用NOP进行填补对齐)、EOL用于表征选项字段结束。

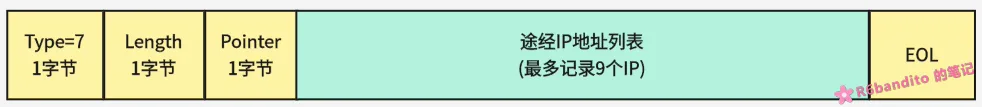
这里以一个路径记录的选项例子来看看实际的布局是什么样的:

路径记录其实就是traceroute,每一个中间路由器都将自己的IP写进Pointer指向的位置,最多记录9跳内容。但是当今互联网发展很多时候通信跳数大于9跳,所以这个功能基本不会使用。

IP选项需要额外解析,降低数据流通速度;而且存在一定的安全风险;同时功能也比较鸡肋。因此在当前的互联网环境中基本上不会被使用,很多协议栈默认设置是关闭IP选项字段功能的。这里只简单讲讲,不深入讨论。


关于TTL

TTL是网络数据包在网络环境中的存活时间。因为占1个字节,所以最大值为255。其典型值为64或255。需要注意的是这里的时间指的并不是我们常识中的分秒这一类时间,而是数据包在路由路径上经过的跳数。

数据包每经过一个中间路由器,TTL都会减少1,当TTL减到0时该包被丢弃。我们在Traceroute中依靠的原理就是TTL超时对端发回ICMP。

之所以要引入TTL,是为了防止失效数据包在网络环境中不断循环被转发。有了TTL,包最多经过255跳就会被丢弃,不会永久占用网络资源。


END

IP协议是网络层的核心,把数据包从源送到目标。不保证可靠、不保证顺序,这些交给上层。IP头的20字节里,每一个字段都有明确分工:版本、长度、分片、TTL、协议、校验和、源/目标 IP。分片是IP应对MTU差异的手段,但代价高,现代网络尽量用PMTUD技术来避免分片。IP选项是补充机制,几乎废弃。

ICMP Internet控制报文协议

引言

在IP网络环境中,我们已经知道:IP数据包的路由并不是完全可靠的,只是尽力而为。IP协议只负责尽可能将你的数据包送达对端,至于能否正确送达并不能完全保证。IP协议自身也并不提供任何的差错报告机制来保证数据递交的有效性,这就会出现一种情况:“我本机发出的数据包,对端是否正确收到?上层是否需要重新发一个过去?许久没和对端通信之后,对端是否还活着并正常提供服务?甚至我自己的网络环境怎么样,能不能和外界正常通信?”这些都是IP协议自身无法解决的问题。

因此我们就需要一个协议来传递整个通信过程中出现的异常行为,以及监控通信是否正常。这个协议就是:ICMP(Internet Control Message Protocol)。


什么是 ICMP?

ICMP 是网络层的一个重要的协议,负责传递网络层的差错和控制信息,不携带用户数据。虽然与IP、ARP协议同属于网络层,但是ICMP其实是依附在IP协议之上的一个更上层的协议。这一点就注定了ICMP的报文形式与ARP的报文形式有本质区别,下文将详细讲述。

这里要注意:ICMP不属于传输层,因此不涉及任何的端口概念。

ICMP有三大功能:IP重定向、差错信息传递(差错报文)、查询控制(查询报文)。


ICMP 报文格式

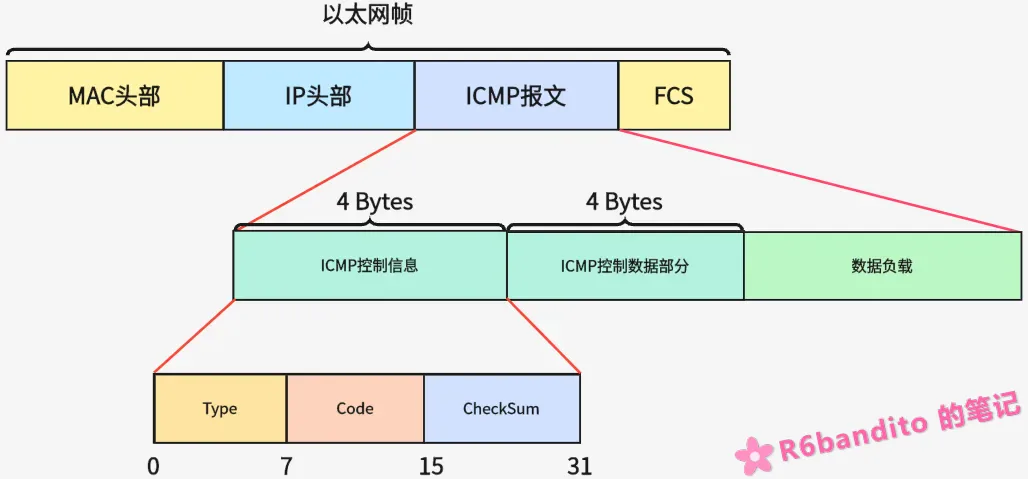
ICMP报文是基于IP协议为基础构建的,也就是说其实ICMP本质也是一个IP包,ICMP的报文部分就是这个IP包的数据段。只是协议栈内部设计了单独处理这种类型报文的逻辑,这也就是我们说的ICMP协议了。

ICMP和ARP虽然共处于网络层,但是在报文形式上的本质区别是:ARP报文直接封装在以太网帧中,不需要有IP头部,ARP在这种前提下可以认为是完全脱离IP协议而独立的;而ICMP报文封装在IP中,与IP协议是一个上下的依赖关系。

ICMP报文控制头部固定8字节,这8个字节的布局如下表所示:

字段 长度 说明
类型 1 字节 标识 ICMP 报文的大类
代码 1 字节 类型的子分类
校验和 2 字节 覆盖整个 ICMP 报文
其余字段 4字节 含义取决于类型和代码

这里讲讲数据部分取决于类型是什么意思:ICMP这8个字节的头部是固定不可变的。前四个字节(类型、代码、校验和)是完全通用的。后4个字节负载根据不同的ICMP报文类型,会采取不同的措施。

就以我们常见的Ping举例:对于Ping的Echo Request和Reply,ICMP数据负载那4个字节被划分为了——标识符(2字节)+序列号(2字节);而对于重定向功能,后4个字节则被定义为新网关IP地址;而对于一些其它类型,则选择保留(全0)。所以总结就是:这4个字节始终存在于固定头部中,只是具体含义随报文类型而变化。

这里我还需要再说明一个地方:

先来看个示例,我们亲自抓一个Ping包看看。我们以Ping网关为例

1
2
3
4
5
6
7
8
9
10
Yukirin@DESKTOP-8BFBE1K:~$ ping -c 1 172.18.224.1
PING 172.18.224.1 (172.18.224.1) 56(84) bytes of data.
64 bytes from 172.18.224.1: icmp_seq=1 ttl=128 time=0.299 ms

--- 172.18.224.1 ping statistics ---
1 packets transmitted, 1 received, 0% packet loss, time 0ms
rtt min/avg/max/mdev = 0.299/0.299/0.299/0.000 ms

Frame 1: Packet, 98 bytes on wire (784 bits), 98 bytes captured (784 bits) on interface eth0, id 0
....

发现了吗?ping输出了一个56(84)大小的数据,而我们tshark抓到的包却显示98字节捕获。这里讲讲这几个数据为什么会出现差异:

  • 56(84):Ping中输出的56,指的是ICMP数据载荷长度,也就是我们上图中数据负载那一部分。而84指的是整个IP数据包的大小。此例中——我们 IP标准头(20字节)+ICMP控制头部(8字节)+ICMP数据负载部分(56字节) = 84字节。
  • 98:tshark在抓包时抓的是整个以太网帧的长度,是货真价实跑在物理传输线路上的,因此要算上MAC头部(14字节)。即:84 + 14 = 98字节。这里要注意:FCS校验和在抓包前通常已经被底层网卡硬件给校验完毕后去除了,所以抓不到也不显示。

讲这个示例目的是为了分清ICMP控制数据部分和ICMP数据负载部分。ICMP控制头8字节,不代表整个ICMP报文就只能是8个字节,控制头后面有时还跟得有数据负载的!你比如我们可以以下列命令构造一个1400字节负载的Ping包

1
2
3
4
5
6
7
Yukirin@DESKTOP-8BFBE1K:~$ ping -c 1 -s 1400 172.18.224.1
PING 172.18.224.1 (172.18.224.1) 1400(1428) bytes of data.
1408 bytes from 172.18.224.1: icmp_seq=1 ttl=128 time=0.374 ms

--- 172.18.224.1 ping statistics ---
1 packets transmitted, 1 received, 0% packet loss, time 0ms
rtt min/avg/max/mdev = 0.374/0.374/0.374/0.000 ms

一定要正确区分控制头的数据部分和控制头之外的ICMP数据负载!

最后这里给出一个类型与代码对应表,后续将以该表为依据讲几个常用的类型:

类型 名称 代码 说明
0 Echo Reply 0 ping 应答
3 Destination Unreachable 0~15 目标不可达
5 Redirect 0~3 重定向
8 Echo Request 0 ping 请求
11 Time Exceeded 0/1 TTL 超时
12 Parameter Problem 0~2 参数错误
13/14 Timestamp 0 时间戳(很少使用)

ICMP 查询报文

ICMP查询机制里面,有多对查询类型报文:比如ping报文(类型8/0)、时间戳(13/14)这些都是ICMP查询机制里面包含的,但是其中很多均已废弃,并不常用。当前ICMP整个查询报文里面最常用的就是ping。

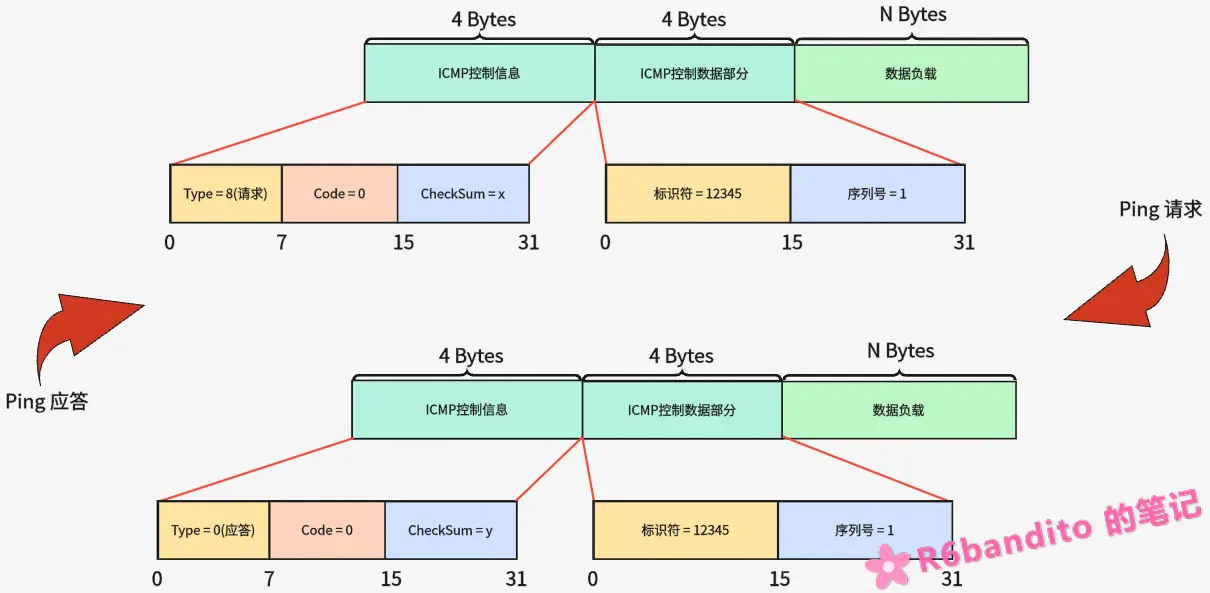
ping报文的作用是检测网络环境的连通性。其请求报文的类型(Type)为8,代码(Code)也为0;ping应答报文的类型为0,代码为0。ping报文ICMP控制头的低4字节数据部分是有使用的,这4个字节被拆分为了标识符(2字节)+序列号(2字节)。

  • 标识符:用于区分由哪个进程发起的本次ping通信。
  • 序列号:区分这是同一个进程的第几个ping包。

如下图就是一个ping请求与应答的ICMP报文部分

可以看到,对于ping的回复基本上是将请求数据包原封不动送回去。由于类型改变了,因此CheckSum要重算,其它地方全部不动。

再看一个实际的抓包示例:

1
2
3
4
5
6
Yukirin@DESKTOP-8BFBE1K:~$ ping -c 1 -s 700 172.18.224.1

tcpdump: verbose output suppressed, use -v[v]... for full protocol decode
listening on eth0, link-type EN10MB (Ethernet), snapshot length 262144 bytes
14:01:19.448455 IP 172.18.228.235 > DESKTOP-8BFBE1K.mshome.net: ICMP echo request, id 13872, seq 1, length 708
14:01:19.448852 IP DESKTOP-8BFBE1K.mshome.net > 172.18.228.235: ICMP echo reply, id 13872, seq 1, length 708

该示例中,标识符就是13872,序列号为1表示是本次ping通信的第一个包。

一次完整的ping通信流程如下:

  • 上层触发ping通信。
  • 协议栈内部构造ICMP Echo Request报文。
  • 将ICMP信息报装入IP数据包中。查路由表决定下一跳,确定IP数据包的发送方向。
  • 若目标设备处于同一网段,则对目标IP发起ARP解析以获取其MAC(若ARP表中无该条目或条目已过期,会先挂起发送动作并广播ARP。详见ARP地址解析协议);若处于不同网段,则解析本网段网关的MAC,发给网关。
  • 目标设备收到后,构造ICMP Reply并回送。
  • 本机收到对方的回复后,计算往返时间。

ICMP 差错报文

差错信息上报机制是ICMP协议的三大功能之一,差错报文专门用来通告网络通信中出现的各种问题。与查询报文不同,差错报文是单向通信!差错报文不能主动请求发送,只能在网络出问题时协议栈内部自行发送。

差错报文主要有以下几个类型:

类型3

Code 含义 典型场景
0 网络不可达 没有路由
1 主机不可达 主机不存在/关机
2 协议不可达 目标不支持该协议
3 端口不可达 目标端口没人监听
4 需要分片但 DF 置位 MTU 问题
5 源路由失败 —
6 目的网络未知 —
7 目的主机未知 —
9/10 网络/主机被管理员禁止 防火墙
13 通信被管理员禁止 防火墙

类型3是平时见得最多的错误类型,例如错误访问了一个未被监听的端口,对端就会发来该类型的报文。这里以一个实际抓包为例:我们在Windows侧的UDP调试助手上发送一个UDP数据报给WSL2中Linux本机的未监听端口8081,同时抓取eth0网卡上的ICMP流量。抓到的数据如下:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
Frame 1: Packet, 75 bytes on wire (600 bits), 75 bytes captured (600 bits) on interface eth0, id 0
Section number: 1
Interface id: 0 (eth0)
Interface name: eth0
Encapsulation type: Ethernet (1)
......
Internet Protocol Version 4, Src: 172.18.228.235, Dst: 172.18.224.1
.......
Protocol: ICMP (1) #ICMP包
Header Checksum: 0xde88 [validation disabled]
[Header checksum status: Unverified]
Source Address: 172.18.228.235
Destination Address: 172.18.224.1 #该ICMP包由172.18.228.235 发往--> 172.18.224.1
[Stream index: 0]
Internet Control Message Protocol
Type: Destination unreachable (3)
[Expert Info (Note/Response): Type indicates an error]
[Type indicates an error]
[Severity level: Note]
[Group: Response]
Code: 3 (Port unreachable) # Type3 Code3 目标端口不可达
....

这里重点来看ICMP部分。我们的UDP数据报从Windows虚拟网卡地址 172.18.224.1 发出,目标为 Linux 本机 172.18.228.235 的 8081 端口。由于Linux本机并未监听该端口,内核直接封装了一个 ICMP Type 3 Code 3(端口不可达) 报文,发送给发送方 172.18.224.1。注意,172.18.224.1 既是WSL的网关,也是Windows宿主机上虚拟网卡的IP,因此该ICMP报文直接到达宿主机,由宿主机的网络栈通知对应的UDP套接字,而无需经过额外的网关转发过程。


类型11:Time Exceed超时

Code 含义
0 TTL 耗尽(传输中)
1 分片重组超时

类型11在平时也十分常见,当我们去尝试连接一个并不存在的地址、或在traceroute场景下经常会与该类型的包打交道。这里同样来看一个实际的抓包示例:这里我们尝试去连接一个不同网段的地址172.16.224.1看看会发生什么。

1
2
3
4
5
6
7
#终端1 构建SYN包尝试连接 172.16.224.1:1240
Yukirin@DESKTOP-8BFBE1K:~$ sudo hping3 -S -p 1240 -c 1 172.16.224.1

#终端2 抓通过网卡的ICMP流量
Yukirin@DESKTOP-8BFBE1K:~$ sudo tshark -i eth0 -x icmp
Running as user "root" and group "root". This could be dangerous.
Capturing on 'eth0'

执行后,两个终端分别得到如下输出:

1
2
3
4
5
6
7
8
9
10
11
#终端1
HPING 172.16.224.1 (eth0 172.16.224.1): S set, 40 headers + 0 data bytes
TTL 0 during transit from ip=10.3.255.38 name=UNKNOWN

#终端2 (抓到的ICMP流量原始数据(以太网帧))
0000 00 15 5d 2e 41 b5 00 15 5d 2e 1f 84 08 00 45 c0 ..].A...].....E.
0010 00 44 c0 bc 00 00 3c 01 23 15 0a 03 ff 26 ac 12 .D....<.#....&..
0020 e4 eb 0b 00 d6 4d 00 00 00 00 45 00 00 28 f1 33 .....M....E..(.3
0030 00 00 01 06 ab 8c ac 12 e4 eb ac 10 e0 01 04 c1 ................
0040 04 d8 42 0a 0d fa 65 71 57 19 50 02 02 00 b6 87 ..B...eqW.P.....
0050 00 00 ..

TTL 0 during transit from ip=10.3.255.38 name=UNKNOWN这里表示我们的包在传输途中TTL已经减为0了,被路由器丢弃。而丢弃该包的路由器正是 10.3.255.38,我们抓到的该包ICMP报文也是该路由器送出给我们的差错报文。

在捕获的原始报文中,我们可以按照格式解析出以下数据

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
IP头:
45 c0 ← 版本 4,首部长度 20 字节
00 44 ← 总长度 68 字节
c0 bc ← 标识
00 00 ← 标志 + 分片偏移
3c ← TTL = 60
01 ← 协议 = 1(ICMP!)
23 15 ← 首部校验和
0a 03 ff 26 ← 源 IP:10.3.255.38(中间路由器)
ac 12 e4 eb ← 目标 IP:172.18.228.235(我们的地址)

ICMP控制头:
0b ← 类型 = 11(Time Exceeded,超时)
00 ← 代码 = 0(TTL 超时)
d6 4d ← 校验和
00 00 00 00 ← ICMP控制头数据部分(类型11保留)

这就是一个货真价实的类型11超时ICMP错误报文,由中间某段路由器发来告诉我们本地包已经被丢了,通信失败。

这里简单讲讲为什么会被丢。首先我们在WSL虚拟环境中的本机地址为 172.18.228.235,网关是172.18.224.1,本地网段的网络地址为172.18.224.0/20(子网掩码:255.255.240.0)。我们请求连接的对方是 172.16.224.1,我们用子网掩码去&一下对方地址,得到 172.16.224.0 != 172.18.224.0。

因此我们的SYN请求包先被发给了我们的网关,然后由网关来到我们宿主机Windows本地,Windows本机查自己的ARP表也找不到该地址,只能继续发给Windows的对外网关。公网路由器并不知道172.16.224.1在哪,只能按默认网关路由,于是该包在网络环境中被反复路由,直到TTL耗尽。

路径大致是这样的: WSL –> Windows –> 校园网/企业网 –> 外部网络。

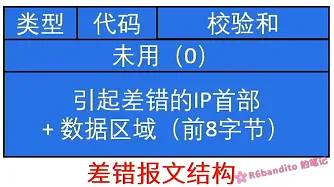
这里需要再多说明一点:看抓包的源码你会发现ICMP控制头之后,还带有不少负载数据。这是因为差错报文不仅需要指明是何种错误,还需要携带原始IP包的IP头部以及原始包的IP数据段至少前8字节。为什么至少8字节?因为在传输层TCP/UDP头部中,前8字节刚好能够拿到源端口、目标端口以及序列号。如下所示:

1
2
3
4
5
6
7
8
9
10
11
12
13
45 00 00 28        ← 原始 IP 头开始
f1 33 00 00 ← 标识 + 标志
01 06 ab 8c ← TTL=1,协议=6(TCP)
ac 12 e4 eb ← 原始源 IP:172.18.228.235(本机)
ac 10 e0 01 ← 原始目标 IP:172.16.224.1(目标)
04 c1 ← 原始源端口:1217
04 d8 ← 原始目标端口:1240
42 0a 0d fa ← 原始序列号
65 71 57 19 ← 原始确认号
50 02 ← 原始数据偏移 + 标志(SYN)
02 00 ← 原始窗口大小
b6 87 ← 原始校验和
00 00 ← 紧急指针

这里数据段多从TCP头部中截取了12个字节。也就是说我们抓的该包中 原始IP头部(20字节) + 原始IP数据段(也就是TCP头)(20字节) = 40字节。多截取数据部分并没有问题,因为协议只规定了至少要8字节。

验算一下:

MAC头14字节 + IP头20字节 + ICMP控制头8字节 + 原始IP头20字节 + 截取的原始IP数据段20字节 = 82字节。正确


ICMP差错报文是有硬性约束的,目的是为了防止差错报文引发互联网环境灾难。

  • ICMP差错报文如果本身也出错,那么将直接丢弃,不允许再次发回ICMP报文描述这次差错。
    这个约束性质在很多网络资料中都会被简化为为了防止出现无限差错风暴而设计的,但是你实际去想一下拓扑会发现无限循环这种网络拓扑实际很难出现,这个特性更多是防止差错链变长占用带宽。

    试想一下:假如允许使用差错回复差错,那么一个差错报文在长达数十跳的路由环境中假如频繁出现差错,那么这一整条线上会多出数个因此而诞生的ICMP报文占用带宽。

  • 不为广播/多播发ICMP报文。

    目标地址是多播或广播的包,出错时不允许发送ICMP报文。源地址是广播/多播地址的包,也不会回复ICMP。

    比如我们向本地广播地址发一个ping包,从底层视角来看这个ping包实际是被该网段下每个设备的以太网路硬件都收到了的,但是包被移交上层时协议栈发现该ICMP报文目标竟然是广播,直接就静默丢弃了。

    这么做是为了防止攻击者利用广播进行攻击,假如攻击者伪造受害者不断ping广播,如果允许回复的话,那么受害者将瞬间被大量ICMP直接打瘫痪。

  • 不为非分片首片的包发差错。

    如果一个包被分片了,只有第一个分片(offset = 0)出错才回差错,后续分片不回。因为分片包只有首片携带了传输层的头部(TCP/UDP),其它分片只携带数据,就算回了差错报文,发送方拿到后也获取不了有效信息反而多个差错报文会干扰发送方,还会多余占用带宽。


重定向 Redirect

除了类型3和类型11这种纯粹的差错上报,ICMP还有一类特殊的报文——重定向(类型5),它不仅能报告异常,还能主动优化主机的路由表。

类型5

Code 含义
0 重定向网络
1 重定向主机
2 重定向服务类型 + 网络
3 重定向服务类型 + 主机

重定向是ICMP报文的又一大应用之一,独特的点在于能够改变主机的路由表,影响主机的路由选择。

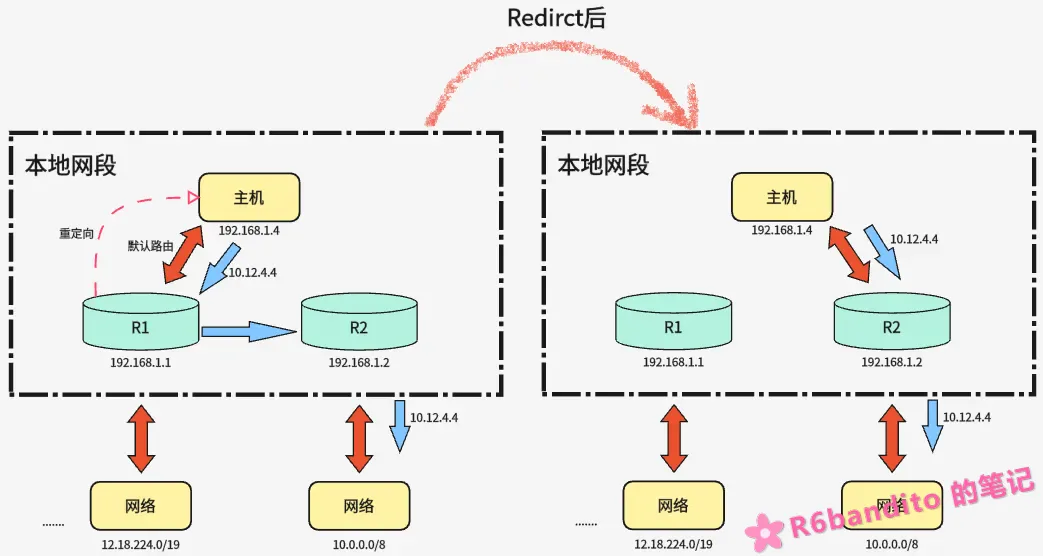
其原理是:当中间路由器发现主机使用的发送路径并不是最优且主机并未开启IP源路径选项时,路由器在向外递送报文的同时会向主机回复一个ICMP重定向报文,这个报文中涵盖了一个新的网关IP。主机收到该报文后,将自己的路由表的网关改为新网关IP,后续流量直接走新网关,不必再经过旧网关多绕一遍,提高通信效率。

例如下图所示:

示例中,我们本机默认网关为R1,当我们本机需要与公网10.12.4.4进行通信时,将数据包发给网关R1(图中蓝色箭头),由R1代发给公网。R1收到后查路由表发现去往10.0.0.0/8更优的下一跳是R2,而且R1与R2与本机都在同一个网段。于是R1在将本次收到的数据包递交给R2的同时也回复一个ICMP重定向给本机,本机收到后将网关改为重定向的IP。后续到10.12.4.4的通信全部直接走R2,就不需要再经过R1绕一遍了。

这里讲讲ICMP的重定向触发条件:

  • 首先肯定是主机和路由器双方都必须允许ICMP重定向,这是根本条件。假如双端有任何一端不允许重定向,那么整个动作都无法完成,无论是否满足剩余条件。
  • 入接口必须等于出接口:一个包从路由器进来,如果进来与出去的流量都是走同一个接口,那么说明发送方和路由器在同一个网段,且下一跳也在同一个网段,这才可能触发重定向。例如上述示例,假设一个网络包从R1(eth0)进来(主机发给R1),R1查路由表发现这个包得给R2,而R2刚好处于同一网段,eth0可以直达,于是包就从eth0进入,eth0发出。满足条件。
  • 下一跳IP和包的源IP处于同一网段:这是肯定的,否则就算你R1给推荐了一个路由,但是与本机不处于同一网段,本机够不到,也是白搭。
  • 包没有被源路由:如果发送方IP选项内部已经指明了该包必须按照指定的路径发,那么路由器就不得擅自修改。
  • 源包不是路由器自己发的:路由器自己发的包,谈不上告诉别人改路由这个情况。

在实验环境中,重定向很难出现,得在多路由环境下才能观测得到,所以此处不给出示例了。

当然,重定向和ARP的学习行为都是一把双刃剑。既然能改路由表,那就避免不了攻击。常见的重定向攻击便是攻击者伪造一个ICMP重定向报文,使得目标主机将路由改为攻击者,后续发给公网的数据全部被攻击者劫持和窃听。

所以当今互联网环境中,重定向功能基本都被主机默认关闭。关于优化问题现在也有不少可靠的动态路由协议,重定向的使用面已经比较窄了。


ICMP 其它应用

Traceroute

traceroute算是ICMP报文一个十分经典的应用了,主要用于跟踪数据包被路由的每一跳节点。其核心原理就是:靠ICMP类型11的超时报文,让包故意在路径上失活,然后依次暴露路径上的每一跳直到包到达目的端。

这里需要知道,IP头部有一个TTL字段,含义是包的生存时间。TTL每经过一跳就会被中间路由器减1,当TTL减到0时,路由器便会丢弃该包,并向源IP回复一个ICMP 类型11的差错报文(超时)。

因此,我们就可以故意发 TTL = 1、TTL = 2、TTL = 3….的包,每一跳路由器都会向我们回复一个ICMP报文,我们通过解析该报文即可获得对应的中间路由器的地址。每收到一个ICMP就暴露一跳,直到包到达目标。

来看下面一个推演流程,例如我们有以下网络拓扑:

1
主机 H ── R1 ── R2 ── R3 ── 目标 T
  • 第一跳:TTL = 1,由本机H->R1。R1收到包后TTL为0,向本机回复ICMP,本机收到ICMP后记录第一跳。
  • 第二跳:TTL = 2,本机H->R2。R2收到后TTL为0回ICMP。本机记录R2。
  • 第三跳:TTL = 3,同理本机收到ICMP后记录R3。
  • 第四跳:TTL = 4,成功到达目标,目标T回复ICMP。本机收到后记录,本轮traceroute探测终止。

关于traceroute的方法,可以自行构造ping包挨个递增TTL或自行构造UDP包访问对端未监听高端口,并自行递增TTL,这是手动的方法。目前也有许多自动化工具用于追踪,比如Linux上的traceroute工具。该工具并不预装,需要使用以下命令进行安装:

1
sudo apt install traceroute

接下来就以该工具演示trace百度的一个实例:

1
2
3
4
5
#终端1
Yukirin@DESKTOP-8BFBE1K:~$ sudo tshark -i eth0 icmp

#终端2
Yukirin@DESKTOP-8BFBE1K:~$ traceroute baidu.com

结果如下所示:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
#终端1
Capturing on 'eth0'
1 0.000000000 172.18.224.1 → 172.18.228.235 ICMP 102 Time-to-live exceeded (Time to live exceeded in transit)
2 0.000000270 172.18.224.1 → 172.18.228.235 ICMP 102 Time-to-live exceeded (Time to live exceeded in transit)
3 0.000000340 172.18.224.1 → 172.18.228.235 ICMP 102 Time-to-live exceeded (Time to live exceeded in transit)
4 0.002513097 10.32.0.1 → 172.18.228.235 ICMP 70 Time-to-live exceeded (Time to live exceeded in transit)
5 0.002513378 10.32.0.1 → 172.18.228.235 ICMP 70 Time-to-live exceeded (Time to live exceeded in transit)
6 0.002513448 10.32.0.1 → 172.18.228.235 ICMP 70 Time-to-live exceeded (Time to live exceeded in transit)
7 0.002515427 10.50.255.253 → 172.18.228.235 ICMP 102 Time-to-live exceeded (Time to live exceeded in transit)
.....

#终端2
traceroute to baidu.com (111.63.65.103), 30 hops max, 60 byte packets
1 DESKTOP-8BFBE1K.mshome.net (172.18.224.1) 0.194 ms 0.150 ms 0.136 ms
2 10.32.0.1 (10.32.0.1) 2.637 ms 2.589 ms 2.575 ms
3 10.50.255.253 (10.50.255.253) 2.547 ms 2.507 ms 2.505 ms
4 58.213.28.201 (58.213.28.201) 4.023 ms 2.861 ms 3.984 ms
5 221.226.71.189 (221.226.71.189) 2.822 ms 221.226.71.193 (221.226.71.193) 2.826 ms 2.809 ms
6 * * *
7 * * *
8 * 202.97.126.73 (202.97.126.73) 21.666 ms *
9 * 202.97.75.130 (202.97.75.130) 23.262 ms 202.97.118.34 (202.97.118.34) 23.245 ms
10 221.183.187.161 (221.183.187.161) 25.720 ms 221.183.86.49 (221.183.86.49) 28.528 ms 221.183.177.109 (221.183.177.109) 21.959 ms
11 221.183.94.25 (221.183.94.25) 27.418 ms 27.320 ms 27.293 ms
12 221.183.148.158 (221.183.148.158) 61.837 ms 221.183.137.222 (221.183.137.222) 34.077 ms 221.183.148.158 (221.183.148.158) 72.360 ms
13 * * *
14 112.54.105.42 (112.54.105.42) 40.671 ms 112.54.105.102 (112.54.105.102) 34.486 ms 112.54.105.110 (112.54.105.110) 25.103 ms
15 * * *
16 * * *
17 * * *
18 * * *
19 * * *
20 * * *
21 * * *
22 * * *
23 * * *
24 * * *
25 * * *
26 * * *
27 * * *
28 * * *
29 * * *
30 * * *

这里可以看到我们的traceroute默认发的是ICMP。整个过程你会发现虽然确实暴露了不少中间路由节点,但是还有不少的***,这通常是正常现象,表示该跳中间节点并没有响应我们。

上述我们说过,每一跳会暴露对应中间路由,这是在理论推演的情况下进行的。实际上每个中间路由节点的配置不同,并不是每一个中间节点都会回复。这其中原因很多:有的服务器防火墙会拦截ICMP,导致探测包被挡、有的服务器默认不响应。你也可以采用UDP或TCP的形式进行追踪,不过此处不展开详细讨论。

关于Traceroute最后补充一点就是:

不只有ICMP可以进行探测,UDP/TCP都可以。

UDP模式的原理是:本机发UDP包访问对端高端口(这些端口往往不被监听),当UDP包处于中间路由器时,中间路由器回复ICMP超时。当包到达对端时触发ICMP:端口不可达,完成探测。

TCP模式是类似的:本机发起TCP握手连接,指定一个目标端口。当TCP包处于中间路由器时,中间路由器依旧回复ICMP超时。当包到达对端后,如果端口被监听,则对面会回复ACK;若端口未被监听,对面会回复RST。本机收到ACK/RST后即可判断成功抵达对端,本次trace结束。

TCP优点在于能够直连对方的服务端口,防火墙往往会拦截ICMP和UDP高端口访问,但是不会拦截TCP的正常端口访问,因此防火墙穿透能力很高。


PMTUD (路径MTU发现)

这也是一个很经典的应用:网络环境中,有时候底层链路的MTU往往是不同的,你比如以太网最大MTU为1500,假如我们为了效率都按照这个MTU来发包,看似没问题。但是数据包在网络中路由时会经过很多跳,有的跳底层MTU并没有1500,那么这个时候就会发生分片行为,降低效率。甚至当我们设置了不分片时,包会一直被丢弃,导致本机通信失败。

所以向对端发包时,我们需要知道整个路由上最小的一个MTU是多少,并以此为依据进行发送。这个时候就要用到PMTUD技术了。

其原理很简单:我们一开始先发一个大包,并设置不允许分片。大包发出去后若直达对端,说明是理想情况,整条路由路径上没有MTU瓶颈。若在中间某一跳卡住了,被卡住的那台中间路由器会回复ICMP类型3代码4(需要分片但不允许分片),并会携带一个MTU值,我们收到后就把包大小调整成新MTU的大小,继续发送。

循环上述操作,最终包会抵达对端,我们也成功探出了整条路径上最小的MTU大小。当然,这种方法肯定是有局限的,因为十分依赖ICMP报文。假如本地防火墙卡了ICMP、或中间路由器不响应ICMP、再或者ICMP路由时出错了,这些都是有可能的。

如果上层没有防御手段,那么表现就是通信挂掉了。本文只讲MTU的探测原理,所以这里不详细展开。


END
ARP 地址解析协议

前言

ARP全称为 Address Resolution Protocol 即地址解析协议。我们已经知道,IP网络中有IP地址这一概念。但是需要明白,在以太网环境中,数据帧在以太网上传输靠的是MAC地址,而IP只是逻辑地址负责逐跳传输。数据帧在传输过程中,不仅需要填上IP,还需要填上MAC地址才能正确在网络环境中路由。

那么在这个流程下,就会出现这样一个问题:我们知道对端的IP地址,但是不知道MAC地址,IP层在组帧的时候没有MAC组不了,自然这帧数据就无法通过网卡被发送出去。为了解决这个问题,我们就引入了ARP协议。

ARP协议的本质其实就是:通过IP逻辑地址来解析出设备的物理MAC地址。


ARP协议简介

了解ARP,首先得弄清楚其所处的位置。在通常情况下,我们可以认为ARP位于TCP/IP四层经典模型(详见OSI七层模型与TCP/IP四层经典模型)的网络层,与IP协议并列。

当我们在局域网中进行通信时,拿到的是目标主机的IP地址,但是IP只是逻辑地址,下层在通信时使用的是MAC地址。因此为了保证下一跳能够跳转到正确地址,IP层就会通过ARP协议获得对端的正确MAC地址,进而填入数据包发给下层去路由。

这里要提前说明一下:ARP协议只适用于同一网段,若两台设备位于不同网段,则不能够直接进行交互,需要交由网关进行代劳。


ARP报文格式

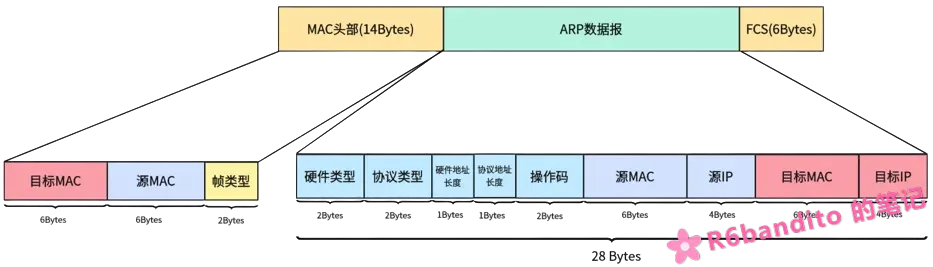
ARP报文格式如下图所示

(勘误:图中FCS校验部分实际应为4字节,图中笔误写成了6字节,下同)

报文中各数据区含义定义如下:

字段 长度 说明
硬件类型 2 字节 以太网为 1
协议类型 2 字节 IPv4 为 0x0800
硬件地址长度 1 字节 MAC 地址长度,6
协议地址长度 1 字节 IP 地址长度,4
操作码 2 字节 1=请求,2=应答
发送方 MAC 6 字节 请求方的 MAC
发送方 IP 4 字节 请求方的 IP
目标 MAC 6 字节 请求时填 0,应答时填对方 MAC
目标 IP 4 字节 要解析的目标 IP

这里要注意一下,IP协议与ARP协议是并列的,所以ARP协议的报文直接封装在以太网帧中,而不是像ICMP一样封装在IP数据报中。

以太网帧头部的帧类型:0x0800 为IP数据包;0x0806 为ARP数据包。在ARP通信中均为0x0806表示该包数据包为ARP包,请协议栈按照ARP的格式进行解析和应答。

在以太网帧头中有一个目标MAC地址,在ARP数据报中也有一个目标MAC地址,这两个地址是不一样的,注意区分!在ARP请求时,以太网帧的目标MAC会填充为FF:FF:FF:FF:FF:FF,即广播地址。而ARP数据报中的目标MAC以0做占位;ARP回复时ARP应答数据报中的源MAC会被替换为所查询IP设备的物理MAC。这里先提前了解下,后续在讲述ARP流程时会详细阐述。


ARP工作流程

这里先引入一个情景:我们处于 192.168.43.0 网段,设备本机IP为 192.168.43.114,MAC地址为 aa:bb:cc:dd:ee:ff。在该网段中也存在一台设备G,其IP地址为 192.168.43.127,MAC地址为 00:11:22:33:44:55。

当我们要向设备G发送一段UDP数据报时,其流程如下:

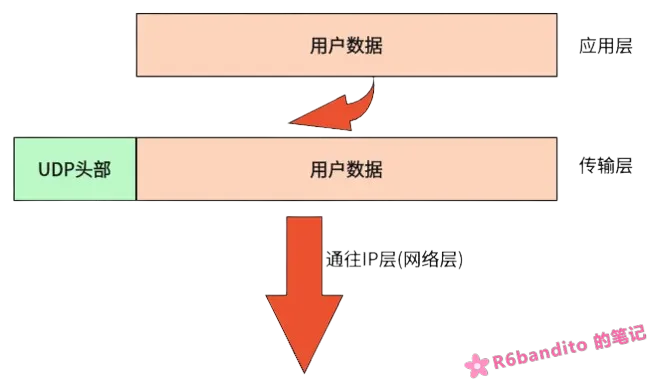
  • 待发数据在传输层打上UDP头部,派发到网络层。
  • UDP报文进入IP层后,IP在对其进行封装IP数据包时发现对端MAC地址未知,暂时挂起发送请求,并请求一次ARP响应。此时,ARP流程正式开始。

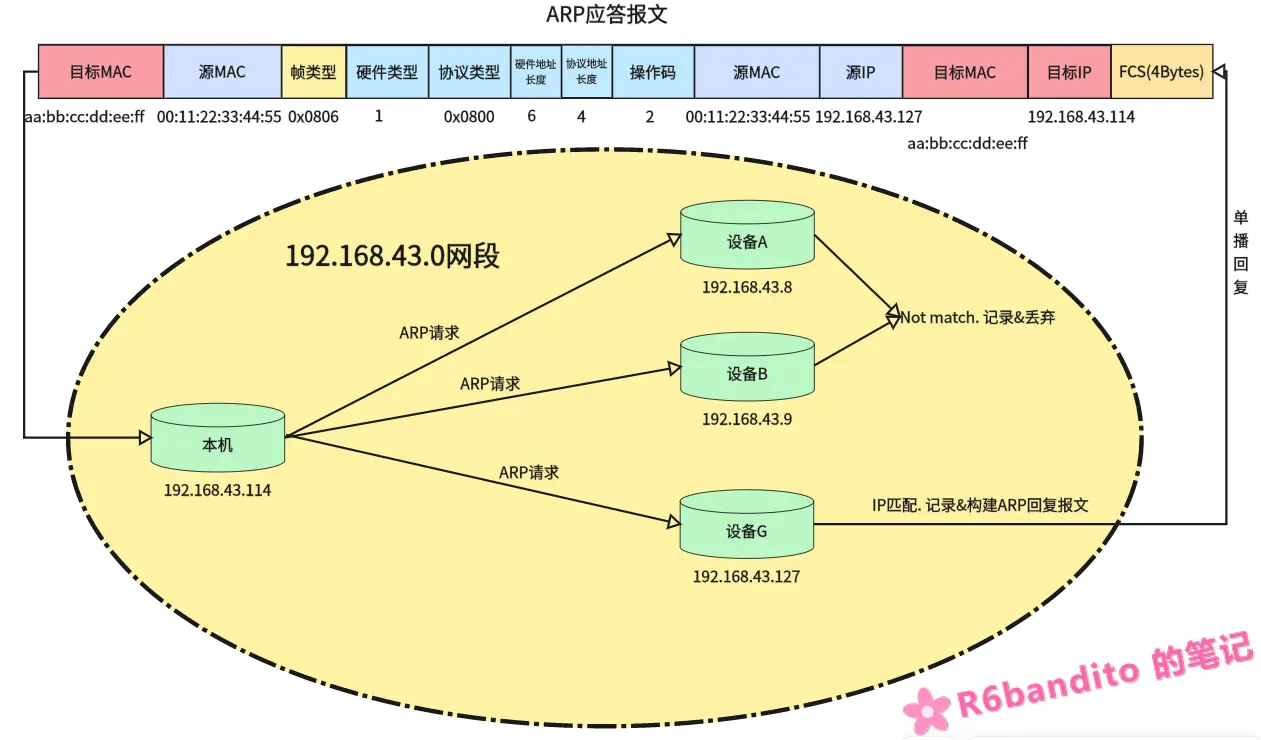
协议栈构建一帧ARP报文,将自己的MAC和IP填入到“源MAC”与“源IP”中,并将目标IP填入。对于目标MAC,用0占位。随后将以太网帧头部的MAC硬编码为 FF:FF:FF:FF:FF:FF 广播地址,通过网卡发送出去。具体如下图:

为什么ARP请求要发广播地址?

我们发起ARP请求目的是查询指定IP的MAC地址,因此必须发广播保证该网段下所有设备都能够收到,否则就失去了查询的意义。这里需要注意的是,这个广播只是本地网段广播,不会也不应该被网关转发。

  • 该网段中所有设备都收到该ARP请求帧,并判断自身是否是被请求IP。如果不是,则记录下发送方的IP和MAC后丢弃该包(这里涉及ARP学习,于下文展开);如果自身就是被请求IP,则记录发送方后构建ARP应答包回复。

如上图所示,设备A、B收到ARP请求后,发现请求IP并非自己,于是记录发送方后丢弃;设备G收到ARP请求后,发现请求的IP正是自己,于是将请求方的MAC和IP记录下来,同时自身构建一帧ARP应答报文(操作码为2),并正确填入双方信息后单播回我们本机。

  • 本机接收到ARP应答包,交给协议栈ARP处理分支进行处理,将目标设备的MAC从数据报中提取出来放入ARP缓存表。
  • 现在我们本机已经有了目标IP设备的物理MAC地址,解挂之前的UDP数据报,正式封装发送。

以上就是一个常规的ARP查询流程。


ARP缓存表

当然,如果每发一次数据都要ARP广播找一次设备,那效率就太低了。为了解决这个问题,我们可以很自然的想到将对方的MAC永久记录下来,这样下次直接查表就可以了。但是这又引入了另一个问题:如果表项固定,那么意味着我们每和一台设备通信,就会在内存中记录下该设备。在真正的网络环境中,拓扑往往是比较复杂的,这就意味着我们设备需要花费大量内存空间来存储每一个通信设备的MAC表项。而且设备在网络环境中MAC是可以被修改的,假如同一台设备MAC变了,那按照原表去查到的是旧MAC,那么发送出去的数据包直接就丢在网络环境中了。种种这些都是要解决的问题。

针对这种情况,协议提供了ARP缓存表这一结构。接下来我将以LwIP的实现为例进行阐述。

表项结构

ARP缓存表结构本质上是一个C结构体,以下是LwIP中ARP缓存表结构:

1
2
3
4
5
6
7
8
9
10
struct etharp_entry {
#if ARP_QUEUEING
struct etharp_q_entry *q; /* 挂起的待发数据包队列 */
#endif
ip4_addr_t ipaddr; /* 目标 IP 地址 */
struct netif *netif; /* 从哪个网卡可以到达目标 */
struct eth_addr ethaddr; /* 目标 MAC 地址 */
u16_t ctime; /* 存活时间,用于老化 */
u8_t state; /* 表项状态 */
};

通常,ARP缓存表一个表项的结构应当包含如下字段:

  • IP地址(ipaddr):该条表项对应的是哪个IP的MAC映射?
  • MAC地址(ethaddr):表项的核心,表示该IP设备对应的MAC地址。
  • 类型:ARP缓存表分为静态类型和动态类型,该字段用于指明该条表项的来源(手动静态配置的/学习到的)。
  • 表项老化时间(ctime):表项清扫时间。这里要明白,内存就那么多(尤其是在嵌入式系统中),我们不可能让大量表项常驻在内存中,必须定时对旧的不活跃的连接进行清扫,释放内存。而清扫动作的根据就是表项老化时间。
  • 网络接口(netif):记录该表项对应的对端设备通过哪个网卡可以到达。

这里你会发现LwIP的实现中并没有类型(type)字段,却多了一个state字段。其实LwIP内部是维护了一个状态机的,而“类型”作为其中一个状态被融合进了里面。关于LwIP的ARP状态机,本篇文章不展开说明。


动态表项与表项老化

缓存表分为了动态表项和静态表项,动态表项一个最大的特征就是具备表项老化的机制。

缓存表老化本质上就是:给每条ARP表项设定了一个生命周期,该周期通过每次通信进行重置。当该生命周期超时后将会被降级重新验证或删除以释放空间。

缓存表老化是维护系统稳健性的一个关键举措:在网络环境中MAC和IP是可能发生变化的(比如更换网卡/IP给另一台设备),而且每个设备自身的内存空间都是有限的。如果表项一直不老化,那么表项越积越多,新旧混杂,占用空间越来越大,将导致内存枯竭或网络帧错误路由。

缓存表老化流程:

  • 当我们通过ARP广播与一台设备建联时,此时ARP缓存表中该表项被正式建立并可用。此时协议栈内部会启动一个定时器记录从此刻开始的老化时间。
  • 在这个老化时间计数期间,若双方再次发生通信,则老化时间被重置(这是符合预期的,表示对端活跃在线,自然要重置老化时间),重新进行计数;若在此期间未发生通信,则定时器继续计数。
  • 若老化定时器超时,则该条表项将从就绪状态(STABLE)被撤下,转为待验证状态(状态改为STABLE_REREQUESTING)。此时,LwIP协议栈会立即广播一个ARP请求等待对方应答。若重复几次对方都无应答,则立即删除该表项并释放内存。

这里要说明一点:上述流程我们是采用LwIP的视角来叙述其行为的,然而在Linux这些现代系统中,其行为略有差异。在Linux中,老化定时器超时后表项状态将由 REACHABLE 变为 STALE,此时Linux并不会像LwIP一样广播ARP,而是继续维护STALE状态,并维护一个stale超时时间,当stale再次超时时该表项将会被删除。在STALE期间,若仍有数据需要发送,内核不会挂起数据等待验证结果,而是先把数据照常发出,同时启动一个短暂的验证窗口(详见下文)。

更重要的一点是:Linux 在验证机制上比 LwIP 更机智——STALE 表项并不会被周期性地主动保活,只有当它再次被使用(也就是恰好有数据要发往这个目标设备)时,内核才会启动验证流程,而且验证的第一步甚至不需要发 ARP:

  1. 状态先由 STALE 转为 DELAY,数据包照常发出;内核在默认 5 秒的窗口内等待”上层反馈”;
  2. 若窗口内上层协议给出了可达性确认(典型如 TCP 收到了对方的 ACK),内核直接认定该表项仍然 REACHABLE——一个 ARP 包都不需要发;
  3. 若窗口内没有任何确认,状态转为 PROBE,此时内核才主动发出单播ARP请求去探测对端,收到正确应答后恢复为 REACHABLE;连续探测失败则标记为不可达并最终回收。

这里还有一个容易忽略的细节:UDP流量触发验证时,必然走到第 3 步。因为 UDP 天生没有确认机制,5 秒窗口内不可能等到”上层反馈”,所以内核只能老老实实发 ARP 探测。

而 STALE 条目本身的回收是在 GC 周期中完成的:一段时间内没有被使用过的条目会被直接删除;若近期被使用过,则只会刷新其时间戳,使其继续存活。下面这条抓包记录就是一次 PROBE 探测的过程:

1
2
3
17:18:09.143971 00:15:5d:e6:af:b7 > 00:15:5d:e6:fc:69, ethertype ARP (0x0806), length 42: Request who-has 172.18.224.1 tell 172.18.228.235, length 28

17:18:09.144126 00:15:5d:e6:fc:69 > 00:15:5d:e6:af:b7, ethertype ARP (0x0806), length 42: Reply 172.18.224.1 is-at 00:15:5d:e6:fc:69, length 28

可以看到,该记录正是一次 PROBE 探测:内核为验证该表项是否仍然有效,主动向 172.18.224.1 发出了一个单播 ARP 请求,对方也正确回复了 ARP 应答,此后该条目恢复为 REACHABLE。相比 LwIP 过期广播重问的做法,Linux 这种策略更节省局域网带宽。

下面再来看一次完整的实测。实验里我们清空ARP表后先 ping 一次网关把表项建立起来,随后不再做任何操作,静置等待表项自然老化。期间系统后台进行了一次NTP校时(一次典型的UDP流量),恰好触发了上面这套验证流程:

1
2
3
4
5
6
7
8
9
10
11
12
13
// 抓包视角(时间戳为与上一行的间隔)
+18.236899 172.18.228.235.35583 > 185.125.190.122.123: NTPv4, Client, length 188
// NTP 请求发出(此时表项为 STALE,转发时随即转入 DELAY)
+0.189621 185.125.190.122.123 > 172.18.228.235.35583: NTPv4, Server, length 188
// NTP 应答到达(UDP 无确认机制,DELAY 窗口不会因此提前结束)
+4.823691 00:15:5d:e6:fc:69 > 00:15:5d:e6:af:b7, ethertype ARP: Request who-has 172.18.228.235
// 网关也向我们发了一个 ARP 请求(网关侧行为,与本机验证流程无关)
+0.000015 00:15:5d:e6:af:b7 > 00:15:5d:e6:fc:69, ethertype ARP: Reply
// 我们回复网关
+0.117068 00:15:5d:e6:af:b7 > 00:15:5d:e6:fc:69, ethertype ARP: Request who-has 172.18.224.1
// DELAY 窗口超时转入 PROBE,向网关发出单播 ARP 请求
+0.000158 00:15:5d:e6:fc:69 > 00:15:5d:e6:af:b7, ethertype ARP: Reply
// 网关回复,探测完成
1
2
3
4
// 状态视角(ip neigh show 逐秒采样)
19:35:44 172.18.224.1 dev eth0 lladdr 00:15:5d:e6:fc:69 STALE
19:35:47 172.18.224.1 dev eth0 lladdr 00:15:5d:e6:fc:69 DELAY // NTP 请求触发验证
19:35:52 172.18.224.1 dev eth0 lladdr 00:15:5d:e6:fc:69 REACHABLE // 探测成功,恢复就绪

可以看到,从NTP请求发出到单播ARP出现,前后恰好间隔约 5 秒,状态机完整走了一圈 STALE → DELAY → PROBE → REACHABLE。这里还有一个特别容易误判的点:由于 5 秒后 PROBE 一发即中,PROBE 状态只存在极短的一瞬间,逐秒采样时甚至完全看不到它。如果只看结果,很容易产生”内核在 STALE 很久之后突然自己发 ARP 保活”的错觉——实际上触发它的,往往只是后台一个不起眼的周期性UDP流量(如NTP、SSDP等),并不是内核在主动保活。

当ARP缓存表已满,但是又需要插入新表项时,会优先淘汰需要验证(也就是已经超时待验证的)表项。若所有表项均处于就绪状态时,则按LRU规则,以ctime老化时间为根据淘汰最旧的动态表项。


静态表项

动态表项的设计固然好,但是仍有部分尴尬的问题用动态表项处理起来并不方便:

  • 某些情况下我们的服务器、固定的上位机等这些设备的IP-MAC映射是不会轻易改变的,如果网段中设备每次与他们通信都从走一遍 “发现/验证” 流程的话,将会占用网络带宽,降低通信效率。
  • 有的设备可能处于安全考虑并不响应ARP(防火墙),或者设备裁切了一个十分精简的TCP/IP协议栈,甚至没有ARP处理逻辑。此时根本无法使用动态表逻辑建立有效的连接表项。

在这种情况下,我们就需要引入静态表项来解决问题。静态表项没有老化机制,由用户手段配置之后其内存永久生效。

LwIP中,关于静态表项的实现是采用了一个 ETHARP_STATE_STATIC 状态融入进表项的state字段来实现的。在协议栈内核表项老化处理逻辑中,会优先判断该条目状态是否为 ETHARP_STATE_STATIC ,如果是则直接跳过该条表项的老化检查逻辑(静态表项不允许老化)。其实现类似于下列伪代码:

1
2
3
4
5
6
7
8
9
10
11
void lwip_arp_timeoutLogic( void )
{
....
for( 遍历所有表项 )
{
if ( arp_table[x].state == ETHARP_STATE_STATIC )
continue; // 静态表项. 直接跳过老化逻辑.

....后续老化判断逻辑.
}
}

LwIP内部也提供了对应的API接口来添加/删除一条静态ARP条目,由于本篇文章并不深究LwIP内部,因此此处不展开叙述。

这里要说明一下的是:静态表项不仅不会老化,还不会被淘汰。

当ARP缓存表满却又需要插入新表项时,ARP协议内核并不会动静态表项,而是按上述的淘汰规则来踢出动态表项。当整个ARP表都是静态表项时,新条目将分配失败,返回错误。

这里给一下静态表项与动态表项的区别:

维度 动态表项 静态表项
来源 ARP 自动学习 手动配置
状态 STABLE / REREQUESTING (LwIP) STATIC (LwIP)
老化 参与老化,超时降级重请求 永不老化
淘汰 表满时可能被 LRU 淘汰 永不被淘汰
回收 会被清理 不会被清理
适用场景 普通设备通信 网关、固定上位机、不响应 ARP 的设备

这里还是要再次强调,静态表项不具备自动感知能力,在更换设备后不会自动更新。如果对端更换了IP-MAC映射,需要手动重新配置或者设计时直接使用动态表项去处理。应只给一些例如网关之类的必要设备配置静态表项,其余设备交给动态表项处理,不能都配置成静态表项。


ARP学习

在上文中我们多次提到过ARP学习,前面我们讲ARP工作流程时,本机广播请求,设备G回复应答,本机把设备G的映射存入缓存表——这个过程就叫作ARP学习。当然,ARP学习并不只局限于两个指定IP设备之间,实际上任何ARP报文到达时,设备都可以触发学习行为(具体是否学习,取决于协议栈的实现策略)。

还是回到上文工作流程中的例子:我们设备向本网段广播了一个ARP请求,设备A、B收到该ARP请求包后,发现目标并不是自己,但是ARP报文本身就携带了本机的IP-MAC映射,为什么不顺手存下来?这样的话假如A、B需要和本机之间通信就不用再ARP了。因此设备A、B都会将本机的IP-MAC映射作为新条目加入到各自的ARP缓存表中。

ARP自主学习行为的好处是很明显的:能够减少整个网段的ARP次数,提高网络通信效率。

不过ARP自主学习是有安全风险的,这也是为什么该功能作为可选功能而不是强制实施再每个设备上。

若设备无条件信任每一个ARP的IP-MAC映射,那么攻击者只需要伪造一份ARP报文,就能随意改写网段中其他设备的缓存表——这就是ARP欺骗。ARP协议本身没有任何认证机制,这个机制带来的副作用在协议层面是无解的。

ARP欺骗

ARP攻击方法很简单,一台普通主机就能发出来,主要有两种:

  • 伪造应答:将自己伪造为网关,直接广播一帧”网关IP的MAC是我”的ARP应答。收到应答的设备会更新已有表项,于是全段设备的网关映射当场被改写,这是最经典的手法。
  • 伪造请求:ARP请求报文同样携带发送方IP-MAC映射,攻击者只要构造一个源信息虚假的请求,收到请求的设备也会顺手把伪造映射记进缓存表。这条路径有时更隐蔽,因为它看起来只是一次普通的询问。

以冒充网关为例,看看一次广播的打击面到底有多大:所有已存在网关表项的设备,表项会被立即改写。这些设备发往网关的流量(也就是全部出网流量)都会先发给攻击者——从这个意义上讲,一次广播就完成了对全段设备出向流量的劫持。若攻击者再开启IP转发,重新将这些流量发回真正的网关,那么就会营造一种网络仍在正常运行的假象,实际上整个网段的流量已经被中间人劫持了。

不过即便如此,现代网络中大量流量都有HTTPS等加密保护,攻击者拿到的也只是密文,所以现实中纯粹的ARP攻击更多被用于断网DoS,或是把流量牵引到钓鱼页面。

防护思路

因此ARP自主学习这一机制在ARP协议中作为可选项给出,LwIP中也提供了编译选项ETHARP_TRUST_IP_MAC用于控制ARP的行为。当然,也有以下的一些方式来进行防护:

  • 使用静态表项:正如上文所说,给网关等关键设备配置静态表项,从根本上拒绝动态改写。
  • 交换机的安全机制:DHCP Snooping + 动态ARP检测(DAI),由交换机校验ARP报文的合法性、丢弃伪造报文;
  • 监控工具:arpwatch 之类的工具持续监听网段内的ARP活动,IP-MAC对应关系变化时及时告警;

可以看到,ARP的无条件学习问题在协议层面无解,所有防护手段的本质都是在协议之外给它补上信任:要么靠人工配置(静态表项),要么靠网络设备的行为约束(交换机安全机制)。


结语

写这篇文章时花了不少时间查阅网络资料,同时根据自己对ARP的理解尽可能的将其叙述清楚。文中涉及到的示例在我的本地环境中已经验证过了一遍,如果您在阅读时发现文章中出现理论错误,还望能够通过邮箱与我联系,帮助我及时修正,不胜感激。

IP 地址体系(IPv4)

前言

入门网络通信的第一步,自然是IP地址体系。IP这个概念在网络通信中十分重要,是通信能否建立的必须前提。在现实世界里,我们要寄一封信,必须在信封上写清楚地址——哪个省、哪个市、哪条街、几号门。网络通信中也是一样的,每个设备都有自己的一个“门牌号”,数据包从你家送到他家,靠的就是这个地址。

要准确的送达数据包,在网络环境中每个设备就必须有一个唯一地址,这个地址就是IP地址。

IP地址分为 IPv4 与 IPv6,目前主流的依然是IPv4,本文所述的IP地址体系也是基于IPv4进行的。

IPv4地址由32位二进制组成,每个字节(8位)划分成一段,采用点分十进制书写便于阅读(例如:192.168.1.10)。一个IP地址内部包含两层信息:网络号与主机号。

网络号有点类似于小区中的楼栋,每一个网络号对应一个网络地址,也就是小区中的一个单元楼。楼里面有许多房间,每个房间就住着一个主机,也就是我们所说的主机号。同一单元楼的主机可以互相“串门”,但是不同单元楼的主机如果需要互相通信,则需要找门卫,也就是我们所说的网关代为传达。这里我们是以现实中小区进行一个比拟便于理解,实际行为也确实是这样的。

下面就以此为基础,详述IPv4的地址体系。


IPv4地址体系

IPv4地址的表示

地址的表述我们在前言其实已经讲过了,这里再说明一下。IPv4地址本质是一个 32位无符号整数:

1
11000000 10101000 00000001 00001010

为了便于表示,我们将其每字节隔开,采用点分十进制表述如下:

1
2
3
4
5
6
11000000 --> 0d192
10101000 --> 0d168
00000001 --> 0d1
00001010 --> 0d10
// 点分拼接后如下.
192.168.1.10

IPv4 地址总量有 2^32 = 4,294,967,296,约合 42.9亿。别看这么多,目前是已经枯竭了的,当前网络环境普遍采用了NAT技术来重映射IP地址,并划分公网与私网段。

关于该技术详见:NAT 地址转换。


IPv4相关核心概念

在详细了解IP地址之前,需要先厘清几个概念:

网络号与主机号:一个IP地址会被子网掩码划分为两个区域,分别为网络号和主机号。当IP地址中主机号全为0时,其代表的就是网络地址,标识的是整个网段的起始地址。主机号就是该网段中某一设备的编号。

子网掩码是目前划分网络地址与主机地址的“度量衡”。在当前网络环境中,普遍使用的是CIDR无类地址(详见下文)划分机制,其子网掩码可以按如下形式表示:

1
2
3
4
192.168.1.10/24
CIDR 划分: 前24位为网络位,后8位为主机位.
其子网掩码为 网络位全1,主机位全0. 即:
255.255.255.0

知道子网掩码后,我们就可以给出精确的网络地址与主机地址的划分机制:

使用IP地址与子网掩码进行与(&)运算,其运算结果就是网络地址。

例如:

1
2
3
4
192.168.43.1/24
子网掩码:255.255.255.0
192.168.43.1 & 255.255.255.0 = 192.168.43.0
192.168.43.0 即为网络地址.

主机号自然就是剩下的8位,总共就2^8 = 256个主机地址。值得注意的是:子网掩码还用来区分网段。如何确定两个设备是否处于同一网段?就用两个设备的IP地址分别去与(&)上子网掩码,若与出来的网络地址相同则说明两个设备处于同一网段。

广播地址是主机号全为1的地址,其作用是向本网段内所有设备广播数据。广播地址是一个特殊的地址,不能单独分给某一个设备。例如上述示例中:192.168.43.0这个网段的广播地址就在192.168.43.255。当该网段内某个设备向该地址发送一个数据包后,整个地址位于192.168.43.x(x!=0 && x!= 255)都能够收到该包数据。

可用主机范围是该网段中,所有能够划给使用使用的具体IP地址的一个范围。这其中需要剔除掉本网段广播地址与网络地址。例如在192.168.43.x网段中,需要剔除掉192.168.43.0(网络地址)和192.168.43.255(广播地址)。剩下的可分配地址范围为192.168.43.1~192.168.43.254,这就是可用的主机地址范围。

网关:网关是出网段的“大门”,不同网段之间需要通信必须经过网关转发。同时,网络拓扑有本地局域网与公网之分,本地局域网中的设备想要与公网服务器进行通信其流量必须经过本地网关出站,外部公网服务器回复的流量也必须经过本地网关入站才能路由到本地局域网的指定设备。

可以把网关理解为一栋“楼”的“楼长”,楼与楼之间的通信事务由网关进行管理,不能让楼中的“居民”直接插手楼间通信事务。


IP地址的分类
有类地址

早期,IP地址被划分为了五类地址,称作有类地址。如下表所示:

类别 首位 第一字节范围 默认掩码 用途
A 0 1 ~ 126 /8 超大型网络
B 10 128 ~ 191 /16 中型网络
C 110 192 ~ 223 /24 小型网络
D 1110 224 ~ 239 — 组播
E 1111 240 ~ 255 — 保留/实验

比如我们家庭常见的192.168.1.2等等这类IP地址就属于C类地址,用于小型网络。一些网络例如10.124.12.10这类地址就属于A类大型网络。

但是目前这种分类已被废弃,原因是地址划分过于死板,不灵活。举个例子:假如南京某高校使用了A类地址,其网络地址为10.0.0.0,让我们算一下该网段拢共支持多少设备:

1
2
按掩码为 255.0.0.0 来算,其主机位有24位.
2^24 - 2 = 16,777,214.

看到了吗?一个网段能容纳1670万台设备,实际上远远用不到这么多。

这就说明旧式五类划分,要不就划分过大浪费;要不就划分过小不满足,例如C类地址一个网段才 2^8 - 2 = 254 台设备。

所以现代网络已抛弃有类划分,改用 CIDR。


CIDR (无类地址)

现代地址体系中,已不再按类进行IP地址的划分,取而代之的是CIDR无类地址机制。

无类地址:即用/n表示一个IP地址中的网络号的位数。也就是说我们可以将任何一个网络切分成一个子网络,按需进行切割。这个机制十分灵活,规避掉了按类型进行划分的弊端。

例如:

1
192.168.1.10/24

/24表示该IP地址中,前24位是网络号,后8位是主机号,所以可以计算出该网段中可用主机地址共有2^8 - 2 = 254个,对应原来的C类地址。

再来看一个示例:

1
2
10.20.30.40/12
--> 子网掩码:255.240.0.0

该IP中,第一个字节8位与第二个字节的高4位为网络号(\12),剩下的20位为该网段中所有的主机号。

  • 网络地址:10.20.30.40 & 255.240.0.0 = 10.16.0.0。所以该网段起始地址为:10.16.0.0。
  • 广播地址:主机号全1,即:10.31.255.255(注:31是这么来的:0001 1111. 高四位是网络号,低四位主机号全1)。
  • 可用主机地址范围:10.16.0.1 ~ 10.31.255.254(去掉网络地址与广播地址)。
  • 可用主机数目:2^(32 - 12) - 2 = 2^20 - 2 = 1,048,574 。

路由表爆炸与超网合并

当然, CIDR除了让地址划分更灵活之外,还解决了有类时代另一个致命问题——路由表爆炸,这是导致有类划分被彻底废弃的根因。路由器在转发数据包时,内部会维护一个路由表——这个表类似于“指路标”一样,指明该包数据下一跳该路由到哪个位置。

在有类地址时代中,每一类网段都要单独写一条路由。而当时C类网络是全球被使用最多的网络类型,1990s拢共有接近几十万个C类网段。这就意味着核心路由器面临路由表膨胀的问题——路由表的体积极具增大,内存不够、查表变慢、CPU 负载爆炸。如果不解决,互联网会在几年内瘫痪。

CIDR正是用于解决这个问题的。其解法是超网合并:若多个连续网段下一跳相同,就把它们合并为一个大网段一并路由。来看个例子:

某公司有16个网段,这16个网段都接在同一台边界路由器后面。对于外部核心路由器而言,去往这16个网段的下一跳完全相同。其网络拓扑如下:

1
2
3
4
192.168.0.0/24
192.168.1.0/24
...
192.168.15.0/24

在旧式有类地址分类下来看,每个网段都要维护一条路由表,那么核心路由器为该公司就需要维护16个路由表条目。

但是在CIDR的视角下,我们会发现这些网络地址的前20位都是相同的,变化主要集中在20~23位。

1
2
3
4
5
1100 0000(192)	1010 1000(168)	0000 0000(0) 0000 0000(0) --> 192.168.0.0
1100 0000(192) 1010 1000(168) 0000 0001(1) 0000 0000(0) --> 192.168.1.0
1100 0000(192) 1010 1000(168) 0000 0010(2) 0000 0000(0) --> 192.168.2.0
....
1100 0000(192) 1010 1000(168) 0000 1111(15) 0000 0000(0) --> 192.168.15.0

这时我们可以用/20来将这16条路由合并为1条。即:192.168.0.0/20。现在我们来验算下看看对不对:

1
2
3
4
子网掩码:255.255.240.0
网络地址:192.168.0.0
广播地址:192.168.15.255
可用地址范围:192.168.0.1 ~ 192.168.15.254

看到没有?合并前后地址范围逻辑完全是正确的。但是以前我们需要维护16个表项,现在只需1个表项就OK。整整缩小了16倍!这个效率是很高的。同时还有个隐藏福利:

合并之前,16个网段,每个网段2^8 - 2 = 254个可用地址。总的下来有254 * 16 = 4064个IP地址可用。

而CIDR合并之后,2^12 - 2 = 4094个可用地址。为什么会这样?因为合并之前每个网段都有个网络地址与广播地址被占用,拢共有16 * 2 = 32个地址被占用。而合并之后只被占用了2个,那么自然多了30个空余位置出来。

超网合并的优势是很明显的:

  • 使得路由表地址缩小:多条路由压缩成一条,减轻核心路由器负担。
  • 地址利用率提高:原来每个 /24 浪费 2 个地址,合并后只浪费整个大网段的2个。
  • 互联网可扩展:全球路由表从几十万条降到几万条,互联网得以持续扩张。

Ps:CIDR超网合并的一个前提是地址连续,这是必要条件!还是上述公司的例子:如果地址不连续有空洞,即192.168.4.0该网段不属于该公司,那么在合并时不能直接合并为192.168.0.0/20,这么强行合并会把不属于自己的地址也圈进来,导致路由错误。这里尤其要注意。


IPv4私有地址

全球有三段公认的私有地址(也可以理解为局域网地址),这些地址在任何局域网段内部都是可以复用的。

类别 地址范围 CIDR
A 10.0.0.0 ~ 10.255.255.255 10.0.0.0/8
B 172.16.0.0 ~ 172.31.255.255 172.16.0.0/12
C 192.168.0.0 ~ 192.168.255.255 192.168.0.0/16
  • 10.0.0.0/8一般用于大型网络(例如校园网等等)需要组建很多子网的场景。
  • 172.16.0.0/12设备数量介于家庭和企业之间,比如一些公司的分支机构。
  • 192.168.0.0/16基本是家庭路由器的默认配置,地址空间小,够用,且不容易和外部网络冲突。

关于使用规定,并没有强制。只要满足:使用三段地址之一;内网地址不冲突;流量出站时经过NAT网关 就行。

在家用网络里面你也完全可以给本地设备划分一个10.0.0.0/8,只是完全没有这个必要。


IPv4特殊地址

除了私有地址,IPv4还有一批有特殊用途、不能随便分配的地址。

  • 0.0.0.0

这是本机任意地址的通配(IP_ADDR_ANY),根据不同的场景有不同的用法。

你比如DHCP请求时,此时本机还没有IP地址,因此使用0.0.0.0进行填充,等待IP分配;同时,当本机作为服务器进行客户端监听时,使用0.0.0.0:80表示监听本机80端口的所有连接。

  • 127.0.0.0/8

本机本地环回地址。整个 127.0.0.0/8 都是回环地址,最常用的是 127.0.0.1(localhost)。

在这个地址下,数据包是发不出网卡的,会在内核內部兜一圈后重新发回给自己。只要协议栈正常,Ping127.0.0.1是一定能够通的。

环回地址只是在测试场景下使用,当移植协议栈之后可以尝试环回给自己发包,如果能正常接收说明协议栈出口和入口都是正常的。正常工况下不应该有设备被分配为环回地址。

  • 255.255.255.255 / x.x.x.255(定向广播)

两个都是广播地址,用于向网段广播数据包的。

对于255.255.255.255:在DHCP发现服务与ARP广播中都有使用,其作用效果仅限本网段,不会被网关转发。也就是说向本网段内所有设备广播,但不能够跨越路由器。

x.x.x.255是定向广播,也是广播的一种,与255.255.255.255的核心区别在于:理论上网关可以转发该数据包,进而广播到别的网段。例如 我们处于网段:192.168.2.0/24,我们可以向另一个网段的广播地址192.168.1.255发包,该包数据经过网关后会进入192.168.1.0/24网段中并且广播给该网段中所有设备。

不过理论是理论,实际是实际。为了安全起见,现代路由器普遍禁止转发定向广播,因此在常规使用过程中,这两个广播地址的效果其实是等价的。

  • 169.254.x.x/16 (链路本地地址)

这个地址用于在DHCP分配失败后的临时组网。当我们设备没能通过DHCP获取到地址时,就会从169.254.x.x/16中选出一个可用地址来分配给自己。此时设备只能和同网段其他 169.254.x.x 设备通信,上不了网。

举个例子:我们家庭网络地址为192.168.43.0/24。而某台设备在向路由器请求DHCP服务时失败,自己给自己分到了169.254.28.6,此时该设备和网段中的其它设备(192.168.43.x)是无法通信的,因为不处于同一个逻辑网段。此时若另一台设备也请求DHCP服务失败,同样给自己分配了一个169.254.28.3。此时,这两台设备处于同一网段,可以相互通信。

链路本地地址没有网关也上不了网,设备应定期重试DHCP服务,如果你发现你的设备IP地址一直为169.254.x.x,那么多半就是DHCP出问题了。

  • 224.0.0.0/4 (组播地址)

用于一对多通信。例如视频直播:一个源向一组接收者发送,用组播地址。这里关于组播不展开。


NAT 地址转换

引言

在网络通信中,IP地址是不可或缺的一环,无论是什么通信方式,均离不开IP地址。目前主流的IP地址协议为IPv4,一个IPv4地址由32位二进制组成,在表示上采用点分十进制的拆分成四段进行表示。让我们来计算下拢共有多少个IPv4地址可供分配:2^32 - 1 ≈ 42.9亿,考虑到网络地址、广播地址、保留地址等开销,实际可供分配给主机的地址还要更少。

在当今互联网飞速发展的情况下,IPv4地址已经枯竭,IPv6虽然可以从根本上解决IP地址不足的问题,但是目前仍有多数网络设备是基于IPv4的,因此在这个过渡期间就必须得有一个对应的技术来暂时解决这个问题。

NAT(Network Address Translation) 网络地址转换技术正是于此背景之下诞生的。该技术使每个网段更加独立:也就是网段内部私有域中的设备不再能够直接与互联网通信,而是必须走网关通过NAT转换之后才能与外部互联网建立通信。

NAT 技术就是在私网地址与公网地址之间相互转换的,说准确点就是:NAT 技术通过在网关处修改 IP 包的源地址或目标地址,实现私网与公网之间的地址映射。

多个私网地址可以共用一个公网地址,这样即保证了网络通信,又节省了公网地址,这就是NAT的优点。


NAT 做到了什么?

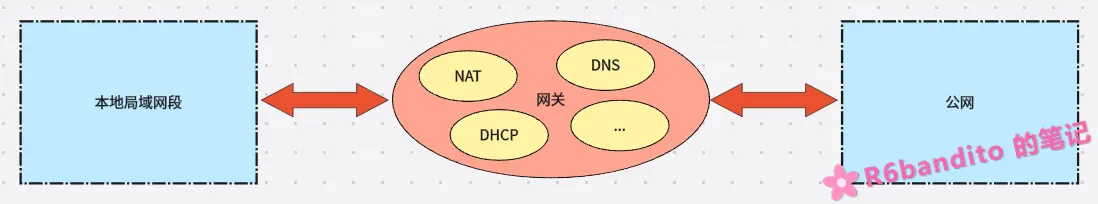
这里需要先声明一点:NAT != 网关。NAT与网关是包含关系——NAT是网关的一个功能子集。网关除了NAT之外,还能集成 DHCP、DNS、防火墙等网络与安全服务,不能简单认为NAT就是网关。

  • NAT 让内网与公网之间无法直接互访。内部私有 IP 地址对外不可见,天然隐藏内网拓扑。外网在没有端口映射的情况下无法主动连接到内网设备。
  • NAT允许灵活组网。私网段用户可以随意使用,本地局域网段无需申请公网IP,就算发生冲突也只限于该网段内部。
  • 极大节省公网IP。通过NAPT技术,一个公网IP可以让数十台,甚至上百台设备同时上网。

目前只要是接入了互联网的网关设备,大部分都集成了NAT技术。

当然,NAT的引入也带来了一定的副作用:

破坏了端到端的通信,增大了网关的负载,也使得P2P通信更加困难。以部分联机游戏举个例子,有的游戏提供 P2P 联机模式,理想情况下,联机双方设备只需要知道对方的IP和端口就能够发起直连,这是双向对称的。

但是,当处于NAT环境下时,由于双方的NAT类型和严格程度不同,所以很可能会出现A发往给B的包,在NAT处被丢掉或反之同理。这就是NAT引入之后带来的不便。

这里附一个常用私有地址域范围表:

类 地址范围 CIDR
A 10.0.0.0 - 10.255.255.255 10.0.0.0/8
B 172.16.0.0 - 172.31.255.255 172.16.0.0/12
C 192.168.0.0 - 192.168.255.255 192.168.0.0/16

这三类地址是全球公认的私有地址,本地网段中想怎么使用都行。即使两个不同的公司内部都用了 192.168.1.0/24,只要他们不直接合并网络,就绝不会冲突。

并且这三类地址也是不可直接路由的,任何公网核心路由器只要看到目标是这三类地址其中之一,就会直接丢弃数据包。所以这些地址只能在局域网内“自娱自乐”,上网必须经过NAT转换。


NAT 的类型与工作原理

静态NAT

静态NAT的规则很简单:永久将一个内网私有地址映射到一个公网地址,每个映射在配置时都是写死在NAT表中的。

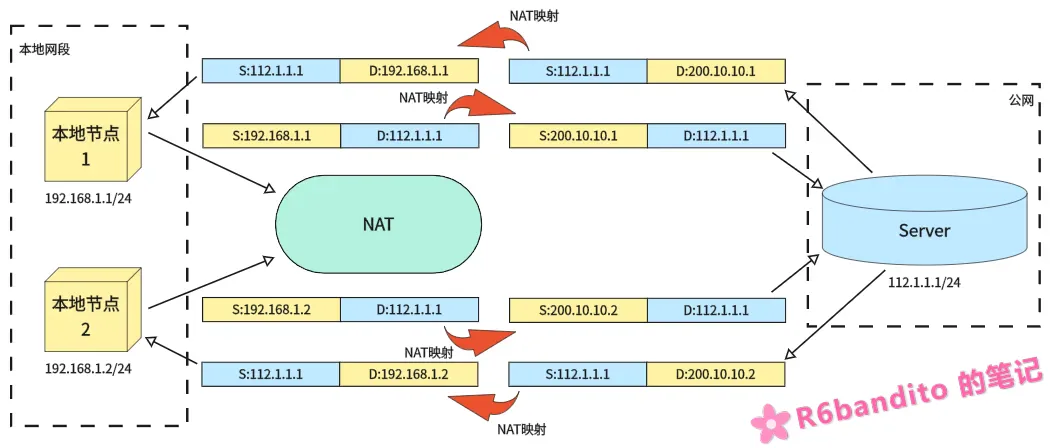
如下图所示:

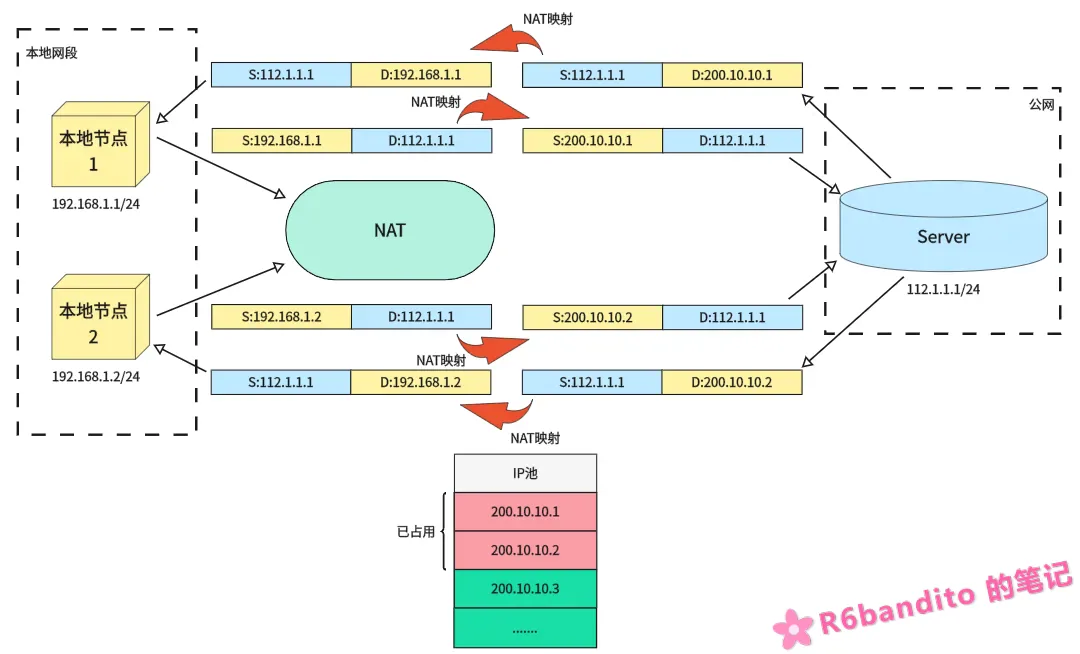
我们有两个本地设备分别为 192.168.1.1/24 与 192.168.1.2/24 需要上网,在静态NAT的规则下,节点1发送出的数据包(S:192.168.1.1/D:112.1.1.1) 经过网关NAT映射后,永久绑定了一个公网IP:200.10.10.1。Server侧收到的是200.10.10.1发来的数据包,当Server要向节点1回复时,是向200.10.10.1这个地址发送数据而不是向192.168.1.1直接发(如果这么发就发到服务端侧自己的本地网段中其它设备去了,很明显错误)!

Server回复的数据经过NAT重映射之后,目标IP从200.10.10.1被网关修改为了192.168.1.1,随后数据被路由给节点1,正确接收。节点2的收发流程也是同理。

在本例中:200.10.10.1 与 200.10.10.2这两个公网IP将被节点1和节点2永久占用。

也就是说一个设备吃掉一个公网IP,这是极其浪费的一种行为。因此静态NAT模式通常用于服务器这些需要对外提供服务的设备(作为服务器必须保证地址稳定可连接)。


动态NAT

动态NAT维护有一个IP地址池,该池中是目前空闲可使用的公网IP。其本质就是:从地址池中进行动态分配,谁先上网就先优先分给谁使用,用完后释放。

动态NAT和静态NAT流程上有相似之处。上例中,我们IP池中原本有 200.10.10.1~x 个空闲公网IP,节点1与节点2都需要上网,因此200.10.10.1被分配给了节点1,200.10.10.2被分配给了节点2。

与静态NAT一样,动态NAT一个公网IP一次只能服务一台设备,因此池中前两个IP被占用,假如此时节点3上线需要进行通信,那么节点池会将空闲的200.10.10.3分配给节点3使用。当地址池被用尽后,只能等待被占用的公用IP被释放后,其他主机才能使用它访问公网。

对于动态NAT而言,其实并没有解决公网IP浪费问题,因为本质上依然是一台设备对应一个公网IP。动态NAT定位十分尴尬:它比静态NAT省一点,但没省到点子上;比NAPT差很多,却没有任何额外优势。在NAPT普及后,纯动态NAT已很少单独使用。


NAPT(端口地址转换)

NAPT技术也叫做端口多路复用,是目前应用最广泛的NAT技术,也是最需要仔细了解的技术。NAPT与静态NAT/动态NAT不同,能够真正做到一个公网IP同时使数十台设备同时上网。

其原理是:使用传输层端口号区分不同的内网主机和会话,所有内网设备共享一个(或少量)公网 IP,通过不同的源端口映射出站连接。

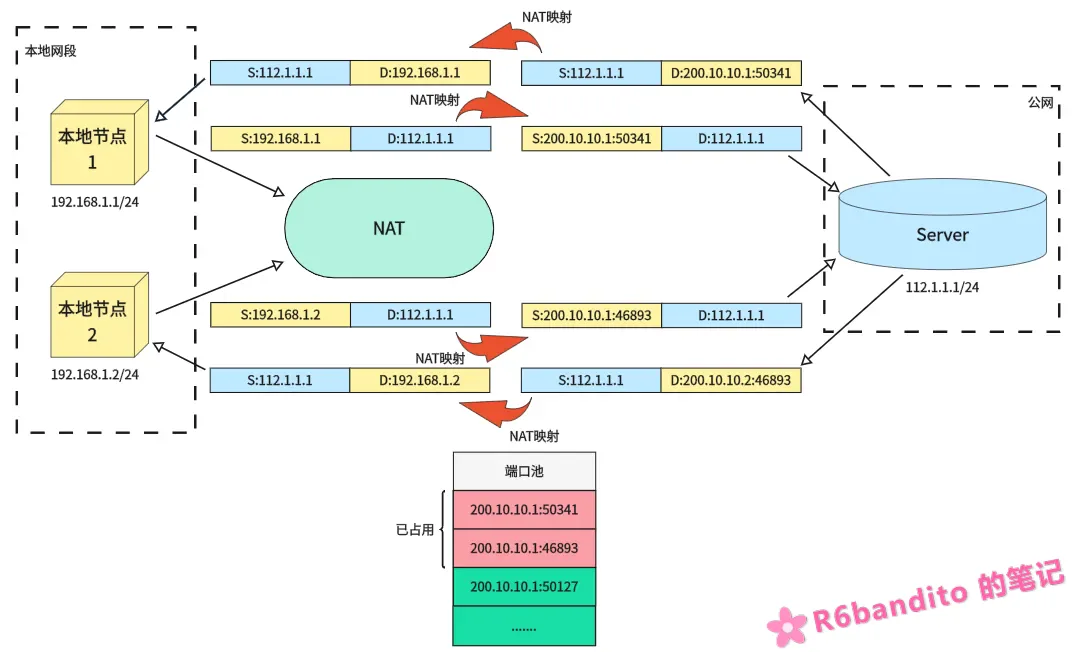
你比如两台本地设备分别被映射到了公网IP 200.10.10.1:50341 和 200.10.10.1:46893,两台设备使用的都是 200.10.10.1这个公网IP,但是流量被接入到了不同端口。若公网Server需要向其中一台设备通信,则只需要向 200.10.10.1:50341/46893 这两个端口发送数据即可。目的IP都是一样的,但是端口号为50341的流量会经NAT转换后被网关路由给设备1,端口号46893则路由给设备2。

具体见下图:

示例中,节点1与节点2分别被分到了公网IP200.10.10.1的50341与46893端口,这两个设备通过一个公网IP上网。当Server回复50341端口时,其数据包来到网关处,NAT查表得到50341映射为本地 192.168.1.1:x 的设备,随后NAT将包中的公网地址修改为本地的地址,交给网关路由到对应设备。整个流程下来Server向200.10.10.1:50341这个地址的回复数据包就被我们本地192.168.1.1:x正确接收到了。

节点2以及其它更多节点的通信都是同样的道理。


三种类型之间的简单对比

类型 映射关系 是否改端口 公网 IP 消耗 典型场景
静态 NAT 一对一,永久 否 1:1,最浪费 对外服务器
动态 NAT 多对多,动态 否 N:M,较浪费 企业内网
NAPT 多对一,动态 是 N:1,最省 家用路由器、手机热点
音乐
0:000:00