Linux 常用命令归档

前言

本篇文章用于记录一些Linux系统中的常用操作命令。Linux的命令系统是十分强大和复杂的,为了能够熟练进行系统操作,在这里归档一些常用命令以及常用参数,便于随时查看。如果需要更多更细节的一些操作命令,请自行查阅手册。


文件与目录操作命令

  • pwd:显示当前所处路径

    没有任何参数,单纯用来看自己当前处于什么位置。

    1
    2
    user:~/work$ pwd
    /home/Yukirin/work
  • cd:切换工作目录

    1
    2
    3
    4
    5
    6
    cd /home/user/project   # 进入绝对路径
    cd project # 进入相对路径
    cd .. # 返回上一级
    cd ../.. # 返回上两级
    cd ~ # 回到家目录(等价于 cd)
    cd - # 回到上一次所在目录

    这里要注意一下:cd - 不是进入上一级目录,而是类似于出栈撤回的操作。例如当前处于家目录,使用cd /user/project/subdir 跳转后,使用 cd - 回到的不是 /user/project,而是跳转之前的家目录。

  • ls:列出当前目录下内容

    1
    2
    3
    4
    5
    6
    7
    8
    9
    10
    11
    12
    ls                  # 简单列出
    ls -l # 长格式:权限、链接数、所有者、大小、时间、名字
    ls -a # 显示隐藏文件(以 . 开头)
    ls -h # 人类可读大小(配合 -l)
    ls -lh # 最常用组合
    ls -alh # 显示所有文件 + 长格式 + 易读大小
    ls -t # 按修改时间排序(新的在前)
    ls -r # 反向排序
    ls -S # 按大小排序(大的在前)
    ls -R # 递归列出子目录
    ls -d */ # 只列出目录本身,不展开内容
    ls -i # 显示 inode 号

    实际开发中,最常用的组合是 ls -alh ,能够应对90%的使用场景。在一些Linux的发行版(例如我这个Ubuntu 26.04)会将该命令重定义为 ll,敲命令时直接使用ll更方便。

    1
    2
    3
    4
    5
    6
    7
    8
    9
    10
    11
    Yukirin@DESKTOP-8BFBE1K:~$ ll
    total 76
    -rw------- 1 Yukirin Yukirin 5426 Sep 25 16:51 .bash_history
    -rw-r--r-- 1 Yukirin Yukirin 220 Sep 18 18:54 .bash_logout
    ....

    Yukirin@DESKTOP-8BFBE1K:~$ ls -alh
    total 76K
    -rw------- 1 Yukirin Yukirin 5.3K Sep 25 16:51 .bash_history
    -rw-r--r-- 1 Yukirin Yukirin 220 Sep 18 18:54 .bash_logout
    ....

    可使用type命令检查是否有绑定,如果没有,自己绑定一个就可以了。

    1
    2
    Yukirin@DESKTOP-8BFBE1K:~$ type ll
    ll is aliased to `ls -alF'

    我这里定义为 -alF ,给文件名加了类型标记。你也可以自己组合参数进行定义。

    这里讲讲关于 ls -alh 打印出来的各项的含义

    1
    2
    3
    4
    5
    6
    7
    8
    9
    -rw-rw-r--  1  Yukirin Yukirin  153  Sep 26 15:52  file1.txt
    │ │ │ │ │ │ │
    │ │ │ │ │ │ └─ 文件名
    │ │ │ │ │ └─ 最近一次修改时间
    │ │ │ │ └─ 大小(字节)
    │ │ │ └─ 所属组
    │ │ └─ 所有者
    │ └─ 硬链接计数
    └─ 权限
  • tree:树状图显示目录结构

    1
    2
    3
    4
    5
    6
    tree                # 递归显示
    tree -L 1 # 只显示 1 层
    tree -L 2 # 显示 2 层
    tree -d # 只显示目录
    tree -a # 显示隐藏文件
    tree -h # 显示大小

    tree命令可能并没有自带,如果使用tree提示找不到该命令,那么使用下列命令进行安装

    1
    sudo apt install tree

    tree命令效果如下,在查看文件和目录时还是很方便的。

    1
    2
    3
    4
    5
    6
    7
    8
    9
    10
    11
    Yukirin@DESKTOP-8BFBE1K:~$ tree
    .
    ├── C_Test
    │   └── new.c
    ├── Untitled
    ├── WSL-Neovim排查记录.md
    ├── snap
    │   └── glow
    │   ├── 90
    │   ├── common
    │   └── current -> 90
  • mkdir:目录创建

    1
    2
    3
    4
    mkdir test                  # 创建单个目录
    mkdir dir1 dir2 dir3 # 创建多个目录
    mkdir -p a/b/c # 递归创建多级目录
    mkdir -m 755 test # 创建时指定权限

    这里讲一下:父目录不存在,递归创建时必须带上 -p 参数。直接使用 mkdir dir1/dir2/dir3 是创建不了的

    1
    2
    3
    4
    5
    6
    7
    8
    Yukirin@DESKTOP-8BFBE1K:~$ mkdir dir1/dir2/dir3
    mkdir: No such file or directory

    Yukirin@DESKTOP-8BFBE1K:~$ mkdir -p dir1/dir2/dir3
    Yukirin@DESKTOP-8BFBE1K:~$ tree
    ├── dir1
    │   └── dir2
    │   └── dir3

    关于创建时指定权限:这里的 755 是八进制权限码,每一位对应一类用户的使用权限。

    7-5-5 三位分别代表:

    位置 对应对象 英文
    第 1 位 文件所有者 user (u)
    第 2 位 所属组 group (g)
    第 3 位 其他人 others (o)

    3位数字的各自计算方法:

    数字 权限 含义
    0 --- 无权限
    1 --x 只可执行
    2 -w- 只可写
    3 -wx 可写+执行
    4 r-- 只可读
    5 r-x 可读+执行
    6 rw- 可读+可写
    7 rwx 全部权限

    所以755在这里表示:

    1
    2
    3
    7        5        5
    rwx r-x r-x
    所有者 组 其他人

    需要时直接查表算就行了。其实mkdir在指定权限时也支持符号写法:

    1
    2
    mkdir -m u=rwx,g=rx,o=rx test    # 等价于 755
    mkdir -m a=rwx test # a=所有人,等价于 777

    这些写法都是等价的,符号写法规律很明显,不用查表算数字,我比较喜欢这种方法;不过数字写法速度快,背下常规几种组合之后直接用就行。

  • rmdir:空目录删除

    1
    2
    rmdir test                  # 删除空目录
    rmdir -p a/b/c # 递归删除空目录(a/b/c 都为空时)

    这个命令只能删除空目录,若目录内部有文件将删除失败。删除带文件的目录应该用下文的rm -r 命令,rmdir不是很常用,了解一下。

  • touch:文件创建

    1
    2
    3
    4
    5
    6
    touch file.txt              # 创建空文件
    touch file1 file2 # 创建多个
    touch -c file.txt # 文件不存在时不创建
    touch -a file.txt # 只更新访问时间
    touch -m file.txt # 只更新修改时间
    touch -t 202609260830 file # 指定时间戳:YYYYMMDDhhmm

    这里讲一个有意思的点:touch原意其实并不是创建文件,touch的英文是触摸,原本设计的目的是修改文件的时间戳。不过当touch的目标文件不存在时,会先创建一个新文件。后续慢慢的就都使用该命令来创建文件了。

  • rm:删除文件或目录

    1
    2
    3
    4
    5
    6
    rm file.txt                 # 删除文件
    rm -i file.txt # 删除前询问
    rm -f file.txt # 强制删除,不询问
    rm -r dir # 递归删除目录
    rm -rf dir # 递归强制删除(危险!)
    rm -v file.txt # 显示删除过程
    1
    2
    3
    4
    5
    Yukirin@DESKTOP-8BFBE1K:~/work$ rm -i a.out
    rm: remove regular file 'a.out'? n
    Yukirin@DESKTOP-8BFBE1K:~/work$ ll
    total 36
    -rwxrwxr-x 1 Yukirin Yukirin 16608 Sep 25 16:41 a.out*

    这里要提醒一下:rm -rf / 是删除整个root跟目录的自杀式命令,永远不要执行。现在的发行版基本都会拒绝rm -rf /这个命令,但是最好自己在上层加入一些防误操作保护,不要依赖内部实现。

    -v参数会在终端打印删除了什么。如果需要知道具体删除了哪些文件,可以带上该参数。

    1
    2
    3
    Yukirin@DESKTOP-8BFBE1K:~/work$ rm -v -i a.out
    rm: remove regular file 'a.out'? y
    removed 'a.out'

    可以给rm命令加上别名,带上确认与反馈机制,防止误操作。

    1
    alias rm='rm -i'

    上面我们提到,rm -r 可以用于删除带文件的目录,日常使用删除目录的命令基本都是使用这个。

    这里关于 rm -rf 的使用要注意一下:rm -rfv dir1/dir2/dir3 执行这行命令之后只会删除dir3以及dir3的所有子级目录!而不是摘掉dir1/dir2/dir3整棵树,dir1/dir2 都还在。如果想要摘掉 dir1/dir2/dir3 整棵树应该使用 rm -rfv dir1。这个地方不弄清楚很容易用错。

    1
    2
    3
    4
    5
    6
    7
    8
    9
    10
    11
    12
    13
    14
    15
    16
    Yukirin@DESKTOP-8BFBE1K:~$ tree dir1/
    dir1/
    ├── dir2
    │   ├── dir3
    │   └── nana.lua
    └── lala.lua

    2 directories, 3 files
    Yukirin@DESKTOP-8BFBE1K:~$ rm -rfv dir1/
    removed 'dir1/dir2/nana.lua'
    removed 'dir1/dir2/dir3'
    removed directory 'dir1/dir2'
    removed 'dir1/lala.lua'
    removed directory 'dir1/'
    Yukirin@DESKTOP-8BFBE1K:~$ find dir1
    find: ‘dir1’: No such file or directory
  • cp:复制文件和目录

    1
    2
    3
    4
    5
    6
    7
    8
    cp file1 file2              # 复制文件
    cp file1 dir/ # 复制到目录
    cp -r dir1 dir2 # 递归复制目录
    cp -a dir1 dir2 # 归档复制,保留权限、时间、链接
    cp -p file1 file2 # 保留权限和时间
    cp -i file1 file2 # 覆盖前询问
    cp -u file1 file2 # 仅当源更新时才复制
    cp -v file1 file2 # 显示过程
    1
    2
    3
    4
    Yukirin@DESKTOP-8BFBE1K:~/dir1$ cp -vp /home/Yukirin/work/tcp_client.c ../dir1/
    '/home/Yukirin/work/tcp_client.c' -> '../dir1/tcp_client.c'
    Yukirin@DESKTOP-8BFBE1K:~/dir1$ ls /home/Yukirin/dir1/
    dir2 tcp_client.c

    -i参数可以在即将发生覆盖行为时提醒用户。cp默认覆盖是静默无声的,某些情况下可能会导致误冲刷重要文件,所以建议使用别名将 cp -i 封装起来使用。

    Ps:-r 只做递归复制,属性和链接等等不做保留、而 -a 不仅可以递归复制,同时还保留权限、所有者、时间戳、符号链接、硬链接、扩展属性等,尽量做到一模一样。你可以这么理解:-r 只管内容一样,-a 则是原封不动整个文件包括属性一起打包带走。所以做备份时首选 -a 。

    1
    2
    3
    Yukirin@DESKTOP-8BFBE1K:~/dir1$ cp -iv tcp_client.c tcp_back.c
    cp: overwrite 'tcp_back.c'? y
    'tcp_client.c' -> 'tcp_back.c'
  • mv:移动文件/重命名

    1
    2
    3
    4
    5
    6
    7
    mv file1 file2              # 重命名
    mv file1 dir/ # 移动到目录
    mv dir1 dir2 # 重命名目录
    mv -i file1 file2 # 覆盖前询问
    mv -f file1 file2 # 强制覆盖
    mv -v file1 file2 # 显示过程
    mv -u file1 file2 # 仅当源更新时才移动

    mv的用法和参数与cp是一样的。cp是复制,mv是剪切,知道这个就好。

  • file:查看文件类型

    1
    2
    3
    file file.txt               # 文本文件
    file image.png # PNG 图片
    file /bin/ls # ELF 可执行文件

    例如:

    1
    2
    Yukirin@DESKTOP-8BFBE1K:~/dir1$ file tcp_back.c
    tcp_back.c: C source, ASCII text
  • stat:查看文件详细数据

    1
    stat file.txt

    能够看到文件大小、权限、访问时间、修改时间等等。

    1
    2
    3
    4
    5
    6
    7
    8
    9
    Yukirin@DESKTOP-8BFBE1K:~/dir1$ stat tcp_back.c
    File: tcp_back.c
    size: 1739 Blocks: 8 IO Block: 4096 regular file
    Device: 8,48 Inode: 79667 Links: 1
    Access: (0664/-rw-rw-r--) Uid: ( 1000/ Yukirin) Gid: ( 1000/ Yukirin)
    Access: 2026-09-26 14:11:45.248891782 +0800
    Modify: 2026-09-26 12:02:43.217786645 +0800
    Change: 2026-09-26 12:02:43.217786645 +0800
    Birth: 2026-09-26 12:01:09.162633570 +0800
  • ln:创建链接

    1
    2
    3
    4
    5
    ln file1 file2              # 硬链接
    ln -s file1 file2 # 软链接(符号链接)
    ln -sf file1 file2 # 强制创建软链接,覆盖已有
    ln -si file1 file2 # 覆盖前询问
    ln -sv file1 file2 # 显示过程

    创建链接分为硬链接和软链接。使用 ln 命令默认创建硬链接;使用 ln -s 创建软连接。

    软链接有点类似Windows桌面的快捷方式,是一个独立的小文件,其内容是指向目标的路径。软连接有自己的inode,如果软连接指向的目标被删除,那么访问软连接时会报:No such file or directory 错误。这是符合常理的,我们在Windows中若快捷方式失活(通常是指向的源文件已被删除),访问也是会报找不到文件错误的。

    硬链接inode是相同的,举个例子:假如原件为 source1,使用 ln 命令为其创建硬链接 source2、 source3,那么source1、source2、source3的inode全都是相同的。这点区别于软链接,我们上面提到过,软链接是一个独立小文件,有自己的inode。

    由于共享inode,硬链接相当于是给原数据上了份保险:上面示例中我们删除掉source1,源数据并不会受损,而这个特性是软链接做不到的。

    这个特性你可以这么理解:我们删除数据时并不是从底层直接销毁数据,而是销毁其指向该部分内存的指针。我们创建了两个硬链接,就相当于多维护了两个指向该块数据的指针。当我们删除source1时,由于2和3仍指向该块数据,所以我们仍然能够获取这块内存,在上层体现出来的就是未被删掉。只有当我们将1、2、3全部删除时,这块数据才是真正丢了,体现在上层就是数据被删除。这就是硬链接的一个特定和优势。

    这里要注意硬链接的两个限制:

    • 不能跨文件系统(因为 inode 只在同一文件系统内唯一)
    • 不能对目录创建硬链接

    软链接没有这个限制。

    上文一直在提到 inode,这里讲讲 inode 是怎么回事:inode全称为 index node(索引节点),是Unix文件系统用来描述一个文件的数据结构。你可以把它理解为一个结构体,内部是所指文件的元数据——例如权限、文件大小、所有者、所属组、链接计数等。其内部还维护有指向文件数据块的指针。

    总的来说 inode = 描述数据的元数据结构体 + 指向数据块的索引。


文件查看

  • cat:打印输出整个文件

    1
    2
    3
    4
    5
    6
    7
    8
    cat file.txt                # 输出全部内容
    cat -n file.txt # 显示行号(所有行)
    cat -b file.txt # 显示行号(跳过空行)
    cat -s file.txt # 连续空行压缩为一行
    cat -A file.txt # 显示不可见字符($ 表示行尾,^I 表示 Tab)
    cat file1 file2 # 拼接多个文件输出
    cat file1 file2 > merged # 合并写入新文件
    cat > file.txt # 从键盘输入,Ctrl+D 结束

    我们这里有如下两个示例文件

    1
    2
    3
    4
    5
    6
    7
    8
    9
    file1.txt
    The quick brown fox jumps over the lazy dog.
    This sentence contains every letter of the alphabet.
    It is often used for typing practice and font testing.

    file2.txt
    Linux 的 cat 命令全称是 concatenate,意思是连接。
    它最常见的用途是查看文件内容,也可以把多个文件拼在一起。
    配合重定向符号,还能快速创建或追加文件。

    使用 cat file1 file2 拼接输出可以得到:

    1
    2
    3
    4
    5
    6
    7
    Yukirin@DESKTOP-8BFBE1K:~/docTest$ cat file1.txt file2.txt
    The quick brown fox jumps over the lazy dog.
    This sentence contains every letter of the alphabet.
    It is often used for typing practice and font testing.
    Linux 的 cat 命令全称是 concatenate,意思是连接。
    它最常见的用途是查看文件内容,也可以把多个文件拼在一起。
    配合重定向符号,还能快速创建或追加文件。

    将拼接的输出创建为一个新文件 file3.txt

    1
    2
    3
    4
    5
    6
    7
    8
    Yukirin@DESKTOP-8BFBE1K:~/docTest$ cat file1.txt file2.txt > file3.txt
    Yukirin@DESKTOP-8BFBE1K:~/docTest$ cat file3.txt
    The quick brown fox jumps over the lazy dog.
    This sentence contains every letter of the alphabet.
    It is often used for typing practice and font testing.
    Linux 的 cat 命令全称是 concatenate,意思是连接。
    它最常见的用途是查看文件内容,也可以把多个文件拼在一起。
    配合重定向符号,还能快速创建或追加文件。

    使用 cat > 文件 命令可以创建一个新文件,并且文件内容为你在终端输入的内容。输入完毕后 Ctrl+D 落盘。

    一般小文件使用cat方便快速查看和编辑,对于大文件不要使用cat,会刷屏。如果不慎刷屏使用 Ctrl+C 强行终止本轮调用。

  • less:分页查看

    1
    2
    3
    4
    5
    less file.txt               # 打开文件
    less +F file.txt # 实时跟踪(类似 tail -f)
    less -N file.txt # 显示行号
    less -S file.txt # 不换行,超长行横向滚动
    less -i file.txt # 搜索时忽略大小写

    分页查看用于日常查看大文件,内部支持简单的文本搜索功能,可以当作是一个简易的记事本。

    进入分页模式后有如下几个常用命令:

    按键 功能
    空格 / PageDown 下一页
    b / PageUp 上一页
    g 跳到文件头
    G 跳到文件尾
    /pattern 向下搜索
    ?pattern 向上搜索
    n 下一个匹配
    N 上一个匹配
    q 退出
    F 进入实时跟踪模式(Ctrl+C 退出)

    注意:这里less的默认搜索是大小写敏感的,大小写输入错误是匹配不到的;如果不需要大小写敏感,可以使用less -I 打开文件。参数搜索栏支持基本的正则表达式,以下的形式都是可以的:

    1
    2
    3
    4
    /^Error          # 以 Error 开头的行
    /error$ # 以 error 结尾的行
    /foo.*bar # foo 后跟任意字符再到 bar
    /[0-9]\+ # 一个或多个数字(注意 + 号要转义)

    搜索特殊字符时要记得转义,例如搜索/本身要用:/\/。此处给一个文本中搜索IP地址的示例:

    1
    /[0-9]\+\.[0-9]\+\.[0-9]\+\.[0-9]\+
  • head:查看文件开头

    1
    2
    3
    4
    5
    head file.txt               # 默认前 10 行
    head -n 20 file.txt # 前 20 行
    head -n -5 file.txt # 除了最后 5 行,全部显示
    head -c 100 file.txt # 前 100 字节
    head -q file1 file2 # 多文件时不显示文件名

    使用演示示例如下(还是以上文 file1.txt file2.txt 为例):

    1
    2
    3
    4
    5
    6
    7
    8
    9
    10
    11
    12
    13
    14
    15
    16
    17
    18
    19
    20
    21
    22
    23
    24
    25
    26
    27
    28
    29
    30
    31
    32
    33
    34
    Yukirin@DESKTOP-8BFBE1K:~/docTest$ cat file1.txt
    The quick brown fox jumps over the lazy dog.
    This sentence contains every letter of the alphabet.
    It is often used for typing practice and font testing.

    Yukirin@DESKTOP-8BFBE1K:~/docTest$ head -n 1 file1.txt
    The quick brown fox jumps over the lazy dog.

    Yukirin@DESKTOP-8BFBE1K:~/docTest$ head -n -1 file1.txt
    The quick brown fox jumps over the lazy dog.
    This sentence contains every letter of the alphabet.

    Yukirin@DESKTOP-8BFBE1K:~/docTest$ head -c 30 file1.txt
    The quick brown fox jumps over

    Yukirin@DESKTOP-8BFBE1K:~/docTest$ head file1.txt file2.txt
    ==> file1.txt <==
    The quick brown fox jumps over the lazy dog.
    This sentence contains every letter of the alphabet.
    It is often used for typing practice and font testing.

    ==> file2.txt <==
    Linux 的 cat 命令全称是 concatenate,意思是连接。
    它最常见的用途是查看文件内容,也可以把多个文件拼在一起。
    配合重定向符号,还能快速创建或追加文件。

    Yukirin@DESKTOP-8BFBE1K:~/docTest$ head -n 2 file1.txt file2.txt
    ==> file1.txt <==
    The quick brown fox jumps over the lazy dog.
    This sentence contains every letter of the alphabet.

    ==> file2.txt <==
    Linux 的 cat 命令全称是 concatenate,意思是连接。
    它最常见的用途是查看文件内容,也可以把多个文件拼在一起。
  • tail:查看文件尾部

    1
    2
    3
    4
    5
    6
    7
    tail file.txt               # 默认后 10 行
    tail -n 20 file.txt # 后 20 行
    tail -n +5 file.txt # 从第 5 行开始,显示到末尾
    tail -c 100 file.txt # 后 100 字节
    tail -f log.txt # 实时跟踪新增内容(最常用!)
    tail -F log.txt # 跟踪文件,文件被删除重建后继续跟踪
    tail -f -n 100 log.txt # 先显示后 100 行,再实时跟踪

    该命令用法与head是一样的,此处不做过多阐述。这里讲讲什么叫实时跟踪:tail -f或 tail -F 可以启用实时跟踪功能。实时跟踪指的是,文件内容在增长时,终端自动跟随显示最新的追加内容。

    例如我们使用 tail -f log.txt 监控日志文件,该条命令被执行后终端立即被挂起。当应用程序产生新日志并且写入到 log.txt 中时,终端会立即显示出来。

    -f / -F 两个参数都是开启文件跟踪,区别在于-f跟踪的是文件描述符,当文件移走后(例如该文件日志已满,需要mv到别的地方,并在原地重新创建新日志文件),-f跟踪的是旧文件,看不到新文件。

    而-F跟踪的是文件名,所以旧文件移走并原地创建新文件后能够继续跟踪,而不会跟丢。日常看日志用 -f,如果日志会被轮转,移走重建,用 -F 更稳妥。

  • wc:统计文件行数、字数、字节数

    1
    2
    3
    4
    5
    6
    7
    wc file.txt                 # 输出:行数 单词数 字节数
    wc -l file.txt # 只统计行数(最常用)
    wc -w file.txt # 只统计单词数
    wc -c file.txt # 只统计字节数
    wc -m file.txt # 只统计字符数
    wc -L file.txt # 最长行的长度
    ls | wc -l # 统计当前目录文件数

    示例如下:

    1
    2
    Yukirin@DESKTOP-8BFBE1K:~/docTest$ wc file3.txt
    6 34 362 file3.txt

    输出从左至右分别为:该文件内容行数、单词数、总字节数。

    这里讲讲 wc -c 与 wc -m 的区别:-c统计的是字节,-m统计的是字符。在全英文文本的情况下,二者是等价的,但是对于中文或其它语言等多字节字符时就完全不同。举个例子:文件1内容为:“Hello,World”,通过wc -c 或 wc -m 统计出来都是 11 个字节/字符;文件2内容为:“你好世界”,由于中文字符为宽字符,UTF8中通常占3个字节,因此 wc -c 统计出来应为12个字节,wc -m 统计出来应为4个字符。这就是二者的差别。

    wc -m 的解析依赖当前的locale编码来判断一个字符是几个字节,如果locale没设置对那么 -m 计算出的字符数就是不准确的,这里要注意。

  • du:查看文件及目录的磁盘占用空间

    1
    2
    3
    4
    5
    6
    du file.txt                 # 文件占用(块单位)
    du -h file.txt # 人类可读(KB/MB/GB)
    du -sh dir/ # 目录总大小(最常用)
    du -sh * # 当前目录下每个文件/目录大小
    du -h --max-depth=1 # 只显示 1 层深度
    du -ah dir/ # 包含所有文件

    这里在使用时可能你会发现一个统计问题(还是以上述file1/2/3.txt为例):

    1
    2
    3
    4
    5
    6
    7
    8
    9
    10
    11
    12
    13
    Yukirin@DESKTOP-8BFBE1K:~/docTest$ ls -alh
    -rw-rw-r-- 1 Yukirin Yukirin 153 Sep 26 15:52 file1.txt
    -rw-rw-r-- 1 Yukirin Yukirin 209 Sep 26 15:52 file2.txt
    -rw-rw-r-- 1 Yukirin Yukirin 362 Sep 26 16:05 file3.txt

    Yukirin@DESKTOP-8BFBE1K:~/docTest$ du -sh *
    4.0K file1.txt
    4.0K file2.txt
    4.0K file3.txt

    Yukirin@DESKTOP-8BFBE1K:~/docTest$ cd ..
    Yukirin@DESKTOP-8BFBE1K:~$ du -sh docTest/
    16K docTest/

    发现了吗?我们文件大小为 153/209/362,通过磁盘占用统计出来竟然是4Kb?这里要强调一下:du的占用统计是从磁盘的角度来计算的,而磁盘是由簇和扇区构成的,簇是整个文件系统最小的分配单位,而簇又由多个扇区构成。目前我们的几个文件都只有几百字节,大小是很小的,但是依然需要占用一个簇和其中一个扇区,所以统计出来才为4Kb。这也侧面说明我们当前这个系统的文件系统最小扇区为4.0Kb。

  • df:查看磁盘分区使用情况

    1
    2
    3
    4
    df -h                       # 人类可读(最常用)
    df -h /home # 只看指定挂载点
    df -i # 查看 inode 使用情况
    df -T # 显示文件系统类型

    这里要分清 du/df 的区别:du是针对单个文件以及目录进行磁盘占用统计,而df是从宏观上针对整个磁盘进行统计。

  • hexdump:十六进制查看

    1
    2
    3
    hexdump -C file.bin         # 标准十六进制 + ASCII(最常用)
    hexdump -C -n 64 file.bin # 只看前 64 字节
    hexdump -C -s 128 file.bin # 从偏移 128 开始

    这是Linux用来以16进制查看文件的原生工具,在平时分析一些协议时也很常用。默认情况下每行输出16字节,半字分组。最左侧是偏移量,中间是数据内容:

    1
    2
    3
    4
    5
    Yukirin@DESKTOP-8BFBE1K:~/docTest$ hexdump file3.txt
    0000000 6854 2065 7571 6369 206b 7262 776f 206e
    0000010 6f66 2078 756a 706d 2073 766f 7265 7420
    0000020 6568 6c20 7a61 2079 6f64 2e67 540a 6968
    ....

    不过这种方式不太直观,可以使用 hexdump -C 将其拆成标准16进制格式。

    1
    2
    3
    4
    Yukirin@DESKTOP-8BFBE1K:~/docTest$ hexdump -C file3.txt
    00000000 54 68 65 20 71 75 69 63 6b 20 62 72 6f 77 6e 20 |The quick brown |
    00000010 66 6f 78 20 6a 75 6d 70 73 20 6f 76 65 72 20 74 |fox jumps over t|
    00000020 68 65 20 6c 61 7a 79 20 64 6f 67 2e 0a 54 68 69 |he lazy dog..Thi|
    1
    2
    3
    4
    5
    6
    00000000  54 68 65 20 71 75 69 63  6b 20 62 72 ...         |Hello World.|
    │ │ │ │
    │ │ │ └─ ASCII 显示
    │ │ └─ 后8个字节
    │ └─ 前8个字节
    └─ 偏移量(十六进制!)

    不过hexdump不只可以看16进制,也可以其它进制的方式进行查看。其命令参数如下所示:

    选项 作用
    -C 规范 hex + ASCII
    -b 每字节显示为八进制
    -c 每字节显示为字符(转义形式)
    -d 每字节显示为十进制
    -o 每字节显示为八进制(两位)
    -x 每字节显示为十六进制
    -n N 只显示前 N 字节
    -s N 跳过前 N 字节再显示
    -v 不省略重复行(默认连续相同行会显示 *)
  • xxd:十六进制查看

    1
    2
    3
    4
    xxd file.bin                # 十六进制 + ASCII
    xxd -l 64 file.bin # 前 64 字节
    xxd -s 128 file.bin # 从偏移 128 开始
    xxd -r hex.txt > file.bin # 反向:十六进制文本还原为二进制

    这个命令与上面的hexdump是高度重合的。区别在于,hexdump是系统原装的,而xxd是vim编辑器的附件工具包。如果你没有装Vim的话可能没有这个工具。xxd有反色显示,我个人比较喜欢xxd的观感,所以常用xxd。

    xxd还有个hexdump做不到的特性,那就是能够进行反向还原:将16进制重新还原回2进制。

    1
    2
    xxd file.bin > dump.txt        # 导出为文本
    xxd -r dump.txt > back.bin # 从文本还原为二进制

    hexdump没有这个功能,所以在做二进制<->文本转换时使用xxd。

  • grep:文本搜索

    1
    2
    3
    4
    5
    6
    7
    8
    9
    10
    11
    12
    13
    grep "error" log.txt            # 搜索包含 error 的行
    grep -i "error" log.txt # 忽略大小写
    grep -n "error" log.txt # 显示行号
    grep -v "error" log.txt # 反向:不包含 error 的行
    grep -c "error" log.txt # 统计匹配行数
    grep -r "error" dir/ # 递归搜索目录
    grep -rn "error" dir/ # 递归 + 行号
    grep -w "error" log.txt # 只匹配整词
    grep -A 3 "error" log.txt # 显示匹配行及后 3 行
    grep -B 3 "error" log.txt # 显示匹配行及前 3 行
    grep -C 3 "error" log.txt # 前后各 3 行
    grep -E "err|warn" log.txt # 扩展正则(或)
    grep -l "error" *.txt # 只显示匹配的文件名

    grep是Linux中最常用的搜索工具。使用场景十分广泛,例如我要在某个文件或某几个文件中找内容:

    1
    2
    grep "error" app.log
    grep -n "TODO" *.c # -n 显示行号

    再或者配合管道,从输出中过滤出需要的内容:

    1
    2
    3
    ps aux | grep nginx         # 找 nginx 进程
    ls -alh | grep ".txt" # 只看 txt 文件
    df -h | grep "/dev/sda" # 只看某个磁盘

    grep还有个很强大的地方是支持基本正则表达式(BRE)和拓展正则表达式(ERE),如果会用正则的话那么grep将非常高效和强大:

    1
    2
    3
    4
    5
    grep "^Error" app.log          # 以 Error 开头
    grep "done$" app.log # 以 done 结尾
    grep -E "error|fail|warn" app.log # 匹配多个词之一
    grep -E "[0-9]{3}-[0-9]{4}" file # 电话格式
    grep "colou\?r" file # 注意 ? 号转义
查找与定位

LazyVim C开发环境智能补全问题

现象及原因

环境: WSL2 + Ubuntu(26.04)。在环境中装好LazyVim插件后,发现编辑器的智能补全功能并不完善,C头文件以及相关函数不能够在补全菜单中显示。经查,是我系统虽然安装了clangd等前置,但LazyVim并不会直接使用系统里安装的工具,而是通过Mason包管理工具来链接外部工具。具体来说:LazyVim的默认策略是不直接启用这类语言服务器,而是把启用工作交给Mason系的组件;而Mason系只认自己安装的服务器。我的clangd是apt装在系统里的,Mason管理的指定位置里并没有它——两头都不认,所以尽管系统已经正确安装clangd,却谁都没有把它启用起来,该功能也就失效了。

解决方法

  • 首先应该确保在系统中正确安装开发环境:
1
2
3
gcc --version
make --version
ld --version

并补一条真实编译测试:

1
2
printf '#include <stdio.h>\nint main(void){return 0;}\n' > /tmp/t.c \
&& gcc /tmp/t.c -o /tmp/t.bin && /tmp/t.bin && echo "编译链 OK"

确保基础编译工具链已被正确安装,若未安装请使用以下命令装前置:

1
2
sudo apt update
sudo apt install -y build-essential
  • 使用下列命令确保系统已安装clangd

    1
    sudo apt install clangd

    这里简单讲讲什么是clangd:clangd本质是一个常驻的C/C++语义分析引擎服务,由LLVM开发,是编辑器实现智能补全的核心。在我们使用编辑器对源文件进行编辑时,clangd会在后台实时解析你的代码——做的事情和编译器的前半程一样(展开头文件与宏、构建语法树),但不产出可执行文件,而是通过这个过程获取你当前的代码结构。当你输入部分关键字(例如str)时,clangd会收集当前光标所处作用域内的所有可见符号(局部变量、参数、函数名,以及#include引入的声明),按前缀过滤后返回给编辑器。这也是为什么你在光标处输入str后,补全菜单会自动跳出 strcmp、strcpy等等符号。

  • 前置全部正确安装之后,使用新增一个nvim的clangd.lua配置文件 ~/.config/nvim/lua/plugins/clangd.lua 。在新创建的文件中将下列代码复制进去:

    1
    2
    3
    4
    5
    6
    7
    8
    9
    10
    return {
    {
    "neovim/nvim-lspconfig",
    opts = {
    servers = {
    clangd = { mason = false },
    },
    },
    },
    }

    这段代码的含义是告诉LazyVim:clangd这个语言服务器不走Mason管理,直接使用本机系统已经装好的clangd。

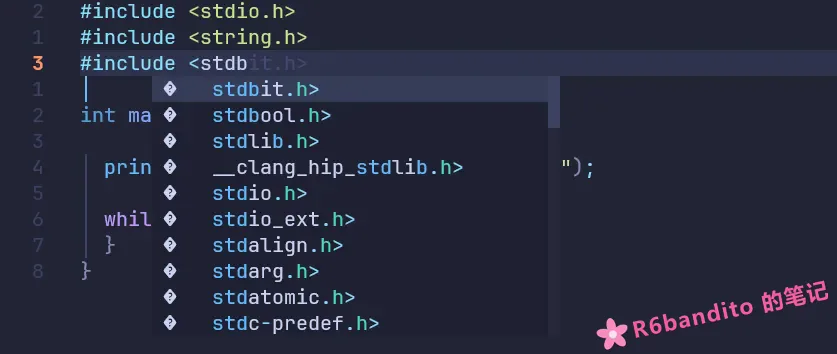
  • 用LazyVim打开一个源文件,可见自动补全已经正常运行(也可以用:LspInfo查看clangd是否处于attached状态):


关于智能补全

这里简单来聊聊LazyVim的智能补全机制,究竟是怎么做到智能补全的。首先得清楚:LazyVim本质上不是编辑器,而是针对Neovim打造的一套个性化配置。我们在使用编辑器时,用的是Neovim,而各种个性化以及智能化配置是由LazyVim配置而来的。

Neovim内置了LSP客户端,LSP是语言服务器协议,用于编辑器与语义分析服务(比如我们的clangd)之间的桥梁。其整个智能补全的简单工作流程如下:

  • 我们在编辑器中输入s-t-r三个字符,LSP会向clangd服务发送一条JSON信息,这条信息中包含文件路径和当前光标位置。注意,这里并不包含我们输入的内容——clangd会自己从文件内容里读取光标前的文本,提取出我们正在输入的词。
  • clangd收到信息后,定位到当前光标位置,并且收集所有可见的相关符号,过滤后返回给LSP。LSP收到后返回给上层服务进行综合排序,排序完毕后通过菜单呈现出来。这就是我们看到的智能补全菜单了。

一些嵌入式笔面试问题收录

前言

本偏文章主要用于记录一些自己平时看到的觉得不错的笔面试题目,虽然偏八股但是仔细研究一下还是能从里面学到不少门道的。长期随缘更新,题目顺序不固定,目前先线性往下慢慢写吧。文章可能难免会有缺陷,若您发现问题还望通过邮箱及时与我联系,帮助我及时改正,不胜感激。


主目录

typdef int* INT_PTR; 和 #define INT_PTR int* 在声明多个变量时有什么不同?

这个题目有点意思,这里要清楚 #define 是宏替换,而 typedef 是类型重映射,这是二者的本质区别。看下面这个示例:

1
2
3
4
5
6
7
8
9
typedef int* INT_PTR;
#define INT_PPTR int*

void
test( void )
{
INT_PTR a,b; // a b 均为 INT_PTR 类型.
INT_PPTR c,d; // c 为 int*,d为int.
}

在IDE中写出上述示例,你查看变量类型会发现 a,b 均为 INT_PTR 类型;而 c 为 int* 类型,d 为 int 类型,二者很明显是有区别的。原因在于:在 #define 宏定义情况下,INT_PPTR c,d;被展开为了 int* c,d;,编译器将其理解为一个 int* c 变量和一个 d 变量(C语言中,声明变量若未显示指明类型则默认为 int 型)。因此才会出现c,d类型不一致的情况。

而在类型重映射情况下,INT_PTR a,b; 被编译器解释为了 INT_PTR a, INT_PTR b; 即 int* a, int* b;,因此二者都是同一个类型。


什么是整数提升?unsigned char a = 0xFF; if( a == ~0x00 )这个条件成立吗?

首先,这个条件肯定是永远不会成立的。

这里涉及到C语言中一个类型运算规则:在C语言中,只要是参与运算的参数类型小于int,那么会先将该类型提升到int或uint再参与运算。而~0x00经过按位取反后,得到的结果应为0xFFFFFFFF,同时a经过提升变为0x000000FF参与比较,0x000000FF 很显然不等于 0xFFFFFFFF。因此这个条件永远是false。


0x01 << 3 + 1 结果是多少?为什么?

嗯,很经典的一个问题,也很简单,考的是运算符优先级的问题。这里加法运算优先级高于位移优先级,因此实际等价于 0x01 << (3 + 1) = 0x01 << 4 = 16 。关于运算符优先级我这里不详细给出,只是强调一下:在实际运用中,如果不是很确定运算的优先级,那么请统一加括号,不要怕难看。哪怕是写成 return (...(0x01 << (3 + 1))...) 这样都没有问题,因为计算是明确的。


定义一个结构,同一块内存访问能够存放4个字节数组,也能够作为32位整数访问,同时还支持按位访问。

很明显,同一块内存在不同情况下要搭建不同的内存模型,我们需要用到union联合体结构。

union联合体是一种C语言构造类型,所有成员共享同一块内存空间,其大小等于最大成员的大小,用于在同一内存中存储不同类型的数据以节省空间。这题相关结构定义如下所示:

1
2
3
4
5
6
7
8
9
10
11
12
typedef union {
uint8_t array[4];
uint32_t var;
struct {
uint32_t bit0 : 1;
uint32_t bit1 : 1;
uint32_t bit2 : 1;
...
uint32_t bit30: 1;
uint32_t bit31: 1;
} bits;
} MyStructure;

这里强调一下:位域这个结构可以详细了解下理论,但是少用。原因在于位域移植性很糟糕,在不同的字节序主机上同一套代码是完全不同的逻辑。因此在进行位操作时请使用相关操作符,而不是使用位域。


字符串反转(不借助新数组,原地反转一个字符串)
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
void 
reverse_string( char *str )
{
if ( !str || strlen(str) < 2 ) return;

char *start = str;
char *end = str + strlen(str) - 1;

while( start < end )
{
char temp = *start;
*start = *end;
*end = temp;

start++;
end--;
}
}

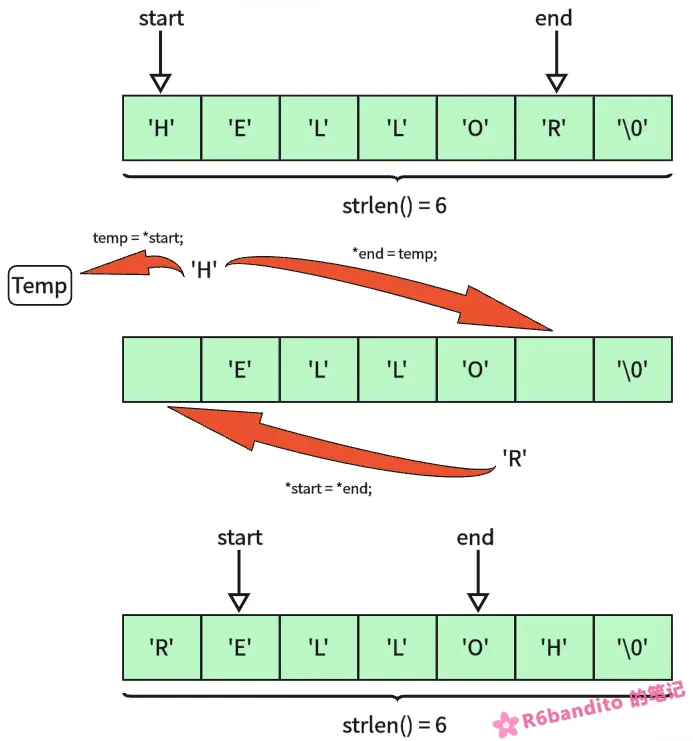
这里不做过多讲解,直接给一轮流程图:


模拟实现 strcpy 与 memcpy

my_strcpy:

1
2
3
4
5
6
7
8
9
10
11
void 
my_strcpy( char *dest, const char *src )
{
if ( !dest || !src )
return;

while( *src != '\0' )
*dest++ = *src++;

*dest = '\0';
}

my_memcpy:

1
2
3
4
5
6
7
8
9
10
11
void 
my_memcpy( void *dest, const void *src, size_t n )
{
if ( !dest || !src || n == 0 )
return;

uint8_t *d = (uint8_t *)dest;
const uint8_t *s = (const uint8_t *)src;
while( n-- )
*d++ = *s++;
}

都是很简单的手写题,有个思路就行,不做过多讲解。


冒泡排序

这里先简单讲讲冒泡排序的原理:

首先我们现在手上有一个待排无序数组arr[5, 1, 7, 3, 2, 4]。我们可以先在这6个数中,每两个数之间进行比较排序,将较大的数往后排。即:

  1. 5和1比较:(5>1) ? 结果为True,5和1交换一次,原数组变为 arr[1, 5, 7, 3, 2, 4].
  2. 再拿5和7比较:(5>7)? 结果为false,5和7不交换,数组保持不变.
  3. 7和3比较:(7>3)? 结果为True,7和3交换一次,数组变为 arr[1, 5, 3, 7, 2, 4].
  4. 7和2比较:(7>2)? 结果为True,7和2交换一次,数组变为 arr[1, 5, 3, 2, 7, 4].
  5. 7和4比较:(7>4)? 结果为True,7和4交换一次,数组变为 arr[1, 5, 3, 2, 4, 7].

可以看到我们进行了5次比较,成功将整个序列中最大的数放到了最后。以上整个流程我们称之为一轮排序。既然经过一轮能选出一个最大的,那么我们下次排序剔除掉排好的这个,是不是又可以选出一个次最大的数据出来?最后,我们整个数组序列有6个元素,我们通过5轮排序,就能够将整个数组按从小到大的顺序进行序列化了。这就是冒泡排序的原理。以下是冒泡排序的参考程序实现:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
void 
bubble_sort( int *arr, int len )
{
if ( !arr || len < 2 )
return;

/* 外层循环:排序轮数. */
for( uint8_t i = 0; i < len - 1; i++ )
{
uint8_t isSwapped = 0;
/* 内层循环:每轮需要的比较次数. */
for( uint8_t j = 0; j < len - 1 - i; j++ )
{
if ( arr[j] > arr[j + 1] )
{
int temp = arr[j];
arr[j] = arr[j + 1];
arr[j + 1] = temp;
isSwapped = 1;
}
}

if ( !isSwapped )
break;
}
}

这里讲一下 isSwapped 这个标志位:这是个优化标志位,当我们给出的数组本来就是有序数组,或经过某轮排序后整体已经变为有序序列时,就没必要继续往下进行了。该标志位在数组已经有序后,其在下一轮的遍历流程中不会被置1(数组已经有序,不会再进行任何交换操作),此时检测到该标志位没有置1后,直接提前退出就可以了。

Ps:这里循环变量用的是u8,有溢出风险。此处只做演示说明,实际使用时根据具体情况来决定其类型。


一些位操作相关逻辑

位操作算是嵌入式基本功了,此处给出一些位操作相关逻辑:

1
2
3
4
5
6
7
8
9
10
11
/* 将 reg 的第 x 位置1. */
#define SET_BIT(reg, x) ((reg) |= (0x01u << (x)))

/* 将 reg 的第 x 位清0. */
#define CLEAR_BIT(reg, x) ((reg) &= (~(0x01u << (x))))

/* 读取 reg 的第 x 位. */
#define GET_BIT(reg, x) (((reg) >> (x)) & 0x01u)

/* 翻转 reg 的第 x 位. */
#define TOGGLE_BIT(reg, x) ((reg) ^= (0x01u << (x)))

“统计一个字节里面有多少个1” 这是一道非常经典的笔试题目,一个很简单的位移使用,我曾今也碰到过:

1
2
3
4
5
6
7
8
9
10
11
12
uint8_t 
count_ones( uint8_t data )
{
uint8_t count = 0;
for( uint8_t i = 0; i < 8; i++ )
{
if ( (data & (0x01 << i)) )
count++;
}

return count;
}

这是我曾经的写法,不能说是错的,但是还有一种更巧妙的写法:

1
2
3
4
5
6
7
8
9
10
11
12
uint8_t 
count_ones( uint8_t data )
{
uint8_t count = 0;
while( data > 0 )
{
data &= (data - 1);
count++;
}

return count;
}

怎么样?不管data是什么数,data & (data - 1) 总能够把data最低位的一个1去丢。

例如data = 0b1101 1010、data - 1 = 0b1101 1001 。data & (data - 1) = 0b1101 1000 看到没?经过一次操作将其最低的一个1去掉了,此时count=1。继续while循环直到data = 0,刚好把5个1全部去掉,count=5,这不就统计出来了吗? 这个方法比较巧妙,后续求一个数是否是2的幂等数时,也会用到类似的思想。


单链表反转

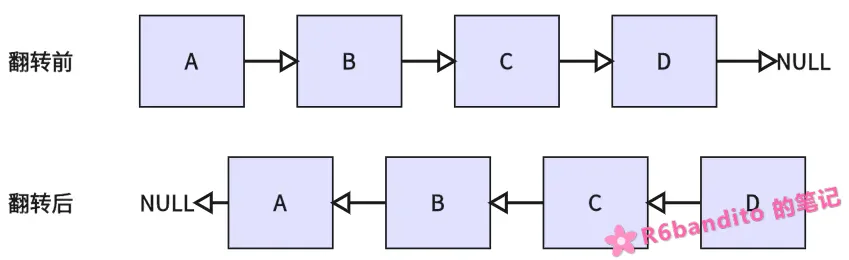
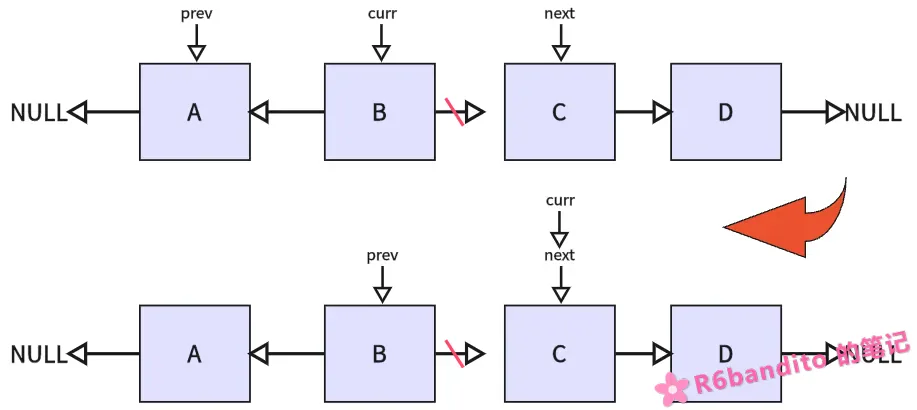
单链表反转也是个比较经典的考点,这里用文字叙述有些不易理解,所以先以下图进行一个情景带入:

翻转前链表的头节点为A,我们要求链表翻转后D为头节点,A为尾节点。这里我们采用三指针法进行翻转:

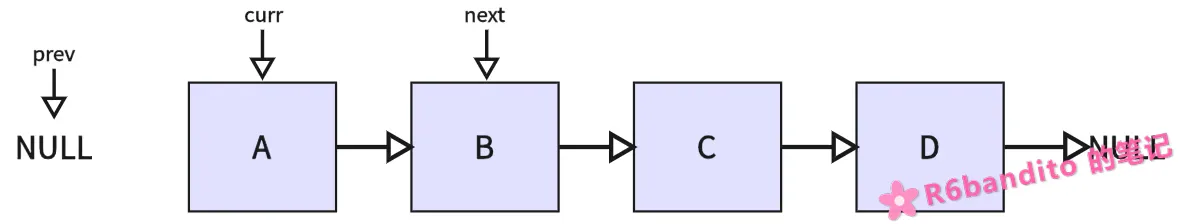
  • 定义三个指针 curr、next、prev。初始状态下,curr指向当前头节点,next与prev初始化为NULL。
  • 将next指向curr->next。也就是用next记住当前curr节点的下一个节点,防止翻转curr后丢掉后继节点。
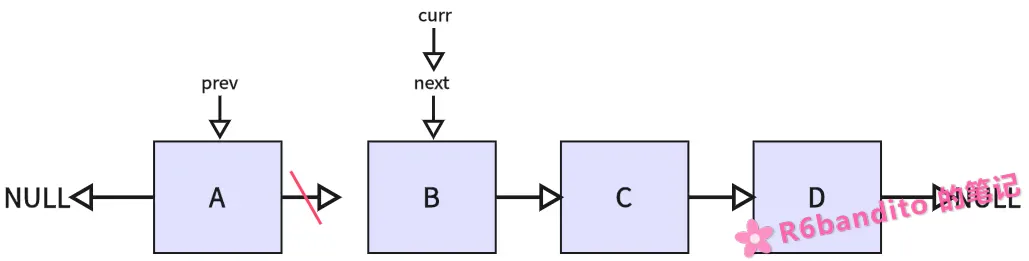
  • 将curr当前节点翻转指向prev,并且同步更新prev和curr。
  • 重复上述操作,将next指向curr的next,然后对curr指向节点进行翻转,并同步更新curr与prev。
  • 一直循环该翻转操作,直到最后一个节点D也成功翻转,变为头节点。

下列是三指针法进行单链表翻转的参考示例:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
typedef struct Node Node;
struct Node {
uint8_t data;
Node *next;
};

Node *
list_reverse( Node *head )
{
if ( !head ) return NULL;

Node *curr = head;
Node *next = NULL;
Node *prev = NULL;

while( curr != NULL )
{
next = curr->next;
curr->next = prev;
prev = curr;
curr = next;
}

return prev;
}

数组单次遍历找最大值和次大值

数组找最值并不复杂,核心点在于一次循环必须找出最大和次大值。这里我们的思路是在给定数组的前两个元素中,先找出暂定最大值,剩下一个作为暂定次大值。后续从数组的第三个元素开始向后遍历,若找到一个比当前最大值还要大的元素,则更新当前最大值,同时用旧的最大值来更新次大值;若找到一个大于当前次大值,却又小于最大值的元素,则只更新次大值。一轮循环过后成功拿到最大、次大值。

程序示例如下:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
void 
find_max_sec( int *arr, int len, int *Omax, int *Osec )
{
if ( !arr || len < 2 )
return;

/* 先在前两个元素中暂定最大值与次大值. */
int max = arr[0];
int sec = arr[1];
if ( max < sec )
{
int temp = max;
max = sec;
sec = temp;
}

/* 从第三个元素开始遍历. */
for( uint32_t i = 2; i < len; i++ )
{
/* 找到比当前最大值还大的元素. 更新最大值与次大值. */
if ( arr[i] > max )
{
sec = max;
max = arr[i];
}
else if ( (arr[i] > sec) && (arr[i] != max) )
{
/* 找到大于次大值且小于最大值的元素. 仅更新次大值. */
sec = arr[i];
}
}

/* 一轮遍历结束. 根据参数进行结果输出. */
if ( Omax ) *Omax = max;
if ( Osec ) *Osec = sec;
}

判断一个数是不是2的幂

判断一个数是否是2的幂等数,你可能会想:直接对2循环取余判断是否为0不就完了吗?这有啥难的?确实,不过我们这里要讲的是通过位操作来判断2的幂等数。通过位操作进行判断是一个经典的笔试题,同时也有确切的应用场景。你比如在环形缓冲区中我们进行优化时就会用到该方法(详见:环形缓冲区)

1
2
3
4
5
int 
is_power_of_two( uint32_t data )
{
return ((data > 0) && (data & (data - 1)) == 0);
}

这里简单讲讲为什么2的幂等数能够使用 data & (data - 1) == 0 来判断:因为2的幂等数在2进制中只有一个1,例如64(0b0100 0000)、128(0b1000 0000) 。这些数减去1后会把那个1变成0,而把剩下的0变成1。比如 128 - 1 = 127(0b0111 1111),这样两个一做与运算data & (data - 1) = 0b1000 0000 & 0b0111 1111 = 0 结果不就是0吗?

一条 data & (data - 1) 位运算在底层看来就是单纯一条指令,仅需一个时钟周期。而如果你采用循环取余的方式,由于底层没有专门的除法电路,其除法器通常是通过反复的减法、移位、试商等微码循环来实现的。这就意味着一条除法指令往往需要花费数十个时钟周期,还要涉及循环开销。这个性能帐我相信谁都能算明白。


#define SQUARE(x) x*x,那么 SQUARE(2+3) 等于多少?

这是个很典型的带参宏定义陷阱题。我们首先需要清楚宏定义的本质:在预处理阶段进行文本替换。也就是说你丢在括号里面的这一个表达式会原封不动的通过宏定义进行文本更换。

1
2
3
#define SQUARE(x)   x*x

SQUARE(2+3) -(宏定义展开)-> 2+3*2+3.

发现问题了吗?我们原意是计算5*5 = 25,结果宏定义展开后由于运算符优先级的作用,导致计算式变为了 2+6+3 = 11 ,这就是带参宏定义很容易出现的问题。所以在进行宏定义时,入参必须写成如下形式:

1
#define SQUARE(x)   ((x)*(x))

通过括号来保证运算有一个确定的优先级,而不受运算符优先级的影响。


大小端字节序判断

字节序判断这个已经无需多言了,相信只要看过笔试整理相关文章的100%都能遇到。这里简单讲讲什么是大小端字节序并给出两种判断方法。

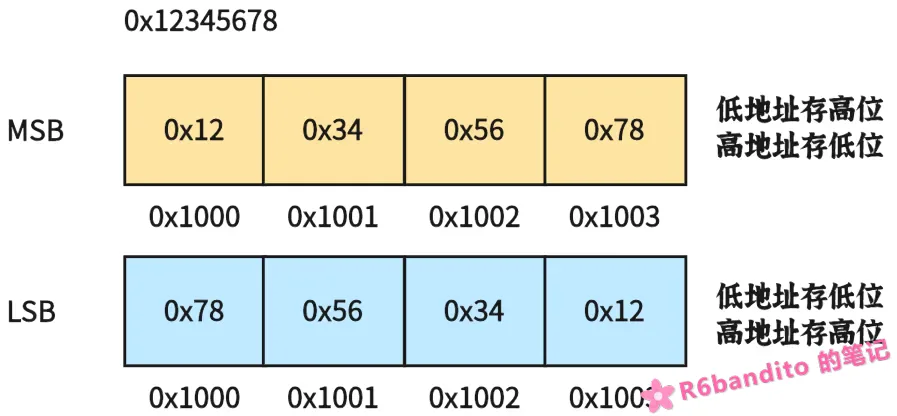
大端字节序(MSB):多字节数据的高位字节存放在内存的低地址,低位字节存放在内存的高地址。例如 0x12345678这个32位数据存储在 0x1000 ~ 0x1003 这四个字节的位置。那么在MSB字节序下 0x1000 存的就是 0x12(高位字节),对应的 0x1003存的就是 0x78(低位字节)。

小端字节序(LSB):多字节数据在内存中低地址存放低位字节,高地址存放高位字节的存储方式(低地址存低位,高地址存高位)。还是以上述 0x12345678 为例,在LSB字节序下面 0x1000 存的是 0x78(低位字节),对应的 0x1003存的是 0x12(高位字节)。

二者的内存布局如下图所示:

以下给出两种方法来判断当前环境字节序:

  • 通过联合体(union)进行判断,这也是最为常见的一个方法。
1
2
3
4
5
6
7
8
9
10
11
12
union {
uint32_t data;
uint8_t array[4];
} uio;

int
check_endian( void )
{
uio.data = 0x12345678ul;
/* 返回 1 为MSB字节序;返回 0 为LSB字节序. */
return ((uio.array[0] == 0x12) ? 1 : 0);
}
  • 通过指针强转进行判断。
1
2
3
4
5
6
7
int 
check_endian( void )
{
uint32_t i = 1;
/* 返回 1 为MSB字节序;返回 0 为LSB字节序. */
return (((*(uint8_t *)&i) == 0) ? 1 : 0);
}

我们所使用的 ARM Cortex-M 架构就是典型的LSB字节序,而网络字节序是典型的MSB字节序。


I2C为什么需要上拉电阻?一般阻值为多大比较合适?

首先从I2C的架构方面来入手,I2C可以用来进行多主多从组网,在多主机情况下,I2C总线上谁控制住时钟SCL谁就是本次通信的主机。I2C总线有线与仲裁机制,所以就算多个主机同时进行通信,最终在仲裁机制下只会有一个设备得以成功与从机建立通信。而在这仲裁期间,假如我们使用推挽输出,那么当一个设备输出高电平1,另一个设备接地输出低电平0时,那么在总线上就会出现一个从 VCC 直接短路到 GND 的回路,这回产生一个瞬时大电流很容易会导致GPIO口被烧毁。

因此在I2C上我们必须使用开漏输出,这意味着高电平无法输出到总线,那么这个时候就需要一个显式的外部上拉来完成总线电平输出高这个动作,这就是为什么需要外部上拉电阻。

这个上拉电阻的阻值在 3.3V 系统中,我们通常采用4.7kΩ比较合适。这个上拉电阻的阻值不能过大,也不能太小

  • 阻值过大的话由于RC电路特性,上升沿会变缓。若通信速率比较高的话很容易会出现在SCL还没充到高电平,SDA就可能已经被下拉到0了,导致通信误码、ACK丢失等问题。
  • 阻值过小上升沿陡峭,适合较高速率的通信。但是同时总线上电流比较大,器件功耗大发热大,甚至如果电流超过了I2C器件的承载值的话可能会烧器件。

I2C时钟拉伸

正常情况下,I2C总线的时钟SCL是由主机控制的,但在某些情况下,由于主机通信速率过快从机处理不过来,部分从机会主动抓住SCL时钟线(从机拉低SCL),让主机无法继续产生时钟脉冲。从机处理完毕后再松开SCL,将SCL控制权交还给主机,继续进行接下来的通信。

从机主动拽住SCL时钟线的这个机制就叫作I2C的时钟拉伸机制。

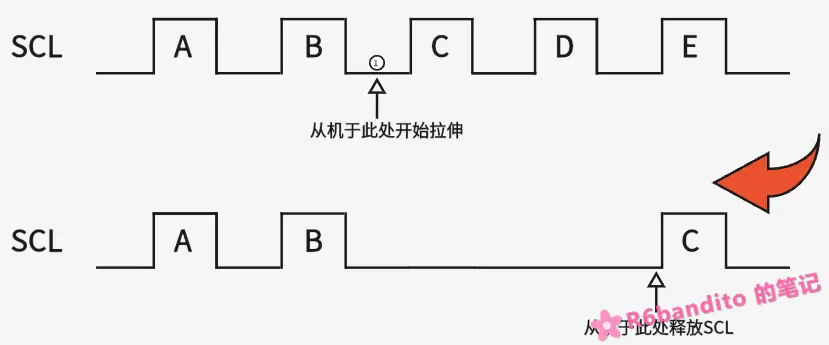
这里以一个具体的时序例子来看看时钟拉伸:

正常情况下,主机将依次发出A、B、C、D、E五个脉冲,在脉冲高电平期间,SDA数据线被锁存,从机在高电平期间读取SDA数据线上的数据,这正是I2C总线的主机向从机写数据行为。

但是在①处,由于从机需要执行一些耗时操作(例如从机内部E2PROM写入行为),因此必须拽住SCL时钟,防止主机继续发送导致数据丢失、通信失败。

主机在经过B、C之间的数据建立时间后,主动释放时钟线想要让SCL被上拉到高电平进行数据采样。但是释放后主机发现SCL并没有按照预期升到高电平,于是推测目前有从机正在进行时钟拉伸动作,于是主机便等待并定时轮询SCL状态。

等到从机释放SCL后,后续通信流程正常进行。上述就是一次I2C时钟拉伸的流程。

这里我再强调下I2C时钟拉伸的时机:时钟拉伸是发生在SCL低电平期间的!也就是时钟拉伸发生的同时主机也是在拉低SCL的。从机不能够在SCL高电平期间拉低SCL!因为I2C中高电平是采样时间,如果从机提前拉低SCL会产生一个下降沿,相当于新产生了一个时钟边沿,破坏了主机时钟的完整性,会导致后续通信出问题!


中断服务函数注意事项

中断ISR是硬实时上下文,阻塞中断会导致整个系统挂起,因此我们在编写ISR时要做到快、短、安全、可重入。

  • 中断内部不要调用延时或阻塞相关的API,会严重破坏系统实时性。
  • 中断内部不要调用不可重入API,标准C的malloc就是个典型例子,malloc是非线程安全的,假如主循环中某处malloc调用被ISR中断了,而在ISR中又调用malloc,很容易会导致堆结构损坏。
  • 对于一些需要在中断中修改,主程序判断使用的全局变量,请加上volatile。因为编译器在编译主循环代码时是感知不到ISR的,因此在某些极端条件下会过度优化导致程序逻辑出错。加上volatile禁止编译器进行重排和缓存。
  • 记得及时清除中断标志,正确做法是进入ISR后应首先清除标志再进行逻辑,否则可能会因为某些路径提前退出ISR或忘记清除标志导致无限ISR风暴。
  • 注意栈空间。ISR上下文使用的是MSP主栈指针,是会累积压栈的。什么叫累积压栈?举个例子:
    当你从main中调用 funcA(),内部再调用funcB()时,你的调用栈是这样的:main->funcA()->funcB()。
    这一整个调用链上的每个函数的内核通用寄存器以及栈局部数据结构都是压在MSP上的(裸机示例),此时funcB()被ISR中断,ISR的整个栈是直接接着MSP中的funcB()继续往后压的。如果你的栈已经在前续调用中被使用得差不多了,此时ISR压上来很可能会栈溢出。这是个比较隐蔽的问题,要注意。
  • 中断中不要进行复杂的逻辑处理和运算。这一点可以和第一点归于一类,都违反了中断的快、短准则,会影响系统实时性。要利用好中断下半段处理,将耗时操作挪到中断后半段去(例如FreeRTOS,在PendSV中进行任务切换,这其实也是利用了中段下半部分的处理机制)。

I2C 死锁

ARP 地址解析协议

前言

ARP全称为 Address Resolution Protocol 即地址解析协议。我们已经知道,IP网络中有IP地址这一概念。但是需要明白,在以太网环境中,数据帧在以太网上传输靠的是MAC地址,而IP只是逻辑地址负责逐跳传输。数据帧在传输过程中,不仅需要填上IP,还需要填上MAC地址才能正确在网络环境中路由。

那么在这个流程下,就会出现这样一个问题:我们知道对端的IP地址,但是不知道MAC地址,IP层在组帧的时候没有MAC组不了,自然这帧数据就无法通过网卡被发送出去。为了解决这个问题,我们就引入了ARP协议。

ARP协议的本质其实就是:通过IP逻辑地址来解析出设备的物理MAC地址。


ARP协议简介

了解ARP,首先得弄清楚其所处的位置。在通常情况下,我们可以认为ARP位于TCP/IP四层经典模型(详见OSI七层模型与TCP/IP四层经典模型)的网络层,与IP协议并列。

当我们在局域网中进行通信时,拿到的是目标主机的IP地址,但是IP只是逻辑地址,下层在通信时使用的是MAC地址。因此为了保证下一跳能够跳转到正确地址,IP层就会通过ARP协议获得对端的正确MAC地址,进而填入数据包发给下层去路由。

这里要提前说明一下:ARP协议只适用于同一网段,若两台设备位于不同网段,则不能够直接进行交互,需要交由网关进行代劳。


ARP报文格式

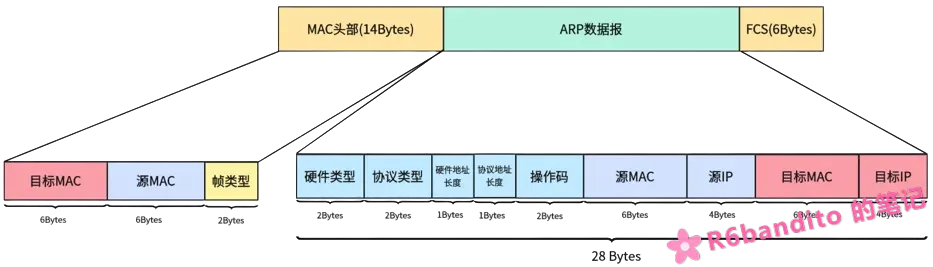
ARP报文格式如下图所示

(勘误:图中FCS校验部分实际应为4字节,图中笔误写成了6字节,下同)

报文中各数据区含义定义如下:

字段 长度 说明
硬件类型 2 字节 以太网为 1
协议类型 2 字节 IPv4 为 0x0800
硬件地址长度 1 字节 MAC 地址长度,6
协议地址长度 1 字节 IP 地址长度,4
操作码 2 字节 1=请求,2=应答
发送方 MAC 6 字节 请求方的 MAC
发送方 IP 4 字节 请求方的 IP
目标 MAC 6 字节 请求时填 0,应答时填对方 MAC
目标 IP 4 字节 要解析的目标 IP

这里要注意一下,IP协议与ARP协议是并列的,所以ARP协议的报文直接封装在以太网帧中,而不是像ICMP一样封装在IP数据报中。

以太网帧头部的帧类型:0x0800 为IP数据包;0x0806 为ARP数据包。在ARP通信中均为0x0806表示该包数据包为ARP包,请协议栈按照ARP的格式进行解析和应答。

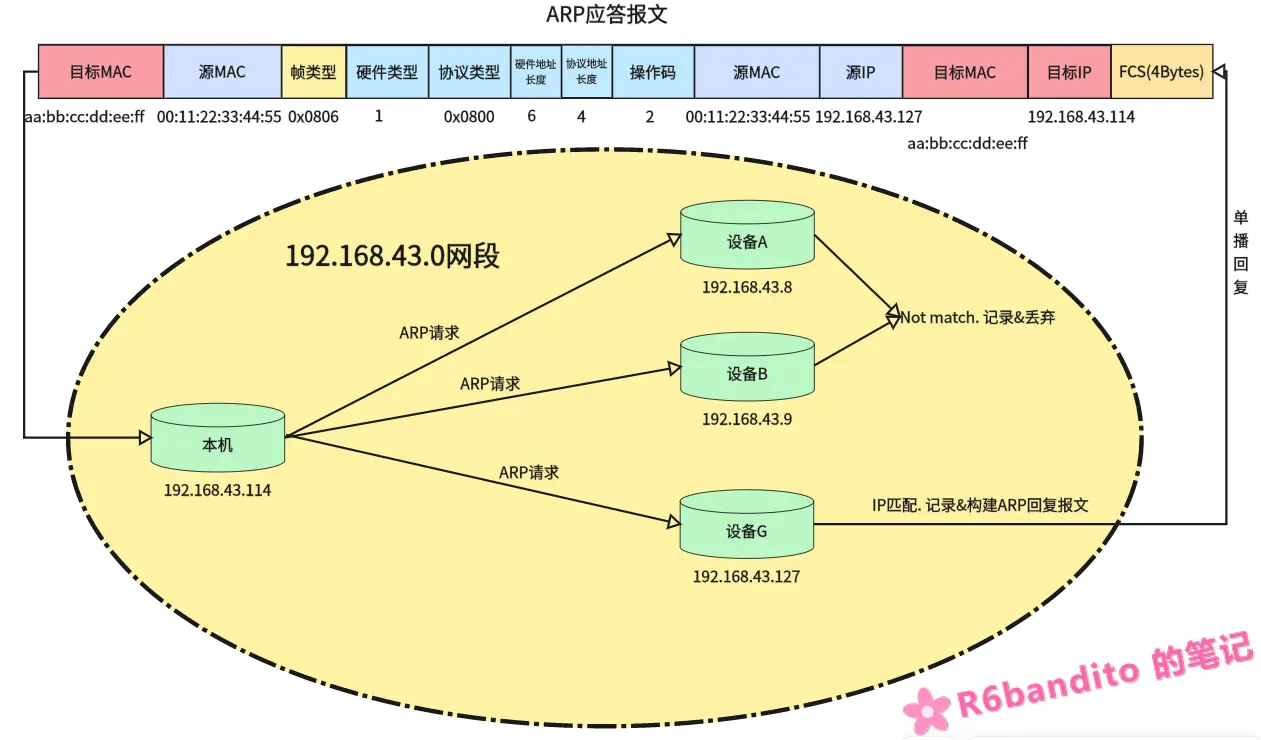
在以太网帧头中有一个目标MAC地址,在ARP数据报中也有一个目标MAC地址,这两个地址是不一样的,注意区分!在ARP请求时,以太网帧的目标MAC会填充为FF:FF:FF:FF:FF:FF,即广播地址。而ARP数据报中的目标MAC以0做占位;ARP回复时ARP应答数据报中的源MAC会被替换为所查询IP设备的物理MAC。这里先提前了解下,后续在讲述ARP流程时会详细阐述。


ARP工作流程

这里先引入一个情景:我们处于 192.168.43.0 网段,设备本机IP为 192.168.43.114,MAC地址为 aa:bb:cc:dd:ee:ff。在该网段中也存在一台设备G,其IP地址为 192.168.43.127,MAC地址为 00:11:22:33:44:55。

当我们要向设备G发送一段UDP数据报时,其流程如下:

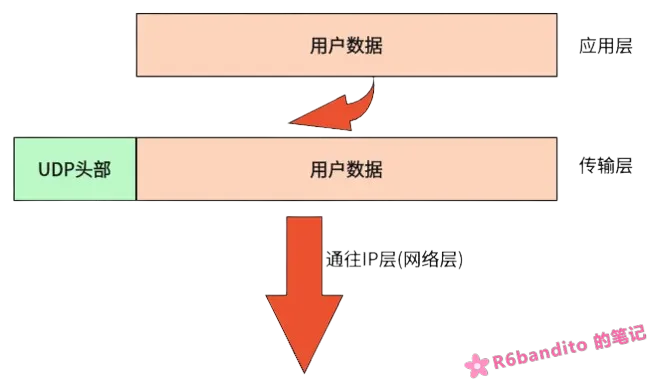
  • 待发数据在传输层打上UDP头部,派发到网络层。
  • UDP报文进入IP层后,IP在对其进行封装IP数据包时发现对端MAC地址未知,暂时挂起发送请求,并请求一次ARP响应。此时,ARP流程正式开始。

协议栈构建一帧ARP报文,将自己的MAC和IP填入到“源MAC”与“源IP”中,并将目标IP填入。对于目标MAC,用0占位。随后将以太网帧头部的MAC硬编码为 FF:FF:FF:FF:FF:FF 广播地址,通过网卡发送出去。具体如下图:

为什么ARP请求要发广播地址?

我们发起ARP请求目的是查询指定IP的MAC地址,因此必须发广播保证该网段下所有设备都能够收到,否则就失去了查询的意义。这里需要注意的是,这个广播只是本地网段广播,不会也不应该被网关转发。

  • 该网段中所有设备都收到该ARP请求帧,并判断自身是否是被请求IP。如果不是,则记录下发送方的IP和MAC后丢弃该包(这里涉及ARP学习,于下文展开);如果自身就是被请求IP,则记录发送方后构建ARP应答包回复。

如上图所示,设备A、B收到ARP请求后,发现请求IP并非自己,于是记录发送方后丢弃;设备G收到ARP请求后,发现请求的IP正是自己,于是将请求方的MAC和IP记录下来,同时自身构建一帧ARP应答报文(操作码为2),并正确填入双方信息后单播回我们本机。

  • 本机接收到ARP应答包,交给协议栈ARP处理分支进行处理,将目标设备的MAC从数据报中提取出来放入ARP缓存表。
  • 现在我们本机已经有了目标IP设备的物理MAC地址,解挂之前的UDP数据报,正式封装发送。

以上就是一个常规的ARP查询流程。


ARP缓存表

当然,如果每发一次数据都要ARP广播找一次设备,那效率就太低了。为了解决这个问题,我们可以很自然的想到将对方的MAC永久记录下来,这样下次直接查表就可以了。但是这又引入了另一个问题:如果表项固定,那么意味着我们每和一台设备通信,就会在内存中记录下该设备。在真正的网络环境中,拓扑往往是比较复杂的,这就意味着我们设备需要花费大量内存空间来存储每一个通信设备的MAC表项。而且设备在网络环境中MAC是可以被修改的,假如同一台设备MAC变了,那按照原表去查到的是旧MAC,那么发送出去的数据包直接就丢在网络环境中了。种种这些都是要解决的问题。

针对这种情况,协议提供了ARP缓存表这一结构。接下来我将以LwIP的实现为例进行阐述。

表项结构

ARP缓存表结构本质上是一个C结构体,以下是LwIP中ARP缓存表结构:

1
2
3
4
5
6
7
8
9
10
struct etharp_entry {
#if ARP_QUEUEING
struct etharp_q_entry *q; /* 挂起的待发数据包队列 */
#endif
ip4_addr_t ipaddr; /* 目标 IP 地址 */
struct netif *netif; /* 从哪个网卡可以到达目标 */
struct eth_addr ethaddr; /* 目标 MAC 地址 */
u16_t ctime; /* 存活时间,用于老化 */
u8_t state; /* 表项状态 */
};

通常,ARP缓存表一个表项的结构应当包含如下字段:

  • IP地址(ipaddr):该条表项对应的是哪个IP的MAC映射?
  • MAC地址(ethaddr):表项的核心,表示该IP设备对应的MAC地址。
  • 类型:ARP缓存表分为静态类型和动态类型,该字段用于指明该条表项的来源(手动静态配置的/学习到的)。
  • 表项老化时间(ctime):表项清扫时间。这里要明白,内存就那么多(尤其是在嵌入式系统中),我们不可能让大量表项常驻在内存中,必须定时对旧的不活跃的连接进行清扫,释放内存。而清扫动作的根据就是表项老化时间。
  • 网络接口(netif):记录该表项对应的对端设备通过哪个网卡可以到达。

这里你会发现LwIP的实现中并没有类型(type)字段,却多了一个state字段。其实LwIP内部是维护了一个状态机的,而“类型”作为其中一个状态被融合进了里面。关于LwIP的ARP状态机,本篇文章不展开说明。


动态表项与表项老化

缓存表分为了动态表项和静态表项,动态表项一个最大的特征就是具备表项老化的机制。

缓存表老化本质上就是:给每条ARP表项设定了一个生命周期,该周期通过每次通信进行重置。当该生命周期超时后将会被降级重新验证或删除以释放空间。

缓存表老化是维护系统稳健性的一个关键举措:在网络环境中MAC和IP是可能发生变化的(比如更换网卡/IP给另一台设备),而且每个设备自身的内存空间都是有限的。如果表项一直不老化,那么表项越积越多,新旧混杂,占用空间越来越大,将导致内存枯竭或网络帧错误路由。

缓存表老化流程:

  • 当我们通过ARP广播与一台设备建联时,此时ARP缓存表中该表项被正式建立并可用。此时协议栈内部会启动一个定时器记录从此刻开始的老化时间。
  • 在这个老化时间计数期间,若双方再次发生通信,则老化时间被重置(这是符合预期的,表示对端活跃在线,自然要重置老化时间),重新进行计数;若在此期间未发生通信,则定时器继续计数。
  • 若老化定时器超时,则该条表项将从就绪状态(STABLE)被撤下,转为待验证状态(状态改为STABLE_REREQUESTING)。此时,LwIP协议栈会立即广播一个ARP请求等待对方应答。若重复几次对方都无应答,则立即删除该表项并释放内存。

这里要说明一点:上述流程我们是采用LwIP的视角来叙述其行为的,然而在Linux这些现代系统中,其行为略有差异。在Linux中,老化定时器超时后表项状态将由 REACHABLE 变为 STALE,此时Linux并不会像LwIP一样广播ARP,而是继续维护STALE状态,并维护一个stale超时时间,当stale再次超时时该表项将会被删除。在STALE期间,若仍有数据需要发送,内核不会挂起数据等待验证结果,而是先把数据照常发出,同时启动一个短暂的验证窗口(详见下文)。

更重要的一点是:Linux 在验证机制上比 LwIP 更机智——STALE 表项并不会被周期性地主动保活,只有当它再次被使用(也就是恰好有数据要发往这个目标设备)时,内核才会启动验证流程,而且验证的第一步甚至不需要发 ARP:

  1. 状态先由 STALE 转为 DELAY,数据包照常发出;内核在默认 5 秒的窗口内等待”上层反馈”;
  2. 若窗口内上层协议给出了可达性确认(典型如 TCP 收到了对方的 ACK),内核直接认定该表项仍然 REACHABLE——一个 ARP 包都不需要发;
  3. 若窗口内没有任何确认,状态转为 PROBE,此时内核才主动发出单播ARP请求去探测对端,收到正确应答后恢复为 REACHABLE;连续探测失败则标记为不可达并最终回收。

这里还有一个容易忽略的细节:UDP流量触发验证时,必然走到第 3 步。因为 UDP 天生没有确认机制,5 秒窗口内不可能等到”上层反馈”,所以内核只能老老实实发 ARP 探测。

而 STALE 条目本身的回收是在 GC 周期中完成的:一段时间内没有被使用过的条目会被直接删除;若近期被使用过,则只会刷新其时间戳,使其继续存活。下面这条抓包记录就是一次 PROBE 探测的过程:

1
2
3
17:18:09.143971 00:15:5d:e6:af:b7 > 00:15:5d:e6:fc:69, ethertype ARP (0x0806), length 42: Request who-has 172.18.224.1 tell 172.18.228.235, length 28

17:18:09.144126 00:15:5d:e6:fc:69 > 00:15:5d:e6:af:b7, ethertype ARP (0x0806), length 42: Reply 172.18.224.1 is-at 00:15:5d:e6:fc:69, length 28

可以看到,该记录正是一次 PROBE 探测:内核为验证该表项是否仍然有效,主动向 172.18.224.1 发出了一个单播 ARP 请求,对方也正确回复了 ARP 应答,此后该条目恢复为 REACHABLE。相比 LwIP 过期广播重问的做法,Linux 这种策略更节省局域网带宽。

下面再来看一次完整的实测。实验里我们清空ARP表后先 ping 一次网关把表项建立起来,随后不再做任何操作,静置等待表项自然老化。期间系统后台进行了一次NTP校时(一次典型的UDP流量),恰好触发了上面这套验证流程:

1
2
3
4
5
6
7
8
9
10
11
12
13
// 抓包视角(时间戳为与上一行的间隔)
+18.236899 172.18.228.235.35583 > 185.125.190.122.123: NTPv4, Client, length 188
// NTP 请求发出(此时表项为 STALE,转发时随即转入 DELAY)
+0.189621 185.125.190.122.123 > 172.18.228.235.35583: NTPv4, Server, length 188
// NTP 应答到达(UDP 无确认机制,DELAY 窗口不会因此提前结束)
+4.823691 00:15:5d:e6:fc:69 > 00:15:5d:e6:af:b7, ethertype ARP: Request who-has 172.18.228.235
// 网关也向我们发了一个 ARP 请求(网关侧行为,与本机验证流程无关)
+0.000015 00:15:5d:e6:af:b7 > 00:15:5d:e6:fc:69, ethertype ARP: Reply
// 我们回复网关
+0.117068 00:15:5d:e6:af:b7 > 00:15:5d:e6:fc:69, ethertype ARP: Request who-has 172.18.224.1
// DELAY 窗口超时转入 PROBE,向网关发出单播 ARP 请求
+0.000158 00:15:5d:e6:fc:69 > 00:15:5d:e6:af:b7, ethertype ARP: Reply
// 网关回复,探测完成
1
2
3
4
// 状态视角(ip neigh show 逐秒采样)
19:35:44 172.18.224.1 dev eth0 lladdr 00:15:5d:e6:fc:69 STALE
19:35:47 172.18.224.1 dev eth0 lladdr 00:15:5d:e6:fc:69 DELAY // NTP 请求触发验证
19:35:52 172.18.224.1 dev eth0 lladdr 00:15:5d:e6:fc:69 REACHABLE // 探测成功,恢复就绪

可以看到,从NTP请求发出到单播ARP出现,前后恰好间隔约 5 秒,状态机完整走了一圈 STALE → DELAY → PROBE → REACHABLE。这里还有一个特别容易误判的点:由于 5 秒后 PROBE 一发即中,PROBE 状态只存在极短的一瞬间,逐秒采样时甚至完全看不到它。如果只看结果,很容易产生”内核在 STALE 很久之后突然自己发 ARP 保活”的错觉——实际上触发它的,往往只是后台一个不起眼的周期性UDP流量(如NTP、SSDP等),并不是内核在主动保活。

当ARP缓存表已满,但是又需要插入新表项时,会优先淘汰需要验证(也就是已经超时待验证的)表项。若所有表项均处于就绪状态时,则按LRU规则,以ctime老化时间为根据淘汰最旧的动态表项。


静态表项

动态表项的设计固然好,但是仍有部分尴尬的问题用动态表项处理起来并不方便:

  • 某些情况下我们的服务器、固定的上位机等这些设备的IP-MAC映射是不会轻易改变的,如果网段中设备每次与他们通信都从走一遍 “发现/验证” 流程的话,将会占用网络带宽,降低通信效率。
  • 有的设备可能处于安全考虑并不响应ARP(防火墙),或者设备裁切了一个十分精简的TCP/IP协议栈,甚至没有ARP处理逻辑。此时根本无法使用动态表逻辑建立有效的连接表项。

在这种情况下,我们就需要引入静态表项来解决问题。静态表项没有老化机制,由用户手段配置之后其内存永久生效。

LwIP中,关于静态表项的实现是采用了一个 ETHARP_STATE_STATIC 状态融入进表项的state字段来实现的。在协议栈内核表项老化处理逻辑中,会优先判断该条目状态是否为 ETHARP_STATE_STATIC ,如果是则直接跳过该条表项的老化检查逻辑(静态表项不允许老化)。其实现类似于下列伪代码:

1
2
3
4
5
6
7
8
9
10
11
void lwip_arp_timeoutLogic( void )
{
....
for( 遍历所有表项 )
{
if ( arp_table[x].state == ETHARP_STATE_STATIC )
continue; // 静态表项. 直接跳过老化逻辑.

....后续老化判断逻辑.
}
}

LwIP内部也提供了对应的API接口来添加/删除一条静态ARP条目,由于本篇文章并不深究LwIP内部,因此此处不展开叙述。

这里要说明一下的是:静态表项不仅不会老化,还不会被淘汰。

当ARP缓存表满却又需要插入新表项时,ARP协议内核并不会动静态表项,而是按上述的淘汰规则来踢出动态表项。当整个ARP表都是静态表项时,新条目将分配失败,返回错误。

这里给一下静态表项与动态表项的区别:

维度 动态表项 静态表项
来源 ARP 自动学习 手动配置
状态 STABLE / REREQUESTING (LwIP) STATIC (LwIP)
老化 参与老化,超时降级重请求 永不老化
淘汰 表满时可能被 LRU 淘汰 永不被淘汰
回收 会被清理 不会被清理
适用场景 普通设备通信 网关、固定上位机、不响应 ARP 的设备

这里还是要再次强调,静态表项不具备自动感知能力,在更换设备后不会自动更新。如果对端更换了IP-MAC映射,需要手动重新配置或者设计时直接使用动态表项去处理。应只给一些例如网关之类的必要设备配置静态表项,其余设备交给动态表项处理,不能都配置成静态表项。


ARP学习

在上文中我们多次提到过ARP学习,前面我们讲ARP工作流程时,本机广播请求,设备G回复应答,本机把设备G的映射存入缓存表——这个过程就叫作ARP学习。当然,ARP学习并不只局限于两个指定IP设备之间,实际上任何ARP报文到达时,设备都可以触发学习行为(具体是否学习,取决于协议栈的实现策略)。

还是回到上文工作流程中的例子:我们设备向本网段广播了一个ARP请求,设备A、B收到该ARP请求包后,发现目标并不是自己,但是ARP报文本身就携带了本机的IP-MAC映射,为什么不顺手存下来?这样的话假如A、B需要和本机之间通信就不用再ARP了。因此设备A、B都会将本机的IP-MAC映射作为新条目加入到各自的ARP缓存表中。

ARP自主学习行为的好处是很明显的:能够减少整个网段的ARP次数,提高网络通信效率。

不过ARP自主学习是有安全风险的,这也是为什么该功能作为可选功能而不是强制实施再每个设备上。

若设备无条件信任每一个ARP的IP-MAC映射,那么攻击者只需要伪造一份ARP报文,就能随意改写网段中其他设备的缓存表——这就是ARP欺骗。ARP协议本身没有任何认证机制,这个机制带来的副作用在协议层面是无解的。

ARP欺骗

ARP攻击方法很简单,一台普通主机就能发出来,主要有两种:

  • 伪造应答:将自己伪造为网关,直接广播一帧”网关IP的MAC是我”的ARP应答。收到应答的设备会更新已有表项,于是全段设备的网关映射当场被改写,这是最经典的手法。
  • 伪造请求:ARP请求报文同样携带发送方IP-MAC映射,攻击者只要构造一个源信息虚假的请求,收到请求的设备也会顺手把伪造映射记进缓存表。这条路径有时更隐蔽,因为它看起来只是一次普通的询问。

以冒充网关为例,看看一次广播的打击面到底有多大:所有已存在网关表项的设备,表项会被立即改写。这些设备发往网关的流量(也就是全部出网流量)都会先发给攻击者——从这个意义上讲,一次广播就完成了对全段设备出向流量的劫持。若攻击者再开启IP转发,重新将这些流量发回真正的网关,那么就会营造一种网络仍在正常运行的假象,实际上整个网段的流量已经被中间人劫持了。

不过即便如此,现代网络中大量流量都有HTTPS等加密保护,攻击者拿到的也只是密文,所以现实中纯粹的ARP攻击更多被用于断网DoS,或是把流量牵引到钓鱼页面。

防护思路

因此ARP自主学习这一机制在ARP协议中作为可选项给出,LwIP中也提供了编译选项ETHARP_TRUST_IP_MAC用于控制ARP的行为。当然,也有以下的一些方式来进行防护:

  • 使用静态表项:正如上文所说,给网关等关键设备配置静态表项,从根本上拒绝动态改写。
  • 交换机的安全机制:DHCP Snooping + 动态ARP检测(DAI),由交换机校验ARP报文的合法性、丢弃伪造报文;
  • 监控工具:arpwatch 之类的工具持续监听网段内的ARP活动,IP-MAC对应关系变化时及时告警;

可以看到,ARP的无条件学习问题在协议层面无解,所有防护手段的本质都是在协议之外给它补上信任:要么靠人工配置(静态表项),要么靠网络设备的行为约束(交换机安全机制)。


结语

写这篇文章时花了不少时间查阅网络资料,同时根据自己对ARP的理解尽可能的将其叙述清楚。文中涉及到的示例在我的本地环境中已经验证过了一遍,如果您在阅读时发现文章中出现理论错误,还望能够通过邮箱与我联系,帮助我及时修正,不胜感激。

Hyper-V 端口占用问题

最近在Windows11上捣鼓WSL2,跑了一个ubuntu的26.04系统。在Windows上启动WSL服务后,发现我blog在本地跑不起来了,即构建后出现以下错误:

1
2
3
4
5
INFO  === Checking package dependencies ===
INFO === Checking theme configurations ===
INFO === Registering Hexo extensions ===
FATAL Permission denied. You can't use port 4000.
FATAL Something's wrong. Maybe you can find the solution here: https://hexo.io/docs/troubleshooting.html

根据FATAL日志可知我们的 localhost:4000 貌似在引入WSL之后被占用了。

进一步了解发现:我们的Windows作为宿主机,在启用Hyper-V服务后,系统的部分端口会被Hyper-V占用。终端使用以下命令查看被保留的端口:

1
netsh int ipv4 show excludedportrange protocol=tcp

输出

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
协议 tcp 端口排除范围

开始端口 结束端口
---------- --------
80 80
3421 3520
3583 3682
3683 3782
3783 3882
3883 3982
3983 4082
4083 4182
4183 4282
4283 4382
4383 4482
4483 4582
4583 4682
4683 4782
5357 5357
50000 50059 *

* - 管理的端口排除。

可以发现我们的4000端口处于 3983~4082 之间被保留了。这也是为什么我们的程序跑不起来的原因。

这里要说明一点:保留区是动态划分的,也就是说每次重启都会随机划分,所以我们程序端口越高,越不容易和保留区撞车。

解决方法:

  • 将我们程序端口开在保留区之外的区域,例如4800以上(4783 以上大片空闲,不容易撞上保留区)。
  • 修改动态端口范围
1
2
netsh int ipv4 set dynamicport tcp start=55000 num=10536
netsh int ipv6 set dynamicport tcp start=55000 num=10536

以上两行命令可以将动态端口保留区强制限制在 55000 ~ 65536 这个区间,这样就不容易和我们的程序冲突。

  • 对于我们一些常用端口,可以强制进行保留。
1
netsh int ipv4 add excludedportrange protocol=tcp startport=4000 numberofports=1

以上命令执行后,port4000将不会被划入保留端口。


不止是blog,端口随机保留会导致例如代理等服务不可访问,出现一些“有时可用,有时又不可用”的灵异问题。后续若再出现此类类似问题,应先从这方面考虑。

IP 地址体系(IPv4)

前言

入门网络通信的第一步,自然是IP地址体系。IP这个概念在网络通信中十分重要,是通信能否建立的必须前提。在现实世界里,我们要寄一封信,必须在信封上写清楚地址——哪个省、哪个市、哪条街、几号门。网络通信中也是一样的,每个设备都有自己的一个“门牌号”,数据包从你家送到他家,靠的就是这个地址。

要准确的送达数据包,在网络环境中每个设备就必须有一个唯一地址,这个地址就是IP地址。

IP地址分为 IPv4 与 IPv6,目前主流的依然是IPv4,本文所述的IP地址体系也是基于IPv4进行的。

IPv4地址由32位二进制组成,每个字节(8位)划分成一段,采用点分十进制书写便于阅读(例如:192.168.1.10)。一个IP地址内部包含两层信息:网络号与主机号。

网络号有点类似于小区中的楼栋,每一个网络号对应一个网络地址,也就是小区中的一个单元楼。楼里面有许多房间,每个房间就住着一个主机,也就是我们所说的主机号。同一单元楼的主机可以互相“串门”,但是不同单元楼的主机如果需要互相通信,则需要找门卫,也就是我们所说的网关代为传达。这里我们是以现实中小区进行一个比拟便于理解,实际行为也确实是这样的。

下面就以此为基础,详述IPv4的地址体系。


IPv4地址体系

IPv4地址的表示

地址的表述我们在前言其实已经讲过了,这里再说明一下。IPv4地址本质是一个 32位无符号整数:

1
11000000 10101000 00000001 00001010

为了便于表示,我们将其每字节隔开,采用点分十进制表述如下:

1
2
3
4
5
6
11000000 --> 0d192
10101000 --> 0d168
00000001 --> 0d1
00001010 --> 0d10
// 点分拼接后如下.
192.168.1.10

IPv4 地址总量有 2^32 = 4,294,967,296,约合 42.9亿。别看这么多,目前是已经枯竭了的,当前网络环境普遍采用了NAT技术来重映射IP地址,并划分公网与私网段。

关于该技术详见:NAT 地址转换。


IPv4相关核心概念

在详细了解IP地址之前,需要先厘清几个概念:

网络号与主机号:一个IP地址会被子网掩码划分为两个区域,分别为网络号和主机号。当IP地址中主机号全为0时,其代表的就是网络地址,标识的是整个网段的起始地址。主机号就是该网段中某一设备的编号。

子网掩码是目前划分网络地址与主机地址的“度量衡”。在当前网络环境中,普遍使用的是CIDR无类地址(详见下文)划分机制,其子网掩码可以按如下形式表示:

1
2
3
4
192.168.1.10/24
CIDR 划分: 前24位为网络位,后8位为主机位.
其子网掩码为 网络位全1,主机位全0. 即:
255.255.255.0

知道子网掩码后,我们就可以给出精确的网络地址与主机地址的划分机制:

使用IP地址与子网掩码进行与(&)运算,其运算结果就是网络地址。

例如:

1
2
3
4
192.168.43.1/24
子网掩码:255.255.255.0
192.168.43.1 & 255.255.255.0 = 192.168.43.0
192.168.43.0 即为网络地址.

主机号自然就是剩下的8位,总共就2^8 = 256个主机地址。值得注意的是:子网掩码还用来区分网段。如何确定两个设备是否处于同一网段?就用两个设备的IP地址分别去与(&)上子网掩码,若与出来的网络地址相同则说明两个设备处于同一网段。

广播地址是主机号全为1的地址,其作用是向本网段内所有设备广播数据。广播地址是一个特殊的地址,不能单独分给某一个设备。例如上述示例中:192.168.43.0这个网段的广播地址就在192.168.43.255。当该网段内某个设备向该地址发送一个数据包后,整个地址位于192.168.43.x(x!=0 && x!= 255)都能够收到该包数据。

可用主机范围是该网段中,所有能够划给使用使用的具体IP地址的一个范围。这其中需要剔除掉本网段广播地址与网络地址。例如在192.168.43.x网段中,需要剔除掉192.168.43.0(网络地址)和192.168.43.255(广播地址)。剩下的可分配地址范围为192.168.43.1~192.168.43.254,这就是可用的主机地址范围。

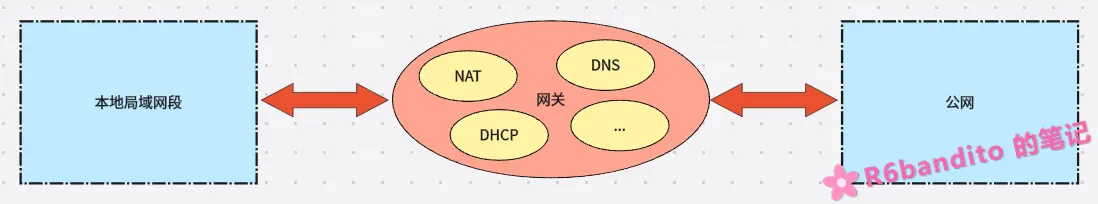
网关:网关是出网段的“大门”,不同网段之间需要通信必须经过网关转发。同时,网络拓扑有本地局域网与公网之分,本地局域网中的设备想要与公网服务器进行通信其流量必须经过本地网关出站,外部公网服务器回复的流量也必须经过本地网关入站才能路由到本地局域网的指定设备。

可以把网关理解为一栋“楼”的“楼长”,楼与楼之间的通信事务由网关进行管理,不能让楼中的“居民”直接插手楼间通信事务。


IP地址的分类
有类地址

早期,IP地址被划分为了五类地址,称作有类地址。如下表所示:

类别 首位 第一字节范围 默认掩码 用途
A 0 1 ~ 126 /8 超大型网络
B 10 128 ~ 191 /16 中型网络
C 110 192 ~ 223 /24 小型网络
D 1110 224 ~ 239 — 组播
E 1111 240 ~ 255 — 保留/实验

比如我们家庭常见的192.168.1.2等等这类IP地址就属于C类地址,用于小型网络。一些网络例如10.124.12.10这类地址就属于A类大型网络。

但是目前这种分类已被废弃,原因是地址划分过于死板,不灵活。举个例子:假如南京某高校使用了A类地址,其网络地址为10.0.0.0,让我们算一下该网段拢共支持多少设备:

1
2
按掩码为 255.0.0.0 来算,其主机位有24位.
2^24 - 2 = 16,777,214.

看到了吗?一个网段能容纳1670万台设备,实际上远远用不到这么多。

这就说明旧式五类划分,要不就划分过大浪费;要不就划分过小不满足,例如C类地址一个网段才 2^8 - 2 = 254 台设备。

所以现代网络已抛弃有类划分,改用 CIDR。


CIDR (无类地址)

现代地址体系中,已不再按类进行IP地址的划分,取而代之的是CIDR无类地址机制。

无类地址:即用/n表示一个IP地址中的网络号的位数。也就是说我们可以将任何一个网络切分成一个子网络,按需进行切割。这个机制十分灵活,规避掉了按类型进行划分的弊端。

例如:

1
192.168.1.10/24

/24表示该IP地址中,前24位是网络号,后8位是主机号,所以可以计算出该网段中可用主机地址共有2^8 - 2 = 254个,对应原来的C类地址。

再来看一个示例:

1
2
10.20.30.40/12
--> 子网掩码:255.240.0.0

该IP中,第一个字节8位与第二个字节的高4位为网络号(\12),剩下的20位为该网段中所有的主机号。

  • 网络地址:10.20.30.40 & 255.240.0.0 = 10.16.0.0。所以该网段起始地址为:10.16.0.0。
  • 广播地址:主机号全1,即:10.31.255.255(注:31是这么来的:0001 1111. 高四位是网络号,低四位主机号全1)。
  • 可用主机地址范围:10.16.0.1 ~ 10.31.255.254(去掉网络地址与广播地址)。
  • 可用主机数目:2^(32 - 12) - 2 = 2^20 - 2 = 1,048,574 。

路由表爆炸与超网合并

当然, CIDR除了让地址划分更灵活之外,还解决了有类时代另一个致命问题——路由表爆炸,这是导致有类划分被彻底废弃的根因。路由器在转发数据包时,内部会维护一个路由表——这个表类似于“指路标”一样,指明该包数据下一跳该路由到哪个位置。

在有类地址时代中,每一类网段都要单独写一条路由。而当时C类网络是全球被使用最多的网络类型,1990s拢共有接近几十万个C类网段。这就意味着核心路由器面临路由表膨胀的问题——路由表的体积极具增大,内存不够、查表变慢、CPU 负载爆炸。如果不解决,互联网会在几年内瘫痪。

CIDR正是用于解决这个问题的。其解法是超网合并:若多个连续网段下一跳相同,就把它们合并为一个大网段一并路由。来看个例子:

某公司有16个网段,这16个网段都接在同一台边界路由器后面。对于外部核心路由器而言,去往这16个网段的下一跳完全相同。其网络拓扑如下:

1
2
3
4
192.168.0.0/24
192.168.1.0/24
...
192.168.15.0/24

在旧式有类地址分类下来看,每个网段都要维护一条路由表,那么核心路由器为该公司就需要维护16个路由表条目。

但是在CIDR的视角下,我们会发现这些网络地址的前20位都是相同的,变化主要集中在20~23位。

1
2
3
4
5
1100 0000(192)	1010 1000(168)	0000 0000(0) 0000 0000(0) --> 192.168.0.0
1100 0000(192) 1010 1000(168) 0000 0001(1) 0000 0000(0) --> 192.168.1.0
1100 0000(192) 1010 1000(168) 0000 0010(2) 0000 0000(0) --> 192.168.2.0
....
1100 0000(192) 1010 1000(168) 0000 1111(15) 0000 0000(0) --> 192.168.15.0

这时我们可以用/20来将这16条路由合并为1条。即:192.168.0.0/20。现在我们来验算下看看对不对:

1
2
3
4
子网掩码:255.255.240.0
网络地址:192.168.0.0
广播地址:192.168.15.255
可用地址范围:192.168.0.1 ~ 192.168.15.254

看到没有?合并前后地址范围逻辑完全是正确的。但是以前我们需要维护16个表项,现在只需1个表项就OK。整整缩小了16倍!这个效率是很高的。同时还有个隐藏福利:

合并之前,16个网段,每个网段2^8 - 2 = 254个可用地址。总的下来有254 * 16 = 4064个IP地址可用。

而CIDR合并之后,2^12 - 2 = 4094个可用地址。为什么会这样?因为合并之前每个网段都有个网络地址与广播地址被占用,拢共有16 * 2 = 32个地址被占用。而合并之后只被占用了2个,那么自然多了30个空余位置出来。

超网合并的优势是很明显的:

  • 使得路由表地址缩小:多条路由压缩成一条,减轻核心路由器负担。
  • 地址利用率提高:原来每个 /24 浪费 2 个地址,合并后只浪费整个大网段的2个。
  • 互联网可扩展:全球路由表从几十万条降到几万条,互联网得以持续扩张。

Ps:CIDR超网合并的一个前提是地址连续,这是必要条件!还是上述公司的例子:如果地址不连续有空洞,即192.168.4.0该网段不属于该公司,那么在合并时不能直接合并为192.168.0.0/20,这么强行合并会把不属于自己的地址也圈进来,导致路由错误。这里尤其要注意。


IPv4私有地址

全球有三段公认的私有地址(也可以理解为局域网地址),这些地址在任何局域网段内部都是可以复用的。

类别 地址范围 CIDR
A 10.0.0.0 ~ 10.255.255.255 10.0.0.0/8
B 172.16.0.0 ~ 172.31.255.255 172.16.0.0/12
C 192.168.0.0 ~ 192.168.255.255 192.168.0.0/16
  • 10.0.0.0/8一般用于大型网络(例如校园网等等)需要组建很多子网的场景。
  • 172.16.0.0/12设备数量介于家庭和企业之间,比如一些公司的分支机构。
  • 192.168.0.0/16基本是家庭路由器的默认配置,地址空间小,够用,且不容易和外部网络冲突。

关于使用规定,并没有强制。只要满足:使用三段地址之一;内网地址不冲突;流量出站时经过NAT网关 就行。

在家用网络里面你也完全可以给本地设备划分一个10.0.0.0/8,只是完全没有这个必要。


IPv4特殊地址

除了私有地址,IPv4还有一批有特殊用途、不能随便分配的地址。

  • 0.0.0.0

这是本机任意地址的通配(IP_ADDR_ANY),根据不同的场景有不同的用法。

你比如DHCP请求时,此时本机还没有IP地址,因此使用0.0.0.0进行填充,等待IP分配;同时,当本机作为服务器进行客户端监听时,使用0.0.0.0:80表示监听本机80端口的所有连接。

  • 127.0.0.0/8

本机本地环回地址。整个 127.0.0.0/8 都是回环地址,最常用的是 127.0.0.1(localhost)。

在这个地址下,数据包是发不出网卡的,会在内核內部兜一圈后重新发回给自己。只要协议栈正常,Ping127.0.0.1是一定能够通的。

环回地址只是在测试场景下使用,当移植协议栈之后可以尝试环回给自己发包,如果能正常接收说明协议栈出口和入口都是正常的。正常工况下不应该有设备被分配为环回地址。

  • 255.255.255.255 / x.x.x.255(定向广播)

两个都是广播地址,用于向网段广播数据包的。

对于255.255.255.255:在DHCP发现服务与ARP广播中都有使用,其作用效果仅限本网段,不会被网关转发。也就是说向本网段内所有设备广播,但不能够跨越路由器。

x.x.x.255是定向广播,也是广播的一种,与255.255.255.255的核心区别在于:理论上网关可以转发该数据包,进而广播到别的网段。例如 我们处于网段:192.168.2.0/24,我们可以向另一个网段的广播地址192.168.1.255发包,该包数据经过网关后会进入192.168.1.0/24网段中并且广播给该网段中所有设备。

不过理论是理论,实际是实际。为了安全起见,现代路由器普遍禁止转发定向广播,因此在常规使用过程中,这两个广播地址的效果其实是等价的。

  • 169.254.x.x/16 (链路本地地址)

这个地址用于在DHCP分配失败后的临时组网。当我们设备没能通过DHCP获取到地址时,就会从169.254.x.x/16中选出一个可用地址来分配给自己。此时设备只能和同网段其他 169.254.x.x 设备通信,上不了网。

举个例子:我们家庭网络地址为192.168.43.0/24。而某台设备在向路由器请求DHCP服务时失败,自己给自己分到了169.254.28.6,此时该设备和网段中的其它设备(192.168.43.x)是无法通信的,因为不处于同一个逻辑网段。此时若另一台设备也请求DHCP服务失败,同样给自己分配了一个169.254.28.3。此时,这两台设备处于同一网段,可以相互通信。

链路本地地址没有网关也上不了网,设备应定期重试DHCP服务,如果你发现你的设备IP地址一直为169.254.x.x,那么多半就是DHCP出问题了。

  • 224.0.0.0/4 (组播地址)

用于一对多通信。例如视频直播:一个源向一组接收者发送,用组播地址。这里关于组播不展开。


NAT 地址转换

引言

在网络通信中,IP地址是不可或缺的一环,无论是什么通信方式,均离不开IP地址。目前主流的IP地址协议为IPv4,一个IPv4地址由32位二进制组成,在表示上采用点分十进制的拆分成四段进行表示。让我们来计算下拢共有多少个IPv4地址可供分配:2^32 - 1 ≈ 42.9亿,考虑到网络地址、广播地址、保留地址等开销,实际可供分配给主机的地址还要更少。

在当今互联网飞速发展的情况下,IPv4地址已经枯竭,IPv6虽然可以从根本上解决IP地址不足的问题,但是目前仍有多数网络设备是基于IPv4的,因此在这个过渡期间就必须得有一个对应的技术来暂时解决这个问题。

NAT(Network Address Translation) 网络地址转换技术正是于此背景之下诞生的。该技术使每个网段更加独立:也就是网段内部私有域中的设备不再能够直接与互联网通信,而是必须走网关通过NAT转换之后才能与外部互联网建立通信。

NAT 技术就是在私网地址与公网地址之间相互转换的,说准确点就是:NAT 技术通过在网关处修改 IP 包的源地址或目标地址,实现私网与公网之间的地址映射。

多个私网地址可以共用一个公网地址,这样即保证了网络通信,又节省了公网地址,这就是NAT的优点。


NAT 做到了什么?

这里需要先声明一点:NAT != 网关。NAT与网关是包含关系——NAT是网关的一个功能子集。网关除了NAT之外,还能集成 DHCP、DNS、防火墙等网络与安全服务,不能简单认为NAT就是网关。

  • NAT 让内网与公网之间无法直接互访。内部私有 IP 地址对外不可见,天然隐藏内网拓扑。外网在没有端口映射的情况下无法主动连接到内网设备。
  • NAT允许灵活组网。私网段用户可以随意使用,本地局域网段无需申请公网IP,就算发生冲突也只限于该网段内部。
  • 极大节省公网IP。通过NAPT技术,一个公网IP可以让数十台,甚至上百台设备同时上网。

目前只要是接入了互联网的网关设备,大部分都集成了NAT技术。

当然,NAT的引入也带来了一定的副作用:

破坏了端到端的通信,增大了网关的负载,也使得P2P通信更加困难。以部分联机游戏举个例子,有的游戏提供 P2P 联机模式,理想情况下,联机双方设备只需要知道对方的IP和端口就能够发起直连,这是双向对称的。

但是,当处于NAT环境下时,由于双方的NAT类型和严格程度不同,所以很可能会出现A发往给B的包,在NAT处被丢掉或反之同理。这就是NAT引入之后带来的不便。

这里附一个常用私有地址域范围表:

类 地址范围 CIDR
A 10.0.0.0 - 10.255.255.255 10.0.0.0/8
B 172.16.0.0 - 172.31.255.255 172.16.0.0/12
C 192.168.0.0 - 192.168.255.255 192.168.0.0/16

这三类地址是全球公认的私有地址,本地网段中想怎么使用都行。即使两个不同的公司内部都用了 192.168.1.0/24,只要他们不直接合并网络,就绝不会冲突。

并且这三类地址也是不可直接路由的,任何公网核心路由器只要看到目标是这三类地址其中之一,就会直接丢弃数据包。所以这些地址只能在局域网内“自娱自乐”,上网必须经过NAT转换。


NAT 的类型与工作原理

静态NAT

静态NAT的规则很简单:永久将一个内网私有地址映射到一个公网地址,每个映射在配置时都是写死在NAT表中的。

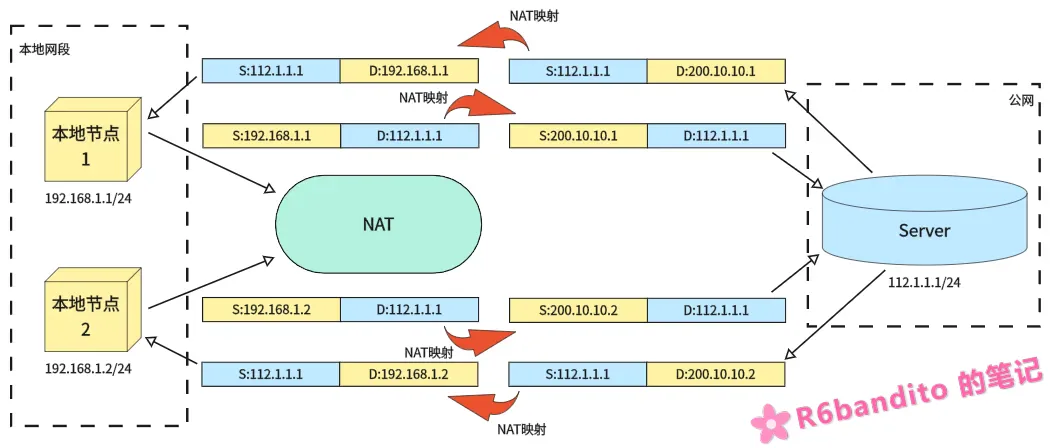
如下图所示:

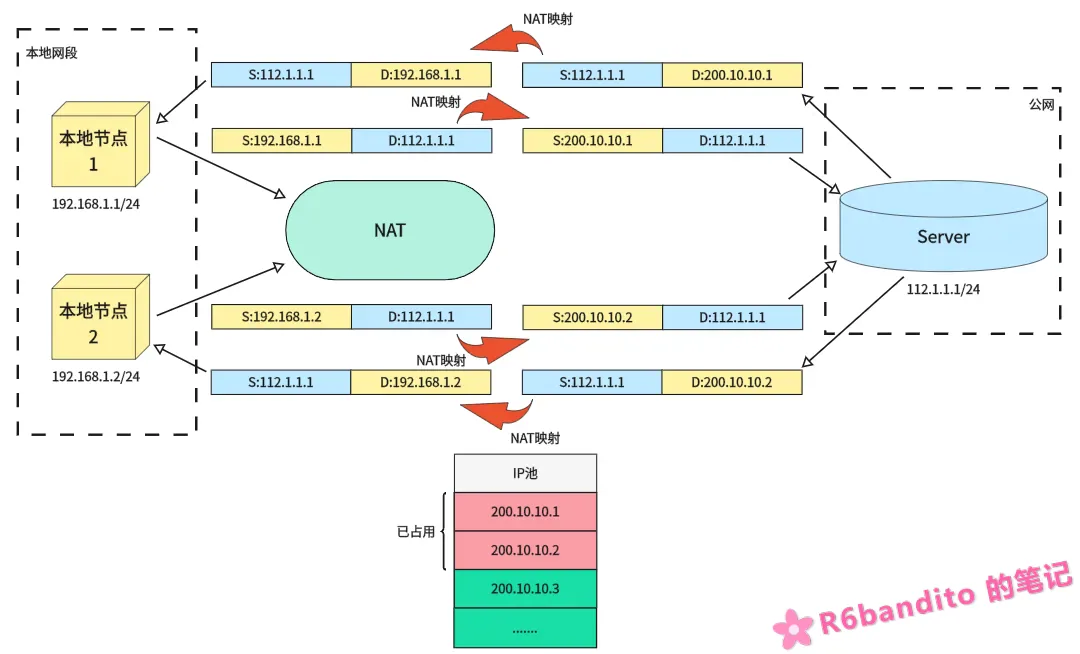
我们有两个本地设备分别为 192.168.1.1/24 与 192.168.1.2/24 需要上网,在静态NAT的规则下,节点1发送出的数据包(S:192.168.1.1/D:112.1.1.1) 经过网关NAT映射后,永久绑定了一个公网IP:200.10.10.1。Server侧收到的是200.10.10.1发来的数据包,当Server要向节点1回复时,是向200.10.10.1这个地址发送数据而不是向192.168.1.1直接发(如果这么发就发到服务端侧自己的本地网段中其它设备去了,很明显错误)!

Server回复的数据经过NAT重映射之后,目标IP从200.10.10.1被网关修改为了192.168.1.1,随后数据被路由给节点1,正确接收。节点2的收发流程也是同理。

在本例中:200.10.10.1 与 200.10.10.2这两个公网IP将被节点1和节点2永久占用。

也就是说一个设备吃掉一个公网IP,这是极其浪费的一种行为。因此静态NAT模式通常用于服务器这些需要对外提供服务的设备(作为服务器必须保证地址稳定可连接)。


动态NAT

动态NAT维护有一个IP地址池,该池中是目前空闲可使用的公网IP。其本质就是:从地址池中进行动态分配,谁先上网就先优先分给谁使用,用完后释放。

动态NAT和静态NAT流程上有相似之处。上例中,我们IP池中原本有 200.10.10.1~x 个空闲公网IP,节点1与节点2都需要上网,因此200.10.10.1被分配给了节点1,200.10.10.2被分配给了节点2。

与静态NAT一样,动态NAT一个公网IP一次只能服务一台设备,因此池中前两个IP被占用,假如此时节点3上线需要进行通信,那么节点池会将空闲的200.10.10.3分配给节点3使用。当地址池被用尽后,只能等待被占用的公用IP被释放后,其他主机才能使用它访问公网。

对于动态NAT而言,其实并没有解决公网IP浪费问题,因为本质上依然是一台设备对应一个公网IP。动态NAT定位十分尴尬:它比静态NAT省一点,但没省到点子上;比NAPT差很多,却没有任何额外优势。在NAPT普及后,纯动态NAT已很少单独使用。


NAPT(端口地址转换)

NAPT技术也叫做端口多路复用,是目前应用最广泛的NAT技术,也是最需要仔细了解的技术。NAPT与静态NAT/动态NAT不同,能够真正做到一个公网IP同时使数十台设备同时上网。

其原理是:使用传输层端口号区分不同的内网主机和会话,所有内网设备共享一个(或少量)公网 IP,通过不同的源端口映射出站连接。

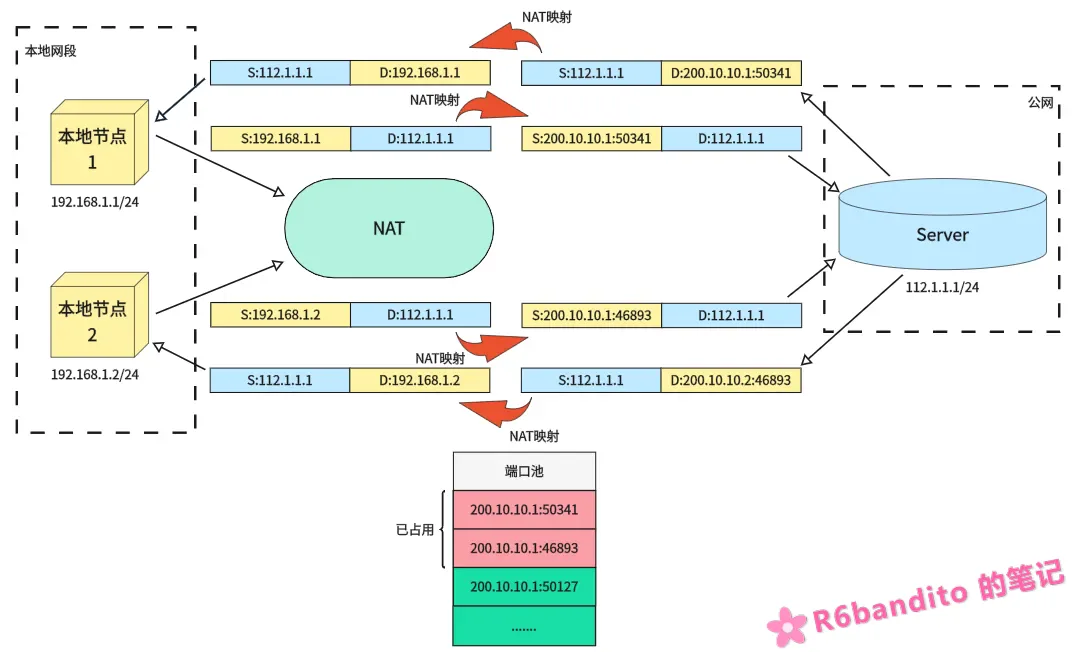
你比如两台本地设备分别被映射到了公网IP 200.10.10.1:50341 和 200.10.10.1:46893,两台设备使用的都是 200.10.10.1这个公网IP,但是流量被接入到了不同端口。若公网Server需要向其中一台设备通信,则只需要向 200.10.10.1:50341/46893 这两个端口发送数据即可。目的IP都是一样的,但是端口号为50341的流量会经NAT转换后被网关路由给设备1,端口号46893则路由给设备2。

具体见下图:

示例中,节点1与节点2分别被分到了公网IP200.10.10.1的50341与46893端口,这两个设备通过一个公网IP上网。当Server回复50341端口时,其数据包来到网关处,NAT查表得到50341映射为本地 192.168.1.1:x 的设备,随后NAT将包中的公网地址修改为本地的地址,交给网关路由到对应设备。整个流程下来Server向200.10.10.1:50341这个地址的回复数据包就被我们本地192.168.1.1:x正确接收到了。

节点2以及其它更多节点的通信都是同样的道理。


三种类型之间的简单对比

类型 映射关系 是否改端口 公网 IP 消耗 典型场景
静态 NAT 一对一,永久 否 1:1,最浪费 对外服务器
动态 NAT 多对多,动态 否 N:M,较浪费 企业内网
NAPT 多对一,动态 是 N:1,最省 家用路由器、手机热点

OSI 七层模型与 TCP/IP 四层经典模型

OSI 七层模型

OSI七层模型,全称是开放系统互连参考模型。是国际标准化组织提出的一个用于管理网络通信的网络分层模型。

如下表所示,OSI模型十分详尽,理论背书充足。但是也正是因为过于理论这个原因,其实现十分复杂,缺乏实际落地应用的基础,且有的层次划分不尽合理。

所以在应用方面实际被广泛使用的是TCP的经典四层模型。

实际学习中,对于七层理论模型了解一下即可。

层级 名称 核心功能 常见协议/设备
第7层 应用层 为用户提供网络服务接口 HTTP、FTP、SMTP
第6层 表示层 数据格式转换、加密、压缩 SSL/TLS、JPEG、ASCII
第5层 会话层 建立、管理、终止会话 NetBIOS、RPC
第4层 传输层 端到端可靠传输 TCP、UDP
第3层 网络层 路由选择、逻辑寻址 IP、ICMP、路由器
第2层 数据链路层 帧封装、MAC寻址、差错检测 以太网、交换机、PPP
第1层 物理层 比特流传输、电气特性 网线、光纤、集线器

TCP/IP 四层经典模型

TCP/IP 四层模型才是真正的重头戏。与OSI理论模型不同,TCP经典模型是在不断的实践运用中逐渐积累起来的。主要分为以下几个层次:

层级 对应 OSI 层 核心功能 常见协议
应用层 5+6+7 用户服务 HTTP、FTP、DNS、SMTP
传输层 4 端到端传输 TCP、UDP
网络层 3 路由寻址 IP、ICMP、ARP
网络接口层 1+2 物理传输 以太网、Wi-Fi、PPP
  • 应用层:囊括了理论模型的会话、表示层,统一收拢到应用层中。常见的上层应用协议(例如HTTP、MQTT、DNS等等)均在此层
  • 传输层:这和理论模型第四层是相同的,TCP/UDP的“老巢”,负责端到端(你也可以理解为 进程–>进程)之间的数据包寻址。
  • 网络层:同理论模型第三层,主要是IP协议,规定了数据包怎么走,走哪条路。该层还包含了ARP与ICMP等等次生协议用于辅助通信。
  • 网络接口层:对应理论模型的1、2层。负责将数据变为光电信号发出,网卡驱动以及物理线缆都属于这一层的范围。

总的来说,TCP/IP 四层把 OSI 的上三层(会话、表示、应用)合并成应用层,下两层(物理、数据链路)合并成网络接口层。这不是简单的“压缩”,而是按实际工程需要重新划分——OSI 的会话层和表示层在实际协议栈中几乎没有独立实现,它们的功能被直接塞进了应用层协议里(比如 TLS 做加密、HTTP 管会话)。

数据封装与解封装流程

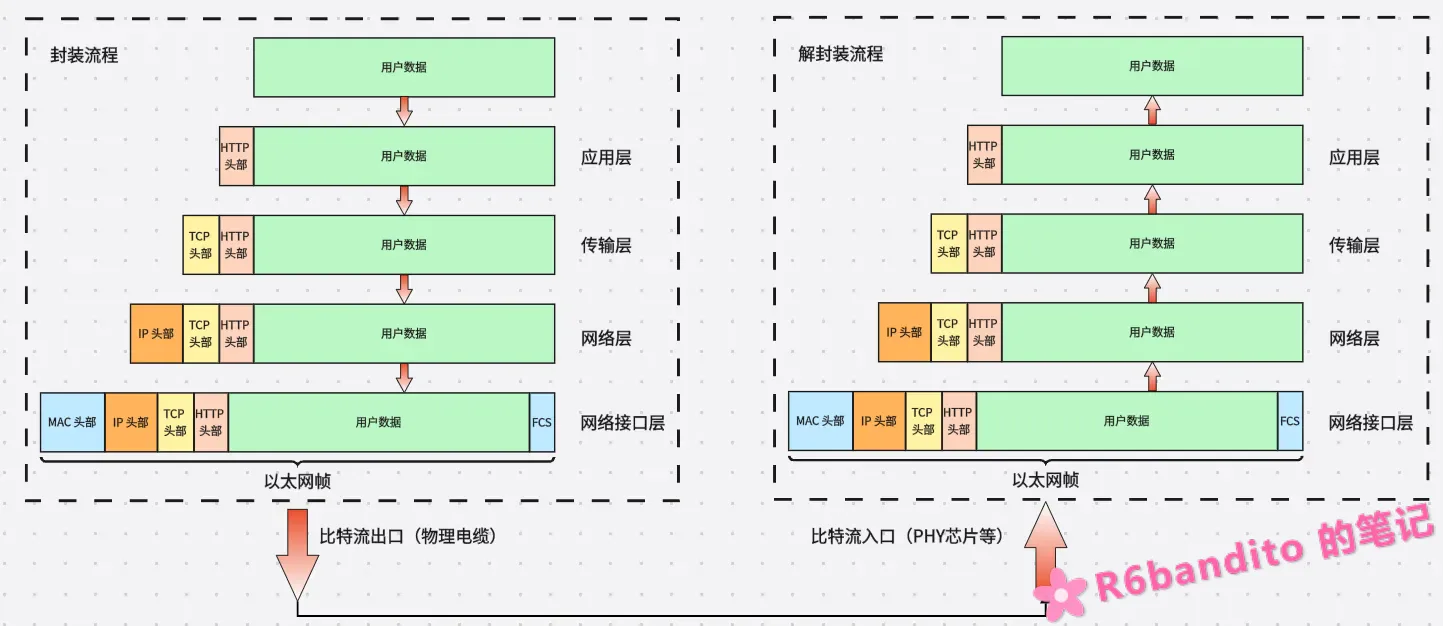
四层模型每一层都对应这一个封装与解封装的过程:

  • 对于发送方而言,由应用层开始从上至下,每经过一层就加上该层的头部(或尾部),这个过程就叫封装。
  • 对于接收方而言,由物理层(接口层)开始从下至上往上递交,每经过一层都要剥去该层的头部(或尾部),这个过程叫解封装。

所以总的来说,分层的本质是:各层只关心自己的头部,只根据自身的头部进行对应操作,而不关心其它层的内容。其它层的内容相对于它们就视作普通数据负载。

以下是以HTTP为例的以太网数据包封装与解封装示意图:

发现了吗,封装流程与解封装流程基本上是一样的,只是方向不同罢了。

在传输过程中,传输层的PDU单位叫作“段”,也就是我们说的TCP报文段;网络层单位叫作“包”,IP数据包;在接口层叫作帧,以太网帧。了解一下就好。

关于数据发出与接收的详细流程,本文不做阐述,这些细节将在其余文章进行单独叙述。

为什么工程上用 TCP/IP 而不是 OSI?

因为OSI 是“先定标准,再写实现”,TCP/IP 是“先有实现,再总结标准”。这就导致:

  • OSI 的协议栈复杂、层次过多,实际部署极少;
  • TCP/IP 经过 ARPANET 和互联网几十年实战检验,实现轻量、兼容性好;
  • 但 OSI 的分层思想被 TCP/IP 完整继承——所以我们理论研究时可以用 OSI 进行阐述和理解,但是落实到实际工程中要用 TCP/IP 。

一些杂记(三)

全局数据结构/静态局部数据结构/普通局部数据结构分别存储在程序的哪些段中?

在进行区分之前,我们先来看看在嵌入式C语言程序中都有哪些核心的内存段划分:

段名 存放内容 物理属性 典型例子
.text 代码段:所有可执行指令、函数体。 Flash(只读) if、while、函数调用等等。
.rodata 只读数据段:常量、字符串字面量。 Flash(只读) const char *p = "Hello"; 中的字符串 "Hello"。
.data 已初始化读写数据:全局/静态变量,且有非零初值。 Flash存初值,启动时拷贝到RAM int a = 5; 中的 5 存在Flash,变量 a 在RAM。
.bss 零初始化数据:全局/静态变量,无初值或初值为0。 RAM(无Flash占用) int b; 或 static int c = 0;。启动时由 __main 循环清零。
Stack 栈(由编译器管理):局部变量、函数调用现场(返回地址、寄存器)。 RAM uint8_t temp;(定义在函数内部的)。
Heap 堆(由用户管理):动态分配的内存。 RAM malloc(size) 申请的空间。注意:如果工程没用到标准 malloc,这个段通常很小甚至为0。
  • 对于全局数据结构:这里要考虑是否初始化为0。看下面的例子:
1
2
3
uint8_t g_verA;
uint8_t g_verB = 50;
static uint16_t g_init = 100;

三个变量均开辟在全局数据区,g_verA 默认初始化为0,g_verB 和 g_init 都进行了对应的初始化。对于 g_verA,由于没有进行显示初始化,因此被放在了 .bss 段,上电后由 __main 进行清零操作,并且在 Flash 中零占用;

g_verB 和 g_init 进行了显式初始化,因此被放入 .data 段中(这里要注意:被放入.data中的只是变量本身,初始化数据是被放入了 flash 中的)。系统上电后,__main 会将 flash 中的对应初始化数据拷贝到 .data 中对应的位置。这也是为什么我们的全局变量能够一进入程序就已经被赋予一个初始化值的原因。

  • 对于普通局部数据结构:是统一放在函数调用栈中的。
1
2
3
4
5
6
void 
funcA( void )
{
struct test myTestStructure;
// ....
}

myTestStructure 这个结构我们是在函数局部空间进行定义的,因此其被压栈存入到函数栈中。只在当前的作用域有效,一旦函数运行周期结束出栈返回,这个变量的内存空间也随即跟着被销毁了。

由于栈大小是固定且通常比较小,因此不要在局部定义大型数据结构(例如大数组或大型结构体),注意堤防栈溢出。

  • 静态局部数据结构:前面我们说过,static 修饰局部数据结构时不改变其作用域,只规定其生命周期。
1
2
3
4
5
6
void 
funcA( void )
{
static struct test myTestStructure;
// ....
}

此处,myTestStructure 虽然定义语句在局部,但是由于 static 的修饰,其真正的内存空间位置是被放在了 .bss 段(未显式进行初始化,因此默认初始化为0)。当程序流程进入 funcA 时,不会压栈 myTestStructure,而是从 RAM 中直接读出该变量,操作完毕后 funcA 返回,myTestStructure 依然有效。

这里要强调一点:.bss 和 .data 段一大区别就是是否在 flash 中有占用。.data段的数据在上电时需要来自 flash 中的初始化值,而 .bss 不需要,因此 .data 在 Flash 中和 RAM 中是双份空间占用!


堆和栈的主要区别

对比维度 栈(Stack) 堆(Heap)
管理方式 自动管理。编译器自动插入入栈/出栈指令,用户不需要也不应该插手。 手动管理。用户必须显式调用 malloc/calloc 申请,用完必须 free。
分配速度 极快。仅涉及栈指针的移动。 较慢。内部涉及搜索算法,需要遍历空闲链表寻找合适大小的内存块。
生命周期 临时。函数执行完,里面的局部数据结构立即被销毁。 长期。只要你不主动 free,内存一直有效(哪怕函数已经退出)。漏 free 就会造成内存泄漏。
内存碎片 无碎片。后进先出(LIFO)机制。 有碎片。多次申请释放会留下许多细小的空洞,无法被进一步使用(外部碎片)。
大小限制 通常很小,由编译器或链接脚本固定。 较大。

这里讲讲标准C和嵌入式C中的关于堆栈相关的一些差异:

  • 堆内存的来源不一样

标准C语言中堆由操作系统通过 brk/sbrk 系统调用动态扩充,堆区(.heap)位于链接器预留的虚拟地址空间,且在程序运行过程中可以向 OS 申请扩大。

但在嵌入式环境下,标准C没有所谓的操作系统层调用。其操作的本质是一块预先在编译期就定义好的巨型静态数组,形如 static uint8_t ucHeap[20 * 1024]; 这个数组被放在 .bss 或 .data 段,所以堆的大小在编译时就彻底固定了,无法动态扩充。

现在很多中间件你比如 FreeRTOS / lwIP 等等,内部都会实现自身的动态内存管理算法而不是直接使用标准C的实现。这些管理算法实现的本质其实也是在一块巨型静态数组上进行切割分配和回收。

  • 栈溢出后果不同

标准C栈通常很大(几 MB),且如果栈溢出,操作系统可能会分配新的内存页或触发段错误,程序会崩溃但是容易排查。

但是在嵌入式中,栈空间很小(通常1~4Kb),栈溢出后会静默踩到相邻的全局数据结构或另一个任务栈,导致程序运行出现 HardFault 。比较难以排查。

  • 使用标准与安全性

嵌入式中, 标准 malloc 实现是不可重入的,不应该在多线程环境中使用。裸机环境下若不得不使用,应保证不在 ISR 中使用。因为 malloc 内部涉及搜索算法,其分配时间是不确定的,而 ISR 要求尽快返回。

同时,不管在任何环境,若必须使用malloc 请一定使用临界区/或互斥量等手段进行保护。因为不可重入性,若在分配过程中被打断并在别处再次调用 malloc 就很可能会造成整个堆管理结构直接损坏。

标准C的堆实现在实际运用中,基本不会被使用到。需要动态内存分配时,应优先考虑适用于嵌入式环境的三方内存分配算法。


音乐
0:000:00