一些杂记(二)

C语言中的 static 关键字

static 关键字用于声明一个静态数据,修饰变量或函数时作用各不同,这里简单讲讲:

  • 修饰全局数据结构:这个很简单,就是将被修饰的全局数据结构作用域严格限制在本模块内。例如在 uart.c 中有一个全局数据变量: static UART_HandleTypeDef huart; 在另一个模块 app.c 中就不能够使用 extern 来获取这个变量。对于函数也是一样的,其一旦被 static 修饰,表示这是一个内部独有功能模块,就不能通过.h向外引出给别的模块使用。在日常使用中,秉承接口简洁易用的原则,对于一些只在库内使用的辅助功能 API 就可以打上 static ,没必要暴露给外部。

  • 修饰局部数据结构:修饰局部结构是 static 的一个重点特性,它不限定作用域,而是起到一个数据结构生命周期常驻的作用(我们都知道局部数据结构生命周期只在本次调用,一旦返回返回出栈就被销毁了)。如下示例:

    1
    2
    3
    4
    5
    6
    7
    void 
    funciton_A( void )
    {
    int8_t temp_var = 0;

    printf( "temp=%d", temp_var++ );
    }

    temp_var 作为局部数据结构,在当该函数被调用时创建,当函数退出时出栈被销毁。因此该变量并不具备重入“记忆”功能。我们在外部循环调用function_A得到如下结果:
    temp=0

    temp=0

    temp=0

    temp=0

    ….

    当我们使用 static 修饰 temp_var 时,该变量的内存位置不再是局部,而是位于全局静态数据区,生命周期被提升到了全局。此时我们继续循环调用,就能看到如下结果:

    temp=0

    temp=1

    temp=2

    temp=3

    …

    最后总结一下:对于 static 修饰局部数据的情况,局部数据的作用域是不会发生改变的,改变的是局部数据的生命周期。其存储位置从一开始的局部任务栈变为了全局数据区(.data/.bss)。

    这里要强调下:不是说程序运行到 static 处才把变量放到全局数据区,而是在编译阶段该块内存就已经被开辟到全局数据区了,该变量在函数调用时永远不会被压栈创建或出栈。


C语言中的 sizeof 关键字

sizeof 用于计算一个类型或变量在内存中占用的字节数,其返回值类型为 size_t。这里要注意,sizeof 不是函数调用!sizeof 在运行阶段是看不到的,不存在函数调用的压栈出栈过程。sizeof 计算式是在编译期被展开和计算的。

1
2
3
4
5
6
7
void 
funciton_A( void )
{
uint8_t ver = 0;
sizeof( ver++ );
printf( "ver=%d", ver );
}

上面示例运行后,得到 ver=0,也进一步说明了sizeof 并不属于函数调用,在运行阶段看不见,ver++也没有被执行。

sizeof 只关心类型,你比如:

1
2
3
4
5
6
7
8
9
int arr[10] = {0};
int *ptr = arr;

void
funciton_A( void )
{
printf("%zu\n", sizeof(arr)); // 40 (整个数组大小:10 * 4)
printf("%zu\n", sizeof(ptr)); // 4 或 8 (指针本身的大小,取决于平台位数. 32位MCU为4字节)
}

sizeof 的使用频率是比较高的,这里简单讲几个容易出错的例子:

  • 在计算结构体类型的数据占用空间大小的,要考虑编译器的对齐模式!除了对齐到1字节是不需要填补(padding)字节之外,其余对齐模式大部分情况下均需要考虑结构体对齐!结构体对齐此处举个示例,不做更多解释:

    1
    2
    3
    4
    5
    6
    7
    8
    9
    10
    11
    12
    13
    struct myModule
    {
    char a;
    int b;
    short c;

    } module1;

    void
    funciton_A( void )
    {
    printf( "structure: %d\n", sizeof(module1) ); // 12. 不是 7!(编译器4字节对齐)
    }
  • sizeof 可用于取数组大小,但是当数组通过指针作为函数入参进行透传时,将退化成指针形式,不能直接使用sizeof 取大小。

    1
    2
    3
    4
    5
    6
    7
    8
    9
    10
    11
    12
    13
    14
    int arr[10] = {0};

    void
    funciton_A( void )
    {
    function_B( arr );
    }

    void
    function_B( uint8_t *pArr )
    {
    printf( "ArraySize: %d\n", sizeof(pArr) ); // 4.
    printf( "ArraySize: %d\n", sizeof(arr) ); // 40.
    }
  • C 语言与 C++ 对字符常量定义的类型不同,用 sizeof 取出的大小也不相同。对于 sizeof(‘a’),C语言中将其类型解释为 int ,因此算出来为大小4;而 C++ 中将其类型解释为 char 类型,因此算出来大小是 1。这里要注意。


C语言中的 volatile 关键字

volatile 用于告诉编译器对被修饰的变量不要执行指令重排以及缓存优化,保证每次对该变量的访存操作都必须从实际的物理地址读出。之所以需要该关键词,是因为编译时有多档优化策略,对于一些随时可能由底层硬件改变的变量,若优化过于激进则可能会将该变量值进行缓存,无法及时响应变化导致程序出现问题。

嵌入式中,以下几个场景最好使用 volatile 保证程序的可预测与安全性,尤其是第一种情况,必须使用 volatile 关键字!

  • 外设寄存器地址映射:这种情况必须要加!硬件寄存器的值随时会被底层更改,如果不加 volatile,编译器可能只读一次寄存器值放进通用寄存器 R0,然后就一直用 R0 里的旧值,永远读不到最新结果。

    1
    2
    3
    4
    5
    6
    7
    8
    9
    10
    11
    12
    #define     __IO    volatile             /*!< Defines 'read / write' permissions */

    typedef struct
    {
    __IO uint32_t SR; /*!< USART Status register, Address offset: 0x00 */
    __IO uint32_t DR; /*!< USART Data register, Address offset: 0x04 */
    __IO uint32_t BRR; /*!< USART Baud rate register, Address offset: 0x08 */
    __IO uint32_t CR1; /*!< USART Control register 1, Address offset: 0x0C */
    __IO uint32_t CR2; /*!< USART Control register 2, Address offset: 0x10 */
    __IO uint32_t CR3; /*!< USART Control register 3, Address offset: 0x14 */
    __IO uint32_t GTPR; /*!< USART Guard time and prescaler register, Address offset: 0x18 */
    } USART_TypeDef;

    这是ST官方 HAL 抽象层关于 USART 的一个类型定义,可以看到内部对于每个外设寄存器均采用 volatile 保护。

  • 任务上下文与 ISR 共享的全局变量:
    编译器在编译主循环代码逻辑时,是不会考虑 ISR 的。这就会导致一个问题:当优化行为十分激进时,例如有while(flag == 0),其中 flag 只在中断中被修改。当主循环进行编译时,会发现主逻辑代码里面没有修改 flag ,因此为了加速访存,可能会理所当然的将该变量的值读到内部通用寄存器中,后面的循环再也不去内存读真实值了。程序逻辑自然也偏离了我们预期的行为。
    来看下面这个例子:

    1
    2
    3
    4
    5
    6
    7
    8
    9
    10
    11
    12
    13
    14
    15
    16
    17
    18
    19
    int key_pressed = 0; // 没加 volatile!

    void EXTI0_IRQHandler(void)
    {
    key_pressed = 1; // 中断来了,修改了这个值
    }

    int main(void)
    {
    while(1)
    {
    // 等待按键按下
    if (key_pressed == 1)
    {
    printf("Key pressed!\n");
    key_pressed = 0;
    }
    }
    }

    程序在逻辑上似乎没什么问题,但是当编译器优化比较激进时(-O2,或更高),编译器可能会尝试将 key_pressed 这个变量值移入内部寄存器中,以便加速读取。但是一旦被放入寄存器缓存,那么当中断触发时,就算key_pressed已经被中断修改了,但是主循环依然拿到的是寄存器中的缓存旧副本。后续程序运行均在读取旧值,if 语句可能永远进不去。
    而若 key_pressed 使用 volatile 修饰,则编译器不会缓存,每次访存都会强制从具体地址读取。因此中断修改值后,主循环能够正确读取到更新值并触发对应逻辑。

  • RTOS 环境下多任务间的共享变量
    道理与上述 ISR 与主循环的逻辑是一样的。编译器在编译代码时并不知道所谓的什么任务调度器,也不会考虑到当前编译的代码可能会被别的任务打断这种情况,因此在优化比较激进的情况下,也会产生一些非预期的指令重排和变量缓存的情况,进而导致程序跑飞。考虑下面程序:

    1
    2
    3
    4
    5
    6
    7
    8
    9
    10
    void Task_Read(void) {
    while(1) {
    // 编译器看到:这里只有读操作,没有写操作
    if (g_data_ready == 1) {

    // .....
    }
    vTaskDelay(1); // 让出 CPU
    }
    }

    示例中,高优化程度的编译器在编译这段代码时,会看到整个 Read 函数 if 之前只读了 g_data_ready ,并没有修改。为了效率会将 g_data_ready 缓存起来,下次判断直接用它来判断,节省了总线的带宽。但是这显然不对,因此需要 volatile 保护。

由于 volatile 的实验要求有些高,不是很容易看见现象,此处我给出一个具体可用的,能直接观察的 volatile 示例:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
// main.c
uint8_t flag = 0; // 这里没有加 volatile.

void
task1( void *parametre )
{

while ( flag == 0 )
{
// do nothing.
}

printf("Flag detected!\n");
flag = 0;

while(1)
{
printf("Runing!");

vTaskDelay(1000);
}
}

// it.c
extern uint8_t flag;
void
HAL_TIM_PeriodElapsedCallback( TIM_HandleTypeDef *htim )
{
static uint16_t count = 0;
if ( htim->Instance == TIM6 )
{
HAL_IncTick();
if ( (count++) == 500 )
{
count = 0;
flag = 1;
}
}
}

上述示例中,我们在 task1 内部读取 flag 标志,而该标志的修改在 TIM 的 ISR 上下文。此时对于编译器而言,在高优化程度下,首先会检查该变量是否被 volatile 修饰,因为 volatile 是硬约束,编译器无权删/并/挪;之后编译器会检查自身可见的代码路径上是否有任何可能改写该变量的操作:例如函数调用或显示赋值。在 while ( flag == 0 ) 这个窗口下,没有任何函数调用和直接改写操作。而编译器又看不到中断、DMA、别的任务之类的,因此不会将他们视作威胁。

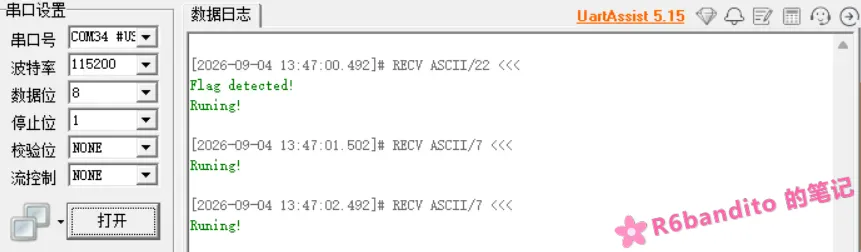
就这样,编译器直接放心大胆的将 flag 进行缓存,所以上述程序运行现象应该是不会打印任何信息。实测也确实是这样(-O3优化等级),可以看到调试器中没有任何输出。
接下来我们将 flag 使用 volatile 修饰:

1
volatile uint8_t flag = 0; 

再次运行,可以看到调试器已经有输出,程序逻辑正常运行

说明 volatile 成功阻止了编译器的优化,强制每次访存必须重读具体地址。

既然 volatile 更安全,那么全局数据都用 volatile 保护不就好了?这个肯定是不可以的,volatile 等于是放弃了编译器的优化,因此程序执行效率会受到影响。


i++ 与 ++i

两个都是C语言中的自增运算符,区别就是一个是前置自增(++i),一个是后置自增(i++)。

后置自增就是先返回当前值,再将变量i自增。这里要注意的一点是:后置自增返回的是保存了旧值的一个临时副本,而后i再自增;前置自增是变量i先自增,再返回。期间不会产生临时数据结构。

因此,i++不能作为左值(因为返回的是临时数据结构),而++i可以作为左值(返回的就是变量本身)。

1
2
3
int i;
i++ = 10; /* 错误! 后置自增不能做左值. */
++i = 10; /* 前置自增由于返回的是变量本身,因此可以作为左值. */

这里讲一个容易入坑的地方,先考虑下面这一段程序:

1
2
3
4
5
6
7
8
9
10
int *p;
int buf[2];

void
function_A( void )
{
p = buf;
*p++ = 10;
*p = 20;
}

这里一定要分清,*p++ 等价于 *(p++),即先取 p 的旧地址解引用,而后 p 自增指向下一个位置。因此buf[0] = 10,buf[1] = 20。由于p++返回的是地址,而我们是对地址做解引用运算,因此不存在左值问题,哪怕它是后置自增运算。

单独使用的情况下(++i/i++独立使用),二者的行为都是做一次自增,效果完全等价。


指针数组与数组指针

二者本质就是一个是数组,一个是指针,这里简单解释一下。

指针数组 int *p[10];:C语言中,[]运算符的优先级是大于 * 的,所以p先和[10]结合表示p是一个深度为10的数组,剩下的 int * 表示数组中每个元素的类型是指向 int 的指针。

因此 int *p[10]; 表示一个存放了10个 int * 的数组,也叫做指针数组,数组内部的元素是指针类型!

数组指针 int (*p)[10];:由于括号存在,*优先与p结合,表明p是一个指针,而后与[10]结合表示指向一个 int [10]的指针。

因此 int (*p)[10]; 表示这是一个指向存放10个 int 类型的数组的指针。

1
2
3
4
5
6
int *p1[10];   // 指针数组.
int (*p2)[10]; // 数组指针.

printf("%zu\n", sizeof(p1)); // 在 32 位机下输出 40 (10 个 int * 指针,每个 4 字节).
printf("%zu\n", sizeof(p2)); // 在 32 位机下输出 4 (仅有一个指针).
printf("%zu\n", sizeof(*p2));// 输出 40 (因为 p2 指向的是 10 个 int 的数组,10*4=40).

以下是指针数组的应用场景之一:

做 AT 命令的串口解析时,通过指针数组构建一个命令表,进行查表匹配

1
2
3
const char *cmd_list[3] = {"AT", "RESET", "READ"};
// cmd_list 是一个数组,里面存了 3 个指向字符串常量的指针。
// 你可以通过 cmd_list[0] 拿到 "AT" 的首地址。

对于数组指针:

假设你有个 3 * 128 的 LCD 缓冲区,可以通过数组指针来逐个操纵每行的数据。如下所示:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
uint8_t screen_buf[3][128]; // 假设 3 行 128 列

void
process_row( uint8_t (*row)[128] ) // 入参是一个数组指针.
{
// 此时 row 指向 screen_buf[0] 这整一行.
for (int i=0; i<128; i++)
{
(*row)[i] = i; // 操作该行数据.
}
}

// 调用时:
process_row(screen_buf); // 数组名退化为指向第一行的指针(即数组指针).

一些杂记(一)

在 FreeRTOS 中创建一个任务后,任务可能处于哪些状态?请简要叙述每种状态的含义。

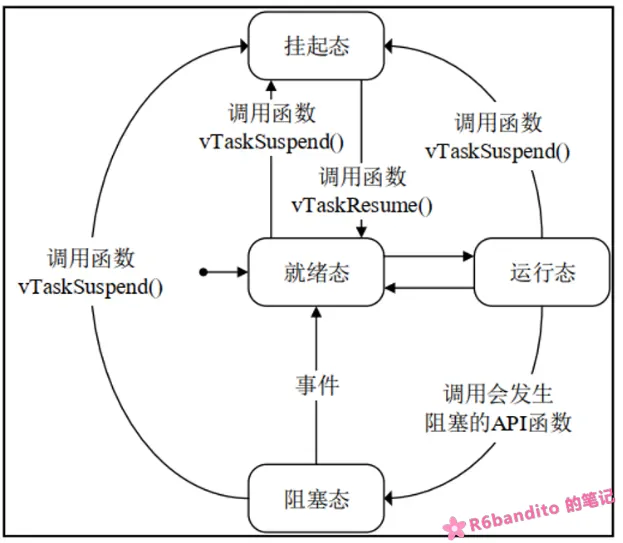
FreeRTOS中,常见的任务状态有 就绪态,运行态,阻塞态,挂起态。同时还有一个删除态,这个状态比较特殊。

创建完毕一个任务后,该任务就被挂入就绪列表,处于就绪态:等待调度器进行调度.

当一个处于就绪态的任务被调度器选中并执行时,该任务随即从 就绪态 -> 运行态.。表示该任务目前正被 CPU 执行。需要注意的是,在单核 CPU 中同一时刻只能有一个任务运行。

处于运行态的任务,若发生阻塞调用(例如 延时 / 等待事件或信号量 / 队列操作等),则由 运行态 -> 阻塞态,并被挂入对应的阻塞事件列表;若用户手动调用 Suspend(),则任务进入挂起态,不再参与调度,直到显式被 Resume() 恢复。

处于运行态的任务在时间片耗尽,且同优先级有其余任务就绪的情况下,会发生时间片轮转(可配置),该任务会被放回就绪列表,调度器重新选择另一个处于就绪态的任务执行。

处于阻塞态的任务,若成功等到事件 / 超时,则会从阻塞态重新回到就绪态等待被调度。若解除阻塞的任务优先级最高,则立即发送任务切换。

这里简单聊聊 删除态 :

删除态是 FreeRTOS 的合法状态之一,当调用 vTaskDelete() 删除任务时,任务会进入该状态,同时该任务将被从可能有的 阻塞列表 / 挂起列表 / 就绪列表 中摘除,并挂入删除列表。然后由系统在空闲任务运行时,对其 TCB 控制块以及分配的栈空间进行释放(若未发生动态分配,则不会释放。由用户自行管理)。


FreeRTOS 中二值信号量与互斥信号量有什么主要区别?各适用于什么场景?

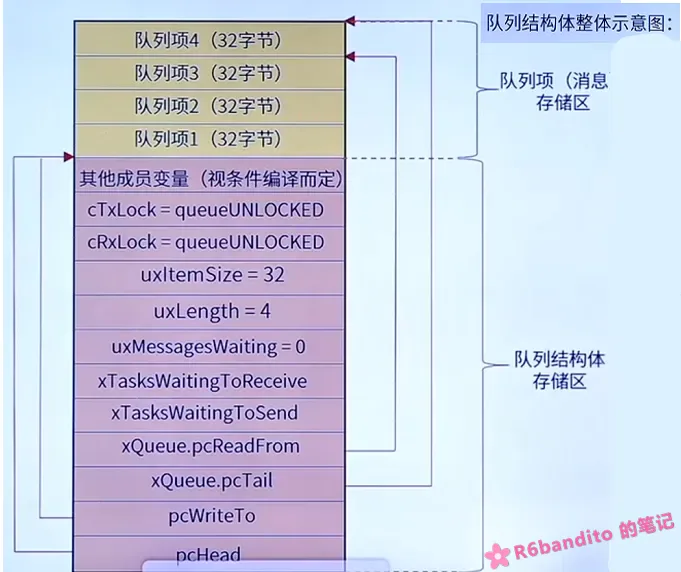
二值信号量与互斥量,在 FreeRTOS 中,二者的本质都是队列。与队列的区别在于,队列有数据段,而信号量/互斥量只使用到了队列的控制结构,自身没有数据段,算是一个特殊的队列。

从下图可以看到:普通的队列除了紫色的控制头区域之外,还有队列项,也就是数据区;而 信号量/互斥量 并没有队列项区域,所用到的只有紫色的控制头!

二值信号量常用于任务间同步与对于低频事件的响应。在存在三个及以上任务,且任务优先级呈梯度排列的场景下,不能够用于资源的保护,因为很大概率会造成优先级的翻转。

互斥信号量与二值信号量类似,但是互斥信号量引入了简易的优先级继承机制。同时会记录持有的任务,遵循谁持有就由谁释放的原则。互斥信号量极大程度上缓解了优先级翻转带来的影响,因此互斥量主要用于多线程环境下,资源的访问保护,保证资源的串行化访问。

要注意:ISR中不允许使用互斥量!因为 ISR 并没有任务上下文这一概念。


configUSE_TIME_SLICING 是什么?当多个任务具有相同优先级时,调度器如何工作?

configUSE_TIME_SLICING 是 FreeRTOS_Config.h 配置文件中的一个可配置项,用于配置是否启用优先级轮转调度的。

FreeRTOS 的常用配置就是 : 不同优先级抢占式调度 + 相同优先级轮转式调度。因此该宏在大部分情况下都是默认启用的,除非你需要手动精准把控任务切换,否则保持默认打开即可。

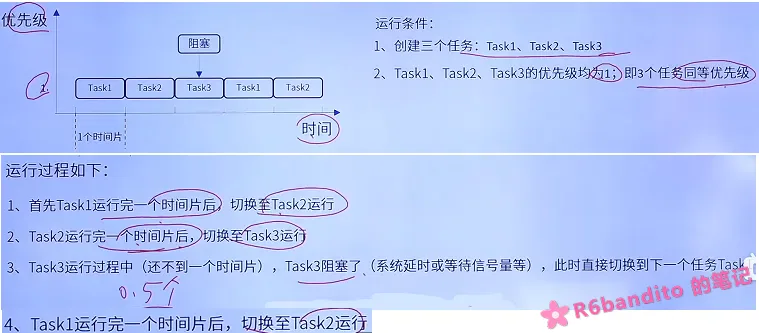
当启用该宏后,对于同等优先级的多个就绪任务,每个任务轮流的享有 CPU 的时间片,在 FreeRTOS 中,一个时间片多长取决于系统 Tick 周期(Tick周期可通过 configTICK_RATE_HZ 配置)。

当执行完一个时间片后,SysTick 中断会触发内核进行调度检查,此时会去检查相同优先级下是否还有其余就绪任务。若有,则将当前任务挂到就绪任务列表末尾,等待下一次调度,同时取当前就绪列表头节点作为下一个待运行的任务。切换完毕后,新任务继续跑一个时间片,再次触发任务切换,以此循环反复。

要注意一点:抢占式调度与时间片轮转二者并不冲突,抢占调度的核心是以优先级为主,哪怕次优先级任务有多个已就绪,但是目前有1个最高优先级独占 CPU ,那么时间片轮转依然不会触发;只有等到最高优先级任务释放CPU,那么次优先级任务才会得到调度,并在这些就绪之间执行时间片轮转政策。


什么是任务通知?与队列和信号量相比,有什么优势和局限性?

任务通知是内嵌在内核任务 TCB 中的一个属性,完全独立于队列和信号量。任务通知更加轻量化,不需要创建额外数据结构,其字段嵌在任务 TCB 中,在任务被创建并分配内存的那一刻就已可用。是一个轻量化的通知系统,并在通信过程中还允许携带一个32位变量,在通知目标对象的同时还能够传递一个值或标志。

典型场景比如中断的下半段处理:

例如我们期望在外部中断中置起一个标志位,然后在专门的任务中处理相关逻辑。例如下面一段示例代码所示

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
// ISR 中(中断上下文).
void EXTI0_IRQHandler(void) {
// 清除中断标志位.
HAL_GPIO_EXTI_IRQHandler(GPIO_PIN_0);
// 直接通过任务通知唤醒任务(相当于Give).
vTaskNotifyGiveFromISR(xProcessTaskHandle, NULL);
portYIELD_FROM_ISR(pdFALSE);
}

// 任务中(任务上下文).
void vProcessTask(void *pvParameters) {
while(1) {
// 永久阻塞等待通知(相当于Take),拿到后自动清零.
if (ulTaskNotifyTake(pdTRUE, portMAX_DELAY) == pdTRUE) {
// 处理逻辑.
process();
}
}
}

我们在中断中只置位标志,具体的耗时逻辑放到任务中进行处理。在这里我们使用任务通知直接唤醒对应任务,省去了创建二值信号量的开销,并且速度也更快。

任务通知可以携带一个32位变量,同时也可以间接携带大数据结构——指针在32位机中,是4字节32位的,这意味着你可以在任务通知中携带指针,这样可以间接携带大型数据结构。但是这不安全,如果一定要这么做请注意指针所指对象的生命周期!尤其不要传递指向局部数据结构的指针!

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
// 发送方.
uint8_t g_sensor_buffer[32];
// 获取传感器数据...
// 将缓冲区的地址作为通知值发送出去.
xTaskNotify(xConsumerTaskHandle, (uint32_t)g_sensor_buffer, eSetValueWithOverwrite);

// 接收方.
void vConsumerTask(void *pvParameters) {
uint32_t ulReceivedAddr;
while(1) {
xTaskNotifyWait(0, 0, &ulReceivedAddr, portMAX_DELAY);
uint8_t *pData = (uint8_t*)ulReceivedAddr;
// 直接处理该地址的数据.
parse_sensor_data(pData);
}
}

任务通知最大的局限性是:只能实现任务间的点对点通信。不像信号量或者队列,能交互多个任务。并且不像计数信号量或队列,任务通知只能保存一个待处理状态,当通知事件被高频触发时会导致丢事件(新事件覆盖旧事件)!因此对于接收网络包等事件要使用计数信号量或队列,不能够使用任务通知。


关于优先级翻转的一些事,针对优先级翻转 FreeRTOS 怎么进行处理?

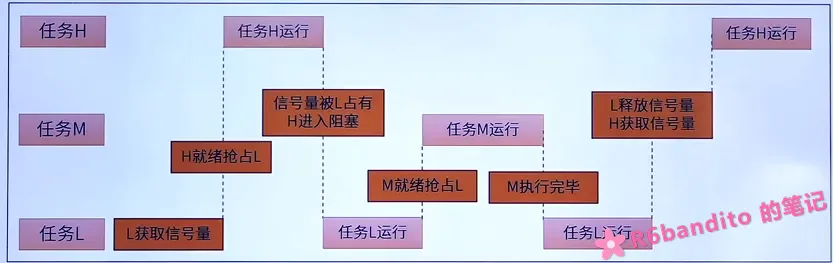
首先我们来看一个实例:有三个任务其优先级分别为: 任务A(H),任务B(M),任务C(L),其中任务A和任务C需要访问一段共同的全局数据区域,因此二者之间需要进行访问保护。

先来看第一种情况,假如我们采用二值信号量来进行一个简单的防护,考虑以下流程:

任务A运行阻塞,任务B也处于阻塞状态,此时任务C独占 CPU 运行 –>

任务C获取到信号量,继续执行逻辑 –>

此时任务A阻塞结束,就绪。由于A为最高优先级,因此立即抢占任务C,任务C被挂回就绪列表等待下一次调度 –>

任务A执行到获取信号量,由于信号量已经提前被C获取,因此任务A发生阻塞,此时再度唤醒任务C执行(前面整个流程种任务B始终阻塞) –>

C重新得到运行,请注意!此时任务B解除阻塞,由于B的优先级比C高,因此立即抢占C –>

我们假设任务B执行了一段长耗时逻辑,记作 t1,完毕后任务B重新进入阻塞 –>

任务C重新得到执行,完毕后释放信号量。任务C执行的整个周期我们记作 t2。–>

任务A获取到信号量,解除阻塞,得到执行。

发现端倪没有?我们原意是:任务A应该等到C执行完后立即执行,也就是任务A被阻塞 t2 后得到响应(这是没办法的事,信号量本身就有阻塞语义,这段等待时间算是数据保护的代价,去不掉的)。但是实际呢?我们高优先级任务A被阻塞了整整 t1 + t2 段时间!原本高优先级任务却被最后一个执行!这还只是一个M任务的情况下,若有多个M任务交替就绪的情况下,我们的任务A会被阻塞多久?这严重影响了我们系统的实时性,是绝对不能容忍的。这就是优先级的翻转。

对于这个问题,FreeRTOS 引入了互斥信号量来解决。互斥信号量比起二值信号量,多了一个优先级继承机制:也就是获取该锁的任务,其优先级会被临时提升到所有阻塞在该互斥量上的最高优先级任务的优先级。在本例中,若使用互斥量进行保护,那么任务C会被临时提升到任务A的优先级,此时任务M就算就绪,由于优先级低于C,无法抢占。待任务C执行完毕后,释放锁,自身回到原优先级,任务A或得锁开始运行。在使用互斥量的情景下,我们的高优先级任务阻塞时间被确定到了 t2,优先级翻转问题得以缓解。

互斥量还有一个特性:互斥量内部会记录当前持有者任务的句柄,互斥量的释放只能由原持有者释放。而二值信号量是可以由任何任务进行释放的。也正是因为这个特性,所以互斥量不允许在 ISR 中使用。因为 ISR 不处于任务上下文,没有“任务”这一概念。

这里再说几点:首先优先级翻转是不能够被根除的,一旦使用信号量,且任务有优先级梯度,就闭然会出现高优先级任务被低优先级阻塞这一情况。只能让获取锁的低优先级任务尽快执行完,不被别的任务打断,进而执行我们高优先级的任务,这就是优先级翻转的常规缓解办法。其次,FreeRTOS 提供的只是一个简易继承机制,不存在链式继承。如果你的任务C同时也在等待另一个信号量,而该信号量被任务D(优先级更低)获取,那么当B就绪时,任务C就又会被优先级翻转!连带连累任务A。当然,这种属于设计问题,在进行布局时应尽可能规避这种使用场景。


xQueueSend 和 xQueueSendFromISR 有什么区别?在使用中断向队列发送数据时,需要注意什么?

首先我们需要明白在 FreeRTOS 中,对于队列以及信号量之类的一些操作给出了两套 API,这两套 API 最大的区别就在于是否被打上了 FromISR 的这个标签。例如:xQueuePeekFromISR(), xQueueReceiveFromISR(), vTaskNotifyGiveFromISR() 等等。

对于非 FromISR 后缀的API,如 xQueueSend ,是用在任务上下文的;而对于带FromISR的 API,如xQueueSendFromISR 是用在中断上下文的。任务类型的 API 绝对不可以用在 ISR 中!FromISR API 虽然可以用在任务中,但是这不是规范做法,请不要混用!下面来简单讲讲两类 API 的区别。

  • 首先是阻塞行为,任务 API 提供阻塞超时机制,可以设置一个阻塞超时时间。当队列满(写操作)或队列空(读操作)时,调用该 API 的任务会进入阻塞态,等待队列腾出空间,直到超时或成功写入;而中断 API 移除了阻塞行为,绝对不能够发生阻塞(RTOS中阻塞会触发任务调度,ISR中进行不了任务调度!)。当操作条件不满足时,将立即返回。

  • 唤醒行为差异(延迟切换):
    在 ISR 中,我们操作队列时多半是以下面的形式进行:

    1
    2
    3
    4
    5
    6
    7
    8
    9
    void UART_IRQHandler(void) {
    uint8_t data;
    // 从硬件寄存器读取数据...
    BaseType_t xHigherPriorityTaskWoken = pdFALSE;
    xQueueSendFromISR(xQueue, &data, &xHigherPriorityTaskWoken);

    // 其他中断处理...
    portYIELD_FROM_ISR(xHigherPriorityTaskWoken);
    }

    发现了吗?我们需要透传 xHigherPriorityTaskWoken 这个变量进入FromISR API,而后将其传入portYIELD_FROM_ISR()。缘何如此?这就要提到 RTOS 内核的切换机制了,这里简单讲讲:队列/信号量等操作是可能随时唤醒一个高优先级任务的,因此在这些操作结束后我们需要触发一次任务切换来检查下当前是否因为刚刚的操作导致有高优先级任务就绪。
    对于任务型API,内部在队列/信号量操作后,会立即检查是否需要执行切换,若需要则立即切换;而 ISR 中不能进行任务切换!因此在操作完成后,需要将切换标志放进 xHigherPriorityTaskWoken 这个变量中进行存储。后续在 ISR 即将退出时,显示调用 portYIELD_FROM_ISR() 来标记一次切换请求(本质就是请求一次PendSV),而后当所有 ISR 全部执行完成后,在中断后半段再进行任务切换(也就是我们说的延迟切换)。

这里只是以 Queue 队列操作举个例子,实际上所有带 FromISR 后缀的 API 与原型 API 的主要差异都是上述两点。xQueueSend 用于任务,支持阻塞和自动调度;xQueueSendFromISR 用于中断,不支持阻塞,要手动触发切换请求。不要用混了!

音乐
0:000:00